








在sql中使用cume_dist函数分析累积分布,核心是计算当前行在分组内的相对位置,公式为(小于当前值的行数 + 等于当前值的行数) / 分组总行数。具体做法是在select子句中调用cume_dist() over (partition by 分组列 order by 数值列),这将返回一个0到1之间的浮点数,表示该数值在组内的累积概率。需要注意的是,如果order by列中存在重复值,这些重复值会获得相同的cume_dist结果,且分母始终是该partition by组的总记录数。

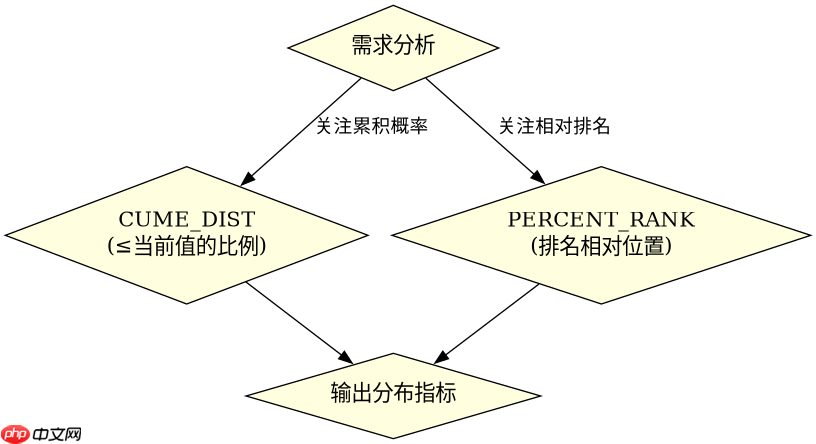
CUME_DIST与PERCENT_RANK的区别是什么
CUME_DIST和PERCENT_RANK都用于分析数据分布,但计算公式不同:CUME_DIST基于累计频数(包括当前值),而PERCENT_RANK基于排名差值。CUME_DIST的结果范围是(0, 1],而PERCENT_RANK的范围是[0, 1]。在实际应用中,如果你想知道“有多少比例的数据小于或等于当前值”,应使用CUME_DIST;如果想看“当前值在排序中的相对位置百分比”,则使用PERCENT_RANK。两者都需要配合OVER子句使用,且都受ORDER BY中重复值的影响。
WITH SalesData AS (
    SELECT 'Electronics' AS Category, 1000 AS Amount UNION ALL
    SELECT 'Electronics', 1500 UNION ALL
    SELECT 'Electronics', 1500 UNION ALL
    SELECT 'Electronics', 2000 UNION ALL
    SELECT 'Clothing', 500 UNION ALL
    SELECT 'Clothing', 800 UNION ALL
    SELECT 'Clothing', 800 UNION ALL
    SELECT 'Clothing', 1200
)
SELECT
    Category,
    Amount,
    CUME_DIST() OVER (PARTITION BY Category ORDER BY Amount) AS CumDist,
    PERCENT_RANK() OVER (PARTITION BY Category ORDER BY Amount) AS PctRank
FROM SalesData;
CUME_DIST如何处理并列排名
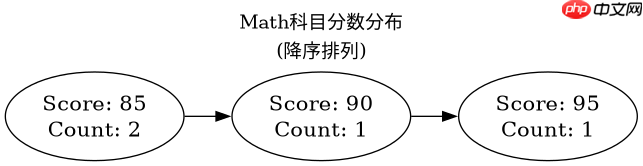
当ORDER BY列中存在相同数值时,CUME_DIST会为这些并列的记录分配完全相同的值。这是因为CUME_DIST的计算逻辑是统计所有小于或等于当前值的记录总数除以组内总记录数。对于并列值,它们都被视为“小于或等于”自身,因此共享同一个累积分布概率。这种处理方式使得CUME_DIST在处理有重复数据的业务场景(如成绩、销售额)时更加直观,因为它反映了“达到或超过该水平的比例”。相比之下,RANK()或DENSE_RANK()虽然也处理并列,但返回的是整数排名,而非概率值。
WITH TestScores AS (
    SELECT 'Math' AS Subject, 85 AS Score UNION ALL
    SELECT 'Math', 90 UNION ALL
    SELECT 'Math', 85 UNION ALL
    SELECT 'Math', 95 UNION ALL
    SELECT 'Science', 70 UNION ALL
    SELECT 'Science', 80 UNION ALL
    SELECT 'Science', 80 UNION ALL
    SELECT 'Science', 90
)
SELECT
    Subject,
    Score,
    RANK() OVER (PARTITION BY Subject ORDER BY Score DESC) AS RankNum,
    DENSE_RANK() OVER (PARTITION BY Subject ORDER BY Score DESC) AS DenseRank,
    CUME_DIST() OVER (PARTITION BY Subject ORDER BY Score DESC) AS CumDist
FROM TestScores;
CUME_DIST在特定输入条件下的返回值是多少
以第一节的Electronics类别为例,当输入金额为1500时,由于存在两个1500的记录,CUME_DIST的计算会将这两个1500以及一个1000都计入“小于或等于”的范畴。Electronics组共有4条记录,小于或等于1500的记录有3条(1000, 1500, 1500),因此CUME_DIST结果为3/4 = 0.75。这意味着在电子产品类别中,有75%的销售金额小于或等于1500。这个结果直接反映了该数值在组内的累积位置,且不受其他类别数据的影响,因为PARTITION BY确保了计算的独立性。


















