








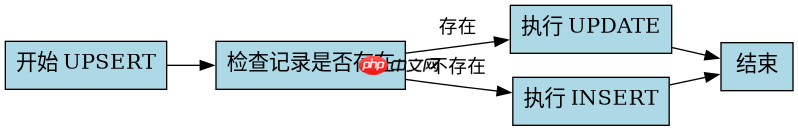
在sql中安全地实现存在则update不存在则insert的标准做法是使用 merge 语句(也称为 upsert)。该操作通过匹配条件判断目标表中是否存在记录,若存在则更新字段,若不存在则插入新行。使用 merge 能确保原子性执行,避免并发环境下的数据竞争问题。
MERGE 语句的基本语法结构是怎样的
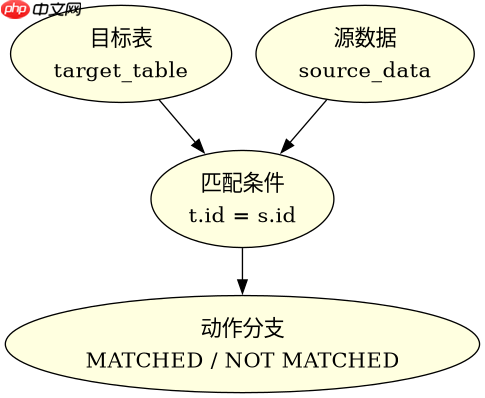
MERGE 语句的核心在于定义源数据与目标表的连接条件。它允许开发者在一个语句中同时处理 INSERT 和 UPDATE 逻辑。基本结构包括指定目标表、关联的源数据、ON 匹配条件以及 THEN 分支的操作指令。
MERGE INTO target_table t
USING source_data s
ON t.id = s.id
WHEN MATCHED THEN
    UPDATE SET t.value = s.value
WHEN NOT MATCHED THEN
    INSERT (id, value) VALUES (s.id, s.value);
上述代码展示了标准的 ANSI SQL 语法。首先指定目标表 target_table,然后通过 USING 子句引入源数据。关键步骤是 ON t.id = s.id,这定义了匹配规则。如果找到匹配项,执行 UPDATE;否则执行 INSERT。这种写法兼容大多数主流数据库如 Oracle、SQL Server 和 DB2。
不同数据库方言中的 UPSERT 实现差异有哪些
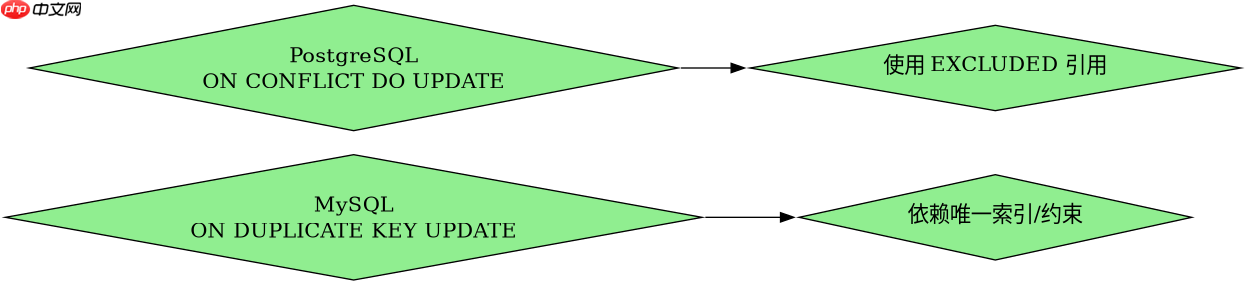
虽然 MERGE 是标准,但 MySQL 和 PostgreSQL 提供了更简洁的替代方案。MySQL 使用 INSERT ... ON DUPLICATE KEY UPDATE,而 PostgreSQL 使用 INSERT ... ON CONFLICT DO UPDATE。这些语法针对特定场景优化,减少了冗余代码。
-- MySQL 示例
INSERT INTO users (id, name)
VALUES (1, 'Alice')
ON DUPLICATE KEY UPDATE name = 'Alice';

-- PostgreSQL 示例
INSERT INTO users (id, name)
VALUES (1, 'Alice')
ON CONFLICT (id) DO UPDATE SET name = EXCLUDED.name;
在 MySQL 中,必须依赖唯一索引或主键来触发冲突检测。如果 id 列没有唯一约束,该语句将始终执行 INSERT。PostgreSQL 的 EXCLUDED 关键字引用了即将插入的值,使得更新逻辑更加直观。选择哪种方式取决于具体的数据库环境和性能需求。
当源数据包含 NULL 值时 UPDATE 行为如何确定
在使用 UPSERT 时,如果源数据中的字段为 NULL,更新操作会将目标表的对应字段设为 NULL。这可能导致意外覆盖原有非空数据。因此,需要在 UPDATE 分支中加入条件判断,仅当源值不为 NULL 时才进行更新。
UPDATE target_table t
SET t.value = COALESCE(s.value, t.value)
WHERE t.id = s.id;
上述代码使用了 COALESCE 函数。如果 s.value 为 NULL,则保留 t.value 的原值。这是一种防御性编程技巧,确保部分更新不会丢失重要信息。在实际应用中,应根据业务逻辑决定是否需要这种保护机制。

















