








接入与使用对象存储 oss 的核心做法是:在控制台创建 bucket 并获取 accesskey,随后在代码中配置凭证并初始化客户端 sdk,即可通过 api 进行文件上传、下载和管理。具体实现时,需设置 endpoint、bucketname 及认证信息,调用 putobject 或 getobject 等方法完成数据交互,确保网络连通且权限策略正确。
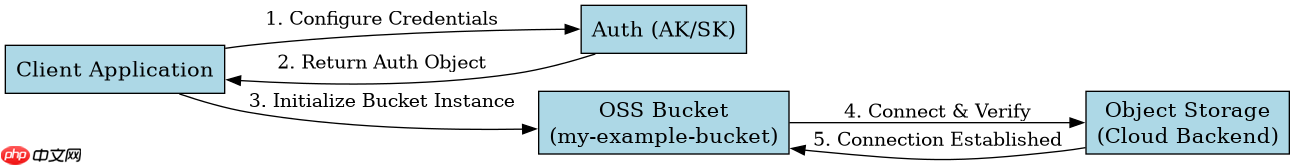
如何初始化 OSS 客户端并完成基础连接
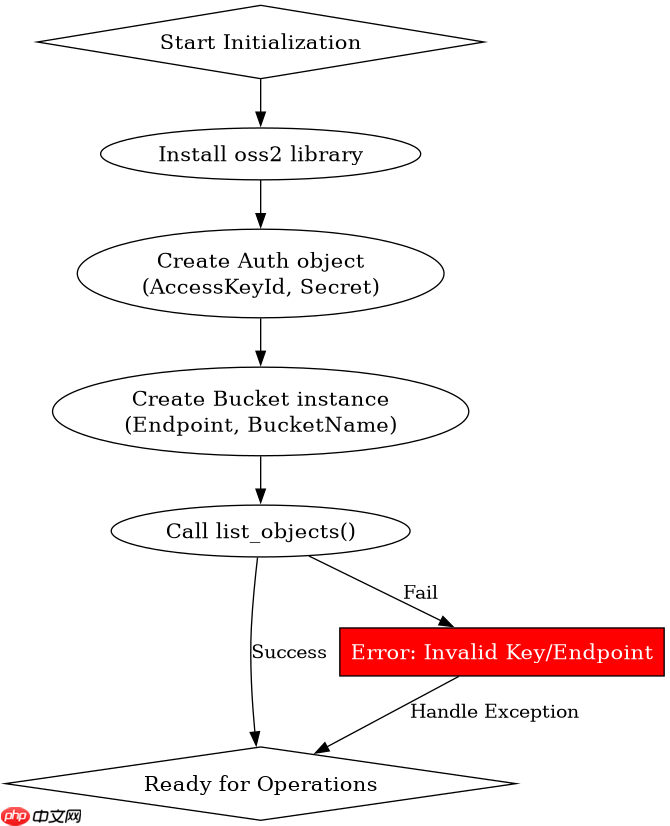
初始化客户端需要指定服务区域(Endpoint)、身份验证密钥(AccessKeyId/Secret)以及目标存储空间名称(BucketName)。以阿里云 OSS Python SDK 为例,安装 oss2 库后,构建 Auth 对象并实例化 Bucket 类即可完成连接准备,后续所有操作均基于该实例发起。
import oss2

# 1. 配置认证信息
auth = oss2.Auth('your-access-key-id', 'your-access-key-secret')

# 2. 指定 Endpoint 和 Bucket 名称
endpoint = 'https://oss-cn-hangzhou.aliyuncs.com'
bucket_name = 'my-example-bucket'

# 3. 创建 Bucket 实例
bucket = oss2.Bucket(auth, endpoint, bucket_name)

# 4. 验证连接(列出前几个文件)
print(bucket.list_objects(max_keys=2).object_list)
运行上述代码将输出 Bucket 中现有的文件列表,若返回空列表或报错,则说明凭证错误或 Bucket 不存在。确保 endpoint 与 Bucket 所在地域一致,否则会出现 EndpointNotFound 异常。
如何实现文件的上传与下载操作
文件传输主要依赖 put_object 和 get_object 方法。上传时需提供本地文件路径或字节流,下载时需指定远程文件名及保存路径。SDK 会自动处理分片和大文件逻辑,开发者只需关注源与目标的映射关系,无需手动管理 HTTP 请求细节。

# 假设已创建 bucket 实例
local_file_path = './data/report.pdf'
remote_key = 'reports/report.pdf'

# 上传文件
with open(local_file_path, 'rb') as f:
    bucket.put_object(remote_key, f.read())
    print(f"Uploaded {local_file_path} to {remote_key}")

# 下载文件
download_path = './downloaded_report.pdf'
bucket.get_object_to_file(remote_key, download_path)
print(f"Downloaded {remote_key} to {download_path}")
执行上传后,文件将以 remote_key 作为唯一标识存储在 Bucket 中。下载时若 remote_key 不存在,SDK 会抛出 NoSuchKey 错误。建议在实际业务中加入异常捕获,如 try...except oss2.exceptions.NoSuchKey,以增强程序健壮性。
当上传大文件时如何处理断点续传
对于超过 100MB 的文件,建议使用分片上传接口 multipart_upload 或开启断点续传功能。OSS SDK 支持自动检测中断并恢复传输,避免重复上传整个文件。通过设置 upload_id 和分片状态,可实现高可靠性的数据传输,特别适用于弱网环境或超大文件场景。
import oss2
from oss2.models import PartInfo

# 初始化分片上传
upload_id = bucket.init_multipart_upload(remote_key).upload_id

parts = []
chunk_size = 10 * 1024 * 1024  # 10MB per part
file_size = os.path.getsize(local_file_path)

with open(local_file_path, 'rb') as f:
    part_number = 1
    while True:
        chunk = f.read(chunk_size)
        if not chunk:
            break
        # 上传分片
        result = bucket.upload_part(remote_key, upload_id, part_number, chunk)
        parts.append(PartInfo(part_number, result.etag))
        part_number += 1

# 完成上传
bucket.complete_multipart_upload(remote_key, upload_id, parts)
print("Large file uploaded successfully with multipart upload.")
该流程将文件切分为多个部分分别上传,最后合并。若中途失败,可记录 upload_id 和已完成分片,下次启动时继续上传剩余部分。此机制显著提升了大文件传输的成功率和效率。


















