








volatile 读操作插入什么内存屏障?
volatile 读操作在底层会插入 loadload 和 storeload 两种内存屏障。具体做法是:jvm 编译器在生成字节码时,会在读取 volatile 变量之前插入 loadload 屏障,确保该读操作不会被重排序到后续所有读操作之后;在该读操作之后插入 storeload 屏障,确保该读操作不会被重排序到后续的写操作之后。
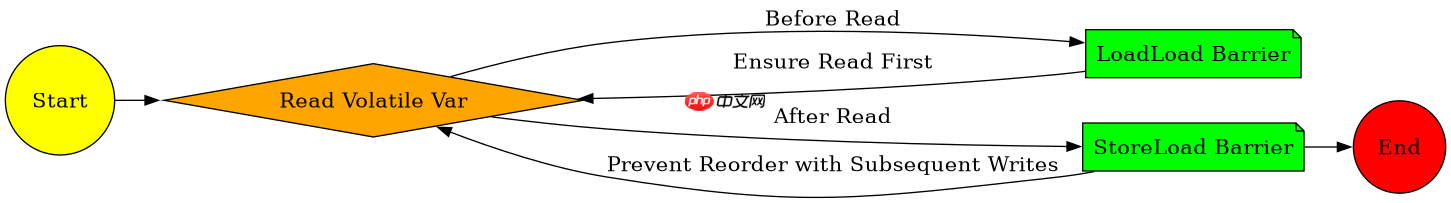
这种屏障组合的核心目的是保证可见性和有序性。当线程 A 写入一个 volatile 变量后,线程 B 读取该变量时,LoadLoad 屏障防止了 B 线程先读到其他变量的旧值而漏掉新值,StoreLoad 屏障则切断了 B 线程当前读操作与后续写操作的依赖,防止因指令重排导致逻辑错误。
public class VolatileReadBarrierDemo {
    private volatile int value = 0;

    public void readValue() {
        // 这里会发生 LoadLoad 和 StoreLoad 屏障
        int localVal = value;
        System.out.println(localVal);
    }
}
运行上述代码时,虽然输出结果取决于写入时机,但关键在于 localVal 的值一定是最新的。如果去掉 volatile,编译器可能会将 value 的读取优化为寄存器缓存,导致永远读到初始值 0。
为什么 volatile 读需要 StoreLoad 屏障而不是 StoreStore?
volatile 读操作必须使用 StoreLoad 屏障,因为它的核心任务是“禁止本读操作与后续写操作重排序”。如果使用 StoreStore 屏障,它只能保证前面的写操作不被重排序到后面,无法约束当前读操作之后的行为,这会导致程序逻辑混乱。
立即学习“Java免费学习笔记(深入)”;

在代码库出现结构漂移之前,扫描JS或TS代码库中的禁止导入、循环依赖、孤立模块和其他依赖规则违规情况。
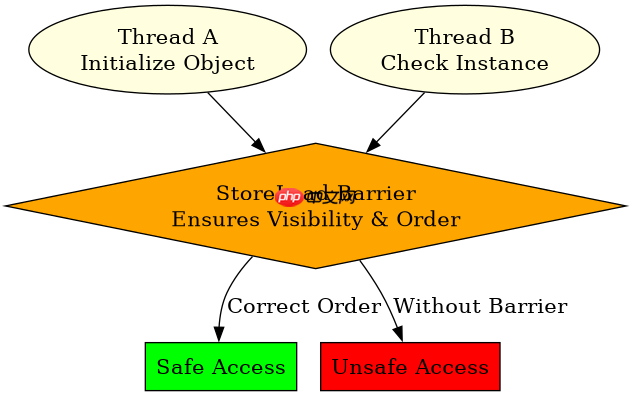
以单例模式的双重检查锁定(DCL)为例,如果读操作没有 StoreLoad 屏障,可能会出现以下危险场景:线程 A 正在初始化对象,此时 instance 引用已经指向了对象内存地址,但对象尚未完全初始化完成。线程 B 进入 if (instance == null) 判断,由于 volatile 读的 StoreLoad 屏障确保了 B 线程能看到 A 线程之前的写操作(即对象构造),但如果缺少对后续写操作的隔离,B 线程可能在看到非空引用后,立即执行自己的写操作,而这些写操作可能依赖于未完全初始化的对象状态,从而引发错误。
public class Singleton {
    private static volatile Singleton instance;

    public static Singleton getInstance() {
        if (instance == null) { // volatile 读,含 LoadLoad + StoreLoad
            synchronized (Singleton.class) {
                if (instance == null) {
                    instance = new Singleton();
                }
            }
        }
        return instance;
    }
}
在这个例子中,第一次读 instance 时,StoreLoad 屏障确保了即使后续有写操作(虽然在 DCL 中主要是读,但在复杂并发场景中),也不会被重排序到该读之前。更重要的是,它保证了 instance 的读操作与之前所有写操作的顺序关系,以及之后所有写操作的顺序关系。
如果 volatile 读操作后紧跟一个普通写操作,会发生什么?
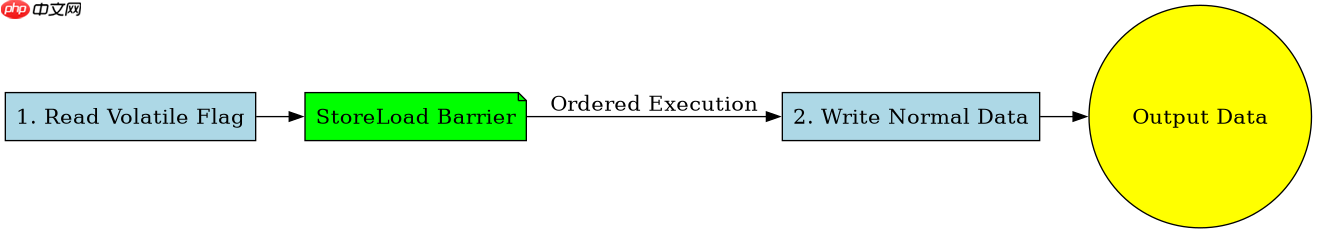
如果 volatile 读操作后紧跟一个普通写操作,StoreLoad 屏障会强制将该读操作与该写操作进行排序,确保读操作先于写操作执行。这意味着,普通写操作的结果不会“提前”到 volatile 读操作之前被其他线程看到,同时也确保了 volatile 读到的最新值在当前线程的上下文中是有效的。
public class ReadThenWrite {
    private volatile int flag = 0;
    private int data = 0;

    public void process() {
        int val = flag;      // volatile 读,插入 LoadLoad, StoreLoad
        data = val * 2;      // 普通写,受 StoreLoad 屏障影响
        System.out.println(data);
    }
}在上述代码中,data = val * 2 是一个普通写操作。由于 flag 是 volatile,其读操作后的 StoreLoad 屏障确保了 val 的读取发生在 data 的写入之前。如果没有这个屏障,编译器或处理器可能会将 data 的写入重排序到 flag 的读取之前,导致 data 使用了旧的 flag 值甚至未定义的值。通过 StoreLoad 屏障,我们保证了数据依赖的正确性。



















