








通过 promise.allsettled 并行发起请求,并在结果返回后根据业务逻辑对数据进行处理和排序,即可实现接口请求结果的优先级策略。具体做法是定义一个包含不同优先级权重的任务列表,使用 promise.allsettled 等待所有异步操作完成,随后遍历结果数组,优先提取高优先级任务的 fulfilled 状态数据,若高优先级失败则降级使用低优先级数据,最终输出合并后的结果。

如何定义并执行多优先级并行请求
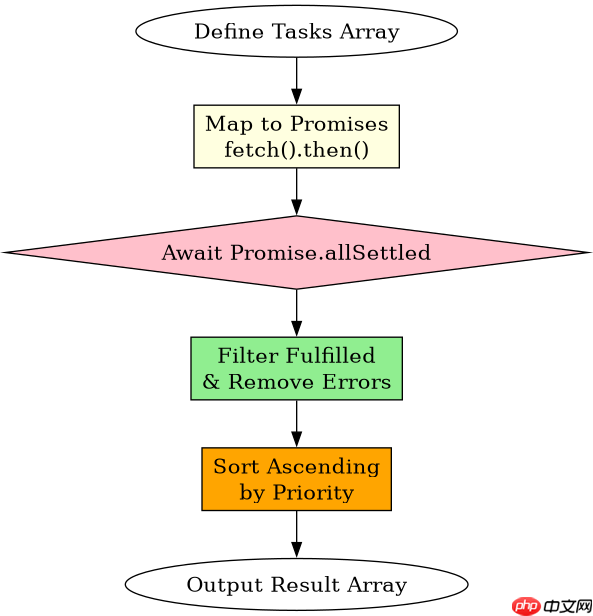
要实现优先级策略,首先需要将不同的接口调用封装为独立的 Promise 对象,并为每个任务分配一个明确的优先级标识。在执行阶段,不再使用简单的串行调用,而是将所有 Promise 放入一个数组中,利用 Promise.allSettled 方法统一处理。这种方法的优势在于它不会像 Promise.all 那样在任何一个请求失败时立即中断,而是会等待所有请求结束,无论成功或失败,从而确保我们能拿到所有可用的数据源进行后续筛选。
const fetchWithPriority = async () => {
  // 定义带有优先级的请求任务
  const tasks = [
    { priority: 1, name: 'primary', url: '/api/primary' },
    { priority: 2, name: 'secondary', url: '/api/secondary' }
  ];

  // 并行发起所有请求
  const promises = tasks.map(task =>
    fetch(task.url).then(res => res.json()).then(data => ({ ...task, data }))
  );

  // 等待所有结果
  const results = await Promise.allSettled(promises);

  // 过滤出成功的结果并按优先级排序
  const successResults = results
    .filter(r => r.status === 'fulfilled')
    .map(r => r.value)
    .sort((a, b) => a.priority - b.priority);

  return successResults;
};
上述代码展示了核心执行流程。首先构建任务数组,每个对象包含优先级数字、名称和 URL。接着通过 map 方法生成 Promise 数组并立即启动网络请求。关键步骤在于 await Promise.allSettled(promises),这行代码阻塞直到所有 fetch 操作完成。最后,通过 filter 排除 rejected 状态的请求,再利用 sort 方法按 priority 字段升序排列,确保高优先级(数值小)的数据排在前面。运行该程序将得到一个按优先级排序的成功响应数组。
立即学习“Java免费学习笔记(深入)”;

FilePond 是一个 JavaScript 文件上传库,支持通过拖拽、粘贴和 API 方式处理文件、目录、URL 和 Data URI。它包含内置的图像优化功能、异步分块上传功能,并提供了适用于 React、Vue、Angular 和 Svelte 的适配器。
如何在结果中实施降级与覆盖逻辑
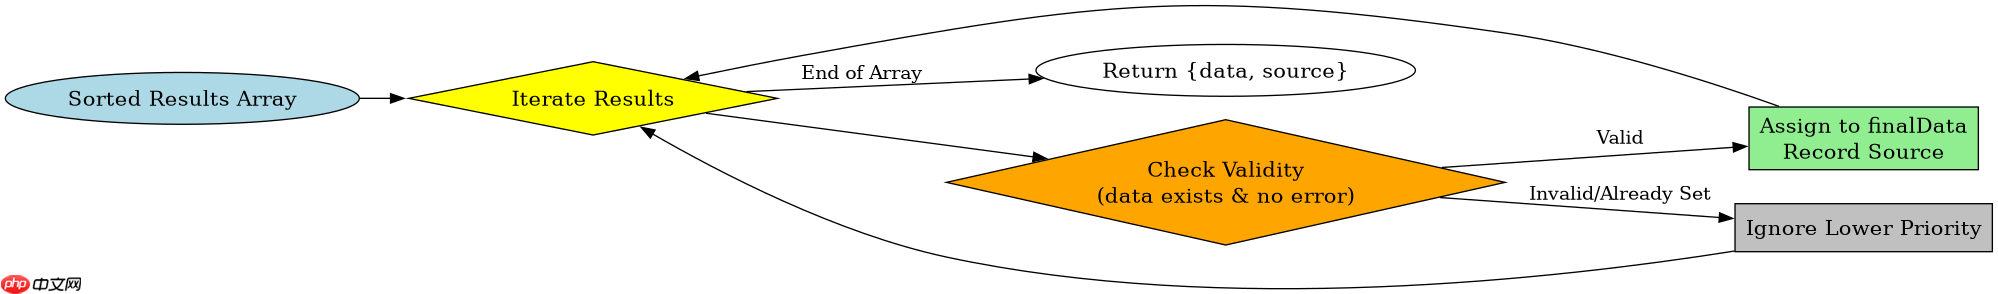
拿到排序后的结果集后,下一步是根据业务需求决定最终展示或使用的数据。通常的策略是“高优优先,低优兜底”。这意味着如果高优先级接口返回了有效数据,就忽略低优先级接口的数据;只有当高优先级接口失败或返回空值时,才启用低优先级接口作为备用。这种逻辑可以通过遍历排序后的结果集并设置标志位来实现,一旦找到第一个有效的数据源,即可停止查找或标记后续数据为无效。
const applyPriorityStrategy = (results) => {
  let finalData = null;
  let usedSource = 'none';

  for (const result of results) {
    // 检查数据是否有效(非空且存在关键字段)
    if (result.data && result.data.id) {
      if (!finalData) {
        finalData = result.data;
        usedSource = result.name;
      } else {
        // 如果已有高优数据,可选择覆盖或保留,此处演示保留高优
        console.log(`Ignored lower priority source: ${result.name}`);
      }
    }
  }

  return { data: finalData, source: usedSource };
};

// 假设 results 是上一节获取的排序后数组
const output = applyPriorityStrategy(results);
console.log(output);
这段代码实现了具体的降级逻辑。它接收上一节生成的已排序结果数组。通过 for...of 循环逐个检查每个任务的数据有效性。这里设定了一个简单的有效性判断:数据对象存在且包含 id 字段。一旦找到第一个满足条件的数据,将其赋值给 finalData 并记录来源 usedSource。由于数组已经按优先级排序,先遇到的必然是高优先级数据。如果后续还有低优先级数据也有效,代码中的注释部分展示了如何处理冲突,例如打印日志忽略低优数据。最终返回包含数据和来源标识的对象。这种模式确保了系统始终优先使用最可靠或最新的高优先级数据,同时在主数据源失效时能自动切换至备用源。
当高优先级接口超时但低优先级正常时策略如何生效
在实际网络环境中,超时是常见现象。如果高优先级接口因网络波动导致超时(Promise 被 reject 或长时间 pending),而低优先级接口响应迅速,优先级策略需要能够识别这种状态并正确回退。在 Promise.allSettled 的语境下,超时的请求通常会以 rejected 状态返回,或者如果未设置超时控制,可能会一直 pending 导致整体阻塞。因此,必须在请求层面加入超时机制,确保 rejected 状态能被及时捕获,从而使降级逻辑得以触发。
const timeoutFetch = (url, ms = 5000) => {
  const controller = new AbortController();
  const id = setTimeout(() => controller.abort(), ms);
  return fetch(url, { signal: controller.signal })
    .finally(() => clearTimeout(id));
};

const runWithTimeout = async () => {
  const tasks = [
    { priority: 1, name: 'fast_primary', url: '/api/slow_primary' },
    { priority: 2, name: 'quick_secondary', url: '/api/fast_secondary' }
  ];

  const promises = tasks.map(task =>
    timeoutFetch(task.url, 2000).then(res => res.json()).then(data => ({ ...task, data })).catch(err => ({ ...task, error: err.message }))
  );

  const results = await Promise.allSettled(promises);
  const validResults = results
    .filter(r => r.status === 'fulfilled' && !r.value.error)
    .sort((a, b) => a.value.priority - b.value.priority);

  // 此时 primary 可能因超时进入 catch 变为 fulfilled 但含 error
  // 或者如果 abort 导致 rejection,则 status 为 rejected
  // 无论哪种,filter 都会排除它,从而选中 secondary
  return validResults[0]?.value || null;
};
此示例引入了 AbortController 来处理超时。timeoutFetch 函数在指定毫秒数后调用 abort,这会使得对应的 fetch Promise 被 reject。在 main 逻辑中,我们在链式调用中加入了 .catch,将错误转换为包含 error 字段的 fulfilled 对象,这样 Promise.allSettled 就能统一处理所有结果而不抛出未捕获异常。在后续的 filter 阶段,我们排除了包含 error 字段的结果。如果高优先级接口超时,它将带有 error 标记或被直接视为 rejected(取决于 catch 的位置),从而被过滤掉。此时,低优先级接口如果成功,将成为 validResults 中的唯一元素或首个元素,策略自然生效,返回低优先级数据。这验证了策略在网络异常条件下的鲁棒性。


















