








java 中实现大文件流式处理的核心做法是避免将文件整体加载到内存,而是通过 inputstream 或 reader 配合缓冲机制(如 bufferedinputstream)按块读取数据。具体而言,应使用 try-with-resources 语法自动管理资源,并在循环中调用 read() 方法直到返回 -1,每次处理完一个缓冲区的数据后立即释放引用,从而确保内存占用恒定且与文件大小无关。
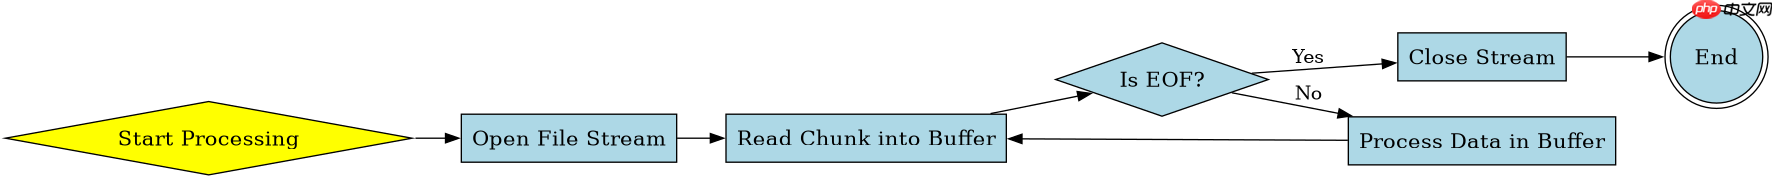
字节流如何逐块读取二进制大文件
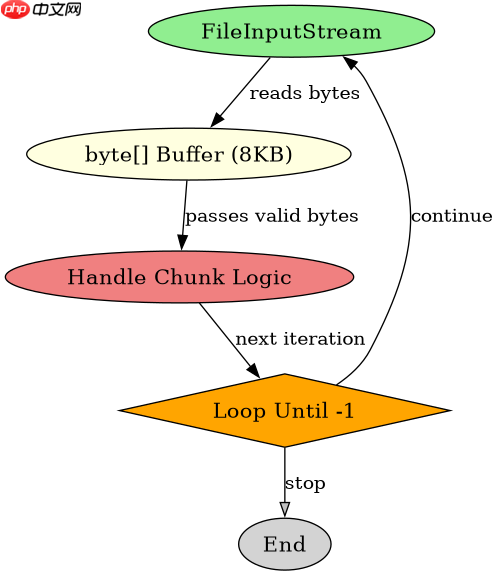
对于非文本的大文件(如图片、视频或自定义二进制格式),直接使用 FileInputStream 结合 byte[] 缓冲区进行流式读取是最基础且高效的方式。关键在于定义一个固定大小的数组(例如 8KB 或 64KB)作为临时存储桶,在 while 循环中不断填充该数组并处理其中的有效数据,这样即使处理 TB 级文件也不会导致 OutOfMemoryError。
import java.io.FileInputStream;
import java.io.IOException;

public class BinaryStreamProcessor {
    public static void processLargeBinaryFile(String filePath) throws IOException {
        // 使用 try-with-resources 确保流关闭
        try (FileInputStream fis = new FileInputStream(filePath)) {
            byte[] buffer = new byte[8192]; // 8KB 缓冲区
            int bytesRead;
            // 循环读取直到文件末尾
            while ((bytesRead = fis.read(buffer)) != -1) {
                // 处理 buffer 中前 bytesRead 个字节
                handleChunk(buffer, bytesRead);
            }
        }
    }

    private static void handleChunk(byte[] data, int length) {
        // 模拟业务逻辑:打印每块的大小
        System.out.println("Processing chunk of size: " + length);
    }
}
上述代码的预期输出取决于文件内容,但核心行为是控制台会持续打印 “Processing chunk of size: ...” 直到文件结束。这里的关键点是 fis.read(buffer) 的返回值 bytesRead 可能小于缓冲区长度(特别是在读取最后一个块时),因此必须只处理 data 数组中从索引 0 到 bytesRead 的部分,否则可能会处理到上一次残留的垃圾数据。
立即学习“Java免费学习笔记(深入)”;

FilePond 是一个 JavaScript 文件上传库,支持通过拖拽、粘贴和 API 方式处理文件、目录、URL 和 Data URI。它包含内置的图像优化功能、异步分块上传功能,并提供了适用于 React、Vue、Angular 和 Svelte 的适配器。
字符流如何高效处理超大文本文件
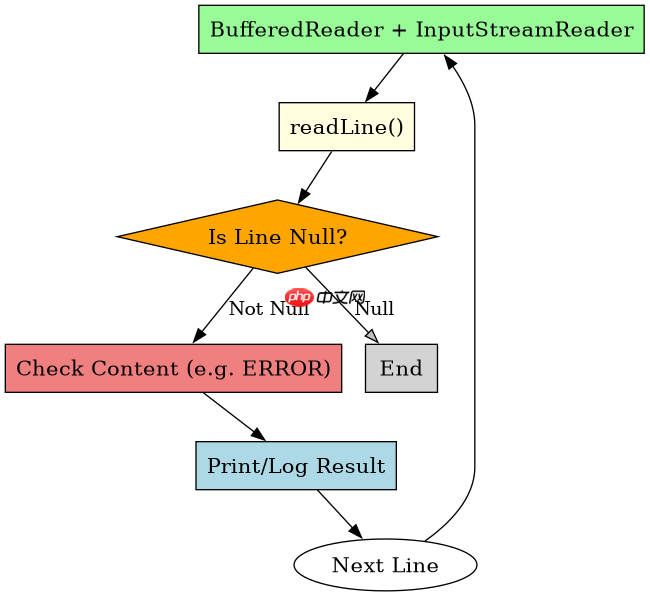
当处理 UTF-8 或 GBK 编码的大文本文件时,直接使用 FileReader 效率较低,推荐组合使用 FileInputStream、InputStreamReader 和 BufferedReader。BufferedReader 内部维护了一个字符缓冲区,它会自动处理多字节字符的边界问题,并通过 readLine() 方法按行流式读取,非常适合日志分析或 CSV 解析等场景。
import java.io.BufferedReader;
import java.io.FileInputStream;
import java.io.IOException;
import java.io.InputStreamReader;
import java.nio.charset.StandardCharsets;

public class TextStreamProcessor {
    public static void processLargeTextFile(String filePath) throws IOException {
        // 指定编码为 UTF-8,防止中文乱码
        try (BufferedReader br = new BufferedReader(
                new InputStreamReader(new FileInputStream(filePath), StandardCharsets.UTF_8))) {
            String line;
            // readLine() 返回 null 表示文件结束
            while ((line = br.readLine()) != null) {
                // 处理每一行数据
                processLine(line);
            }
        }
    }

    private static void processLine(String line) {
        // 示例:仅打印包含特定关键字的行
        if (line.contains("ERROR")) {
            System.out.println("Found error: " + line);
        }
    }
}
该程序的预期结果是仅输出包含 “ERROR” 字符串的行。与字节流不同,BufferedReader 的 readLine() 方法会自动识别换行符(\n 或 \r\n)并剥离它们,返回纯文本行。这种处理方式极大地简化了文本解析逻辑,同时保持了低内存占用的特性。需要注意的是,如果某一行文本异常巨大(超过 JVM 堆内存限制),readLine() 仍可能导致内存溢出,此时需回退到基于字符数组的底层读取方式。
如何处理读取过程中遇到的空指针或无效输入
在流式处理大文件时,程序健壮性至关重要。若输入路径指向的文件不存在或为空,FileInputStream 会抛出 FileNotFoundException,而 BufferedReader 在空文件上调用 readLine() 会直接返回 null,不会抛出异常。开发者需在代码中显式检查这些边界条件,避免因未处理的异常或空值导致流程中断。此外,若在多线程环境下共享流对象,必须引入同步机制或使用线程安全的替代方案,因为标准流类并非线程安全。



















