








Java NIO 中 allocate() 分配缓冲区
使用 bytebuffer.allocate(int capacity) 方法可以创建一个指定大小的直接内存或堆内存缓冲区。该方法会立即在 java 堆上分配一块连续的字节数组,并返回一个初始位置(position)为 0、限制(limit)和容量(capacity)均为指定值的 bytebuffer 对象。

调用 allocate() 时,必须传入一个非负的整数作为容量参数。如果传入负数,方法会抛出 IllegalArgumentException。由于是堆内分配,其底层实现是一个 byte[] 数组,因此受 JVM 堆内存大小的限制。对于需要频繁进行网络 I/O 且对性能敏感的场景,通常建议使用 allocateDirect() 来分配直接内存,但 allocate() 因其创建速度快且易于管理,仍是大多数常规应用的首选。
以下代码展示了如何分配一个 1024 字节的缓冲区,并检查其初始状态:
import java.nio.ByteBuffer;

public class BufferDemo {
    public static void main(String[] args) {
        // 分配一个容量为 1024 的堆内存缓冲区
        ByteBuffer buffer = ByteBuffer.allocate(1024);

        // 验证初始状态
        System.out.println("Capacity: " + buffer.capacity()); // 输出: 1024
        System.out.println("Position: " + buffer.position()); // 输出: 0
        System.out.println("Limit: " + buffer.limit());       // 输出: 1024
        System.out.println("Is Direct: " + buffer.isDirect()); // 输出: false
    }
}
运行上述代码后,预期结果如下:
- capacity() 返回 1024
- position() 返回 0
- limit() 返回 1024
- isDirect() 返回 false
这些值确认了缓冲区已正确初始化,准备接收数据写入。
allocate() 与 allocateDirect() 的区别
allocate() 和 allocateDirect() 的主要区别在于内存的位置和管理方式。allocate() 分配的是堆内存(Heap Memory),而 allocateDirect() 分配的是直接内存(Direct Memory),后者位于 JVM 堆外。
立即学习“Java免费学习笔记(深入)”;

FilePond 是一个 JavaScript 文件上传库,支持通过拖拽、粘贴和 API 方式处理文件、目录、URL 和 Data URI。它包含内置的图像优化功能、异步分块上传功能,并提供了适用于 React、Vue、Angular 和 Svelte 的适配器。
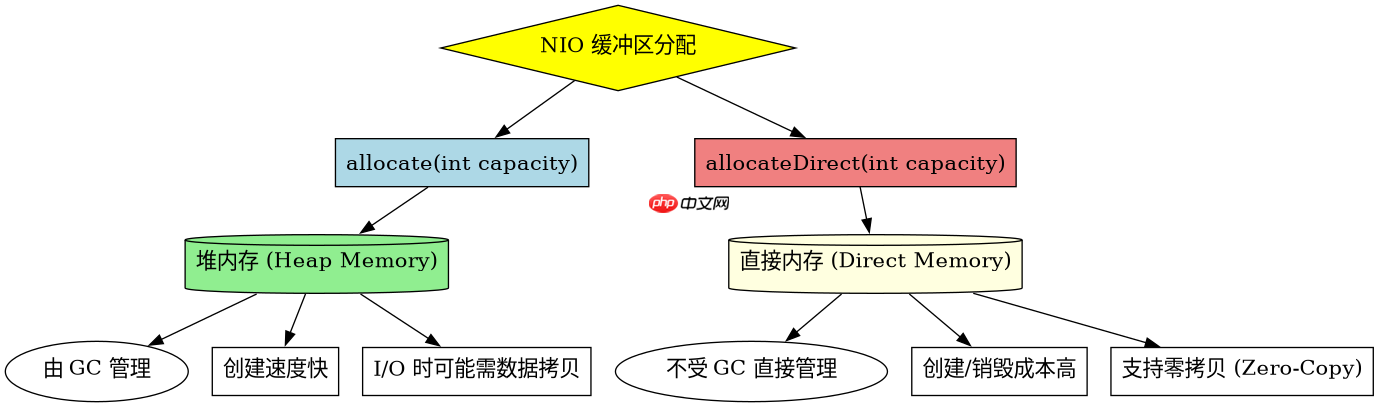
堆内缓冲区由 JVM 垃圾回收器(GC)自动管理,创建速度快,但在使用 SocketChannel 等通道进行读写时,可能需要额外的数据拷贝操作(从堆内缓冲区到内核缓冲区)。直接内存则避免了这种拷贝,适合大文件或高频网络传输,但其创建和销毁成本较高,且不受 GC 直接管理,需要通过 DirectByteBuffer 的清理机制或 Unsafe API 手动释放。
以下代码对比了两种分配方式的实际行为:
import java.nio.ByteBuffer;

public class CompareAllocation {
    public static void main(String[] args) {
        // 堆内分配
        ByteBuffer heapBuffer = ByteBuffer.allocate(1024);
        System.out.println("Heap Buffer - Is Direct: " + heapBuffer.isDirect());

        // 直接内存分配
        ByteBuffer directBuffer = ByteBuffer.allocateDirect(1024);
        System.out.println("Direct Buffer - Is Direct: " + directBuffer.isDirect());
    }
}
运行结果:
- 堆内缓冲区的 isDirect() 为 false
- 直接内存缓冲区的 isDirect() 为 true
这表明两者在内存布局上存在本质差异,开发者应根据应用场景选择合适的分配方式。
基于 allocate() 的输入条件与结果分析
当使用 allocate() 分配缓冲区时,输入的容量参数决定了缓冲区的大小,而该大小直接影响后续的数据读写操作。如果尝试写入超过容量的数据,将触发 BufferOverflowException;如果尝试读取超出当前 limit 的数据,将触发 BufferUnderflowException。
以下代码演示了容量限制对读写操作的影响:
import java.nio.ByteBuffer;

public class BufferLimits {
    public static void main(String[] args) {
        ByteBuffer buffer = ByteBuffer.allocate(5); // 容量为 5

        try {
            // 写入 6 个字节,超过容量
            for (int i = 0; i < 6; i++) {
                buffer.put((byte) i);
            }
        } catch (Exception e) {
            System.out.println("Write Exception: " + e.getClass().getSimpleName());
        }

        // 重置位置以便读取
        buffer.flip();

        try {
            // 读取 6 个字节,但 limit 为 5
            while (buffer.hasRemaining()) {
                System.out.print(buffer.get() + " ");
            }
        } catch (Exception e) {
            System.out.println("\nRead Exception: " + e.getClass().getSimpleName());
        }
    }
}
运行结果:
- 写入阶段抛出 BufferOverflowException
- 读取阶段成功读取前 5 个字节(0, 1, 2, 3, 4),因为 position 被 flip 设置为 0,limit 仍为 5
这说明了 allocate() 分配的缓冲区具有严格的容量边界,任何越界操作都会导致异常,开发者必须在编码时确保数据量不超过缓冲区容量。

















