








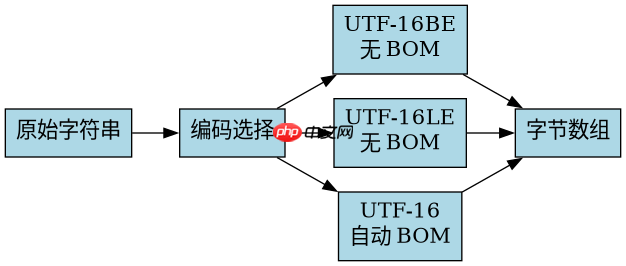
java 中处理 utf-16 字节序的核心是明确区分编码时的字节序标记(bom)和存储时的字节序,通常通过 charset 或 standardcharsets 配合 byteorder 来实现。若需强制指定大端或小端,应使用 charset.forname("utf-16be") 或 utf-16le;若需自动检测并处理 bom,则使用标准的 utf-16 编码,它会在读写时自动插入或识别前缀。对于底层字节流操作,可结合 bytebuffer 的 order() 方法或直接手动处理 bom 字节序列。
如何强制指定 UTF-16 的大端或小端编码
当不需要 BOM 且希望固定字节序时,直接使用 UTF-16BE 或 UTF-16LE 字符集即可。这能避免 BOM 带来的额外开销或解析歧义,适用于已知目标系统字节序的场景。
import java.nio.charset.Charset;
import java.nio.charset.StandardCharsets;

public class Utf16Fixed {
    public static void main(String[] args) throws Exception {
        String text = "Hello";
        // 强制大端编码
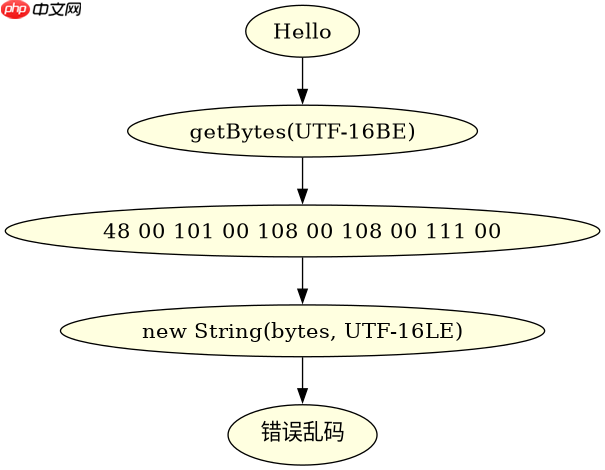
        byte[] beBytes = text.getBytes(Charset.forName("UTF-16BE"));
        System.out.println("BE bytes: " + java.util.Arrays.toString(beBytes));

        // 强制小端解码
        String decoded = new String(beBytes, Charset.forName("UTF-16LE"));
        System.out.println("Decoded: " + decoded);
    }
}
如何处理带 BOM 的 UTF-16 数据
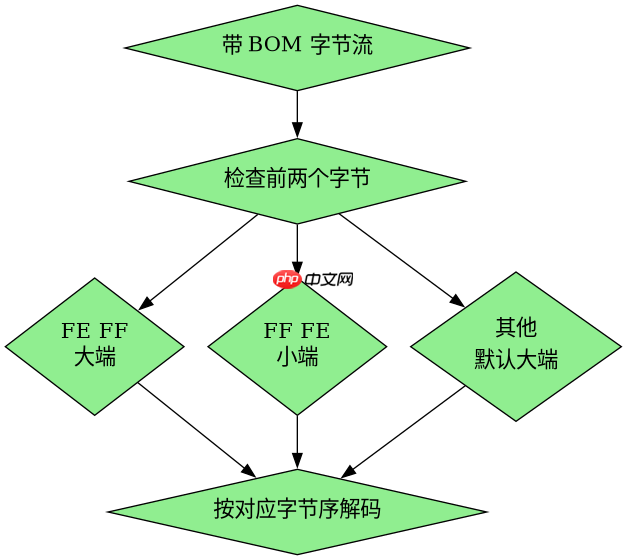
标准 UTF-16 编码会自动在输出流头部添加 BOM(FE FF 表示大端,FF FE 表示小端),并在输入时根据 BOM 确定字节序。这是处理未知来源 UTF-16 数据的推荐方式,确保跨平台兼容性。

FilePond 灵活的 JavaScript 文件上传库
下载
FilePond 是一个 JavaScript 文件上传库,支持通过拖拽、粘贴和 API 方式处理文件、目录、URL 和 Data URI。它包含内置的图像优化功能、异步分块上传功能,并提供了适用于 React、Vue、Angular 和 Svelte 的适配器。
立即学习“Java免费学习笔记(深入)”;
import java.nio.charset.StandardCharsets;

public class Utf16WithBom {
    public static void main(String[] args) throws Exception {
        String text = "Test";
        // 自动添加 BOM
        byte[] bomBytes = text.getBytes(StandardCharsets.UTF_16);
        System.out.println("BOM bytes: " + java.util.Arrays.toString(bomBytes));

        // 自动检测 BOM 解码
        String decoded = new String(bomBytes, StandardCharsets.UTF_16);
        System.out.println("Decoded: " + decoded);
    }
}
UTF-16 编码中 BOM 的具体字节值是什么
在大端模式下,BOM 为 0xFE 0xFF;在小端模式下,BOM 为 0xFF 0xFE。这些字节位于字符串编码后的最前端,用于标识后续数据的字节序。若手动处理字节数组,需检查前两个字节以判断是否包含 BOM。
















