在sql中利用corr聚合函数分析指标相关性,核心做法是直接在select语句中使用该函数并传入两个数值列作为参数。例如,调用`corr(sales, profit)`即可计算销售与利润之间的皮尔逊相关系数。如果数据中存在空值(null),该函数会自动忽略这些行以确保计算的准确性。通过这种方式,开发者可以快速量化两个业务指标之间的线性关系强度和方向。
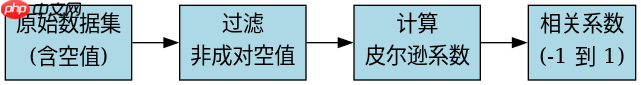
CORR函数如何处理空值输入
CORR函数在遇到空值时会自动将其排除在计算之外,不会导致整个结果返回NULL。这意味着只要两列中有成对的有效数值,函数就能正常计算出相关系数。这种设计使得在处理不完整日志或传感器数据时非常实用,无需预先进行复杂的数据清洗步骤。
SELECT
    CORR(price, quantity) AS price_quantity_corr,
    COUNT(*) AS total_rows,
    COUNT(price) AS non_null_price,
    COUNT(quantity) AS non_null_qty
FROM
    sales_data;
上述查询展示了如何同时统计总行数和非空行数,以验证数据质量。预期结果是`price_quantity_corr`返回一个介于-1到1之间的浮点数,而计数字段则显示实际参与计算的样本量。如果某一列全为空,相关系数将返回NULL。
如何结合分组分析不同类别的相关性
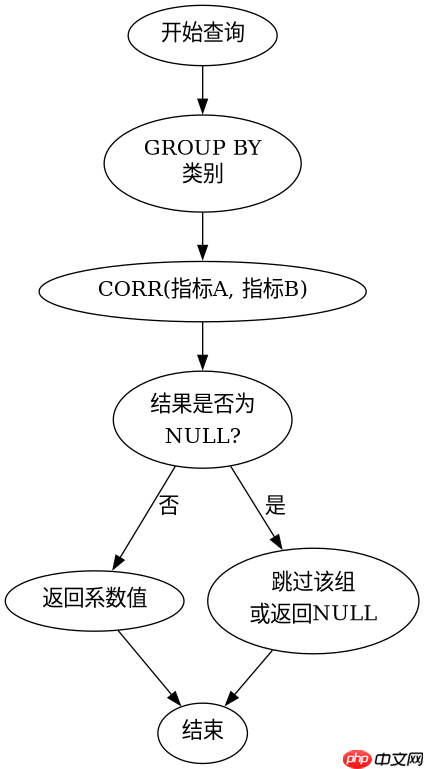
要分析不同类别下的指标相关性,只需在查询中加入GROUP BY子句。这样可以将数据按类别拆分,分别计算每个组内的相关系数。这种方法适用于比较不同产品线、地区或用户群体的行为差异。确保参与计算的数值列在组内有足够的变化量,否则可能因方差为零而无法计算。
SELECT
    category,
    CORR(ad_spend, revenue) AS ad_revenue_corr
FROM
    marketing_metrics
GROUP BY
    category;
这段代码按`category`分组计算广告投入与收入的相关性。预期输出包含多行,每行代表一个类别及其对应的相关系数。若某类别下数据点不足或方差为零,该行的相关系数将为NULL。开发者应检查分组后的数据分布,确保统计结果的可靠性。
当相关系数接近零时意味着什么
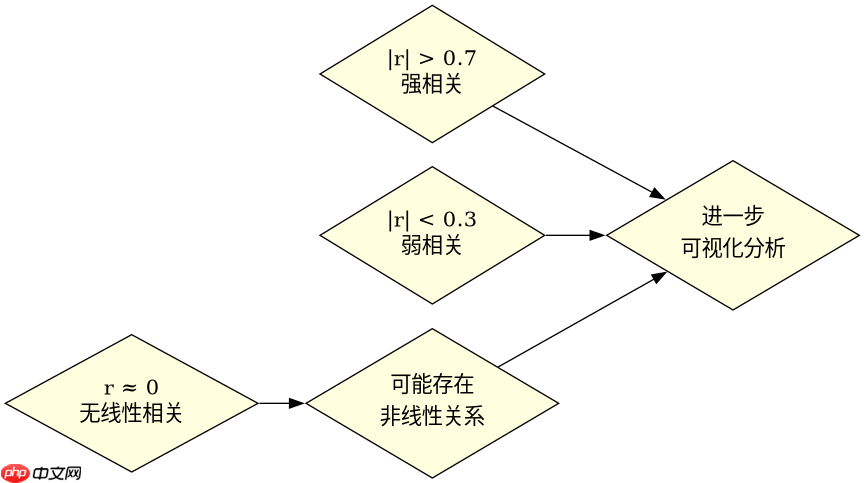
当CORR函数返回的结果接近0时,表明两个指标之间不存在显著的线性相关性。这并不意味着两者完全无关,只是说明无法用一条直线来描述它们的关系。可能存在非线性关系,或者数据噪声过大掩盖了潜在联系。此时建议结合散点图或其他非线性分析方法进一步探索。