使用窗口聚合函数替代自连接的核心做法是:利用 lag() 或 lead() 获取相邻行数据,配合 case when 进行逻辑判断,从而消除对同一表的二次扫描。具体实现时,在 over (partition by ... order by ...) 子句中定义数据分组与排序规则,直接生成包含关联信息的宽表,避免传统自连接产生的笛卡尔积风险与高昂的内存开销。

LAG() 如何获取上一行状态以替代自连接?
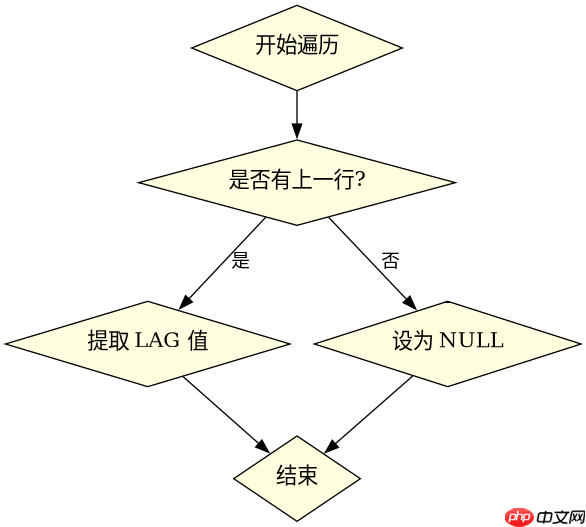
通过 LAG(column, offset) 函数可以直接访问当前行之前的指定行数数据,无需编写 JOIN 条件。例如,在计算连续登录天数时,只需按用户ID分区并按时间排序,提取前一行的日期字段即可。
SELECT
    user_id,
    login_date,
    LAG(login_date) OVER (
        PARTITION BY user_id
        ORDER BY login_date ASC
    ) AS prev_login_date
FROM user_logins;
上述查询针对 user_logins 表执行,返回结果包含 user_id、login_date 以及新列 prev_login_date。若某行为该用户首次登录,则 prev_login_date 为 NULL。此方法将原本需要自连接匹配 t1.user_id = t2.user_id AND t1.date = t2.date + 1 的逻辑简化为单表扫描。
窗口函数如何处理边界情况并优化性能?
窗口函数在处理首尾边界时表现稳定,不会像自连接那样因缺少匹配项而丢失记录。同时,由于避免了多表关联操作,数据库优化器可以更高效地利用索引进行排序和分区,显著降低 CPU 和 I/O 消耗。

SELECT
    order_id,
    amount,
    SUM(amount) OVER (
        PARTITION BY customer_id
        ORDER BY order_date
        ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW
    ) AS running_total
FROM orders;
该代码计算每个客户随订单累积的金额总和。输入为 orders 表,输出包含累计值 running_total。当 customer_id 变化时,窗口重置,确保累计逻辑正确。相比自连接计算历史总和,此写法更简洁且易于维护。
基于 ROWS BETWEEN 子句的具体问题是什么?
在使用 ROWS BETWEEN 时,若未明确指定范围,默认行为可能不符合预期。例如,仅写 ORDER BY date 而不加 ROWS 子句时,部分数据库可能默认为 RANGE 模式,导致相同时间戳的数据被错误聚合。必须显式声明 ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW 以确保逐行累加的正确性。