








使用 java iterator 处理大数据集的核心做法是结合 java.util.scanner 或自定义的 streamtokenizer,通过 hasnext() 和 next() 方法逐行或逐词读取数据,避免一次性将全部数据加载到内存中。这种流式处理方式能确保在遍历过程中只保留当前正在处理的对象,从而将内存占用控制在极低水平,防止 outofmemoryerror。对于超过可用堆内存的大文件,这是最基础且有效的解决方案。
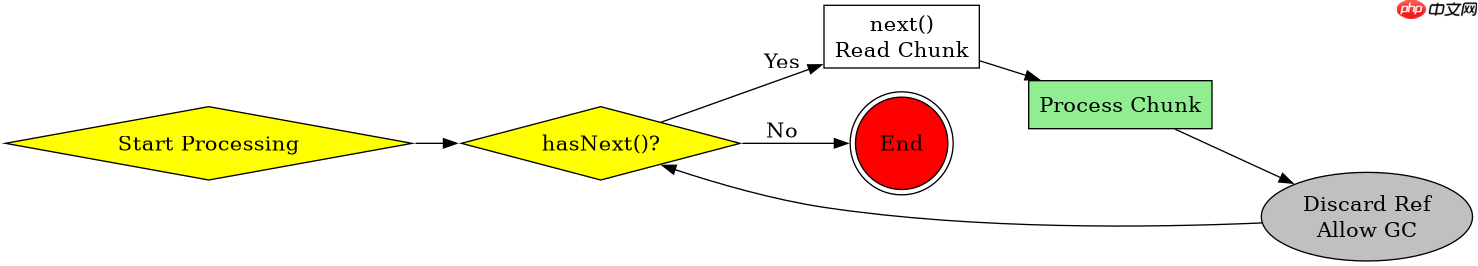
Scanner 迭代器如何控制内存边界
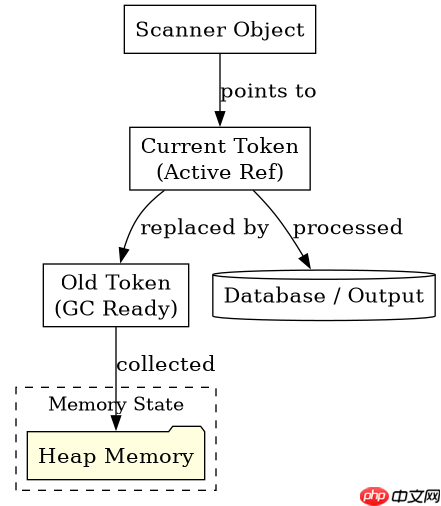
当使用 Scanner 作为数据源时,其内部维护了一个缓冲区,但不会预加载整个文件。调用 hasNext() 会检查缓冲区是否有更多令牌,而 next() 仅返回当前令牌并推进指针。这意味着无论文件多大,内存中始终只有当前这一行或这一个词的数据。关键在于不要将 next() 的结果收集到一个 List 中,而是直接在循环体内处理它,处理完即丢弃引用,允许垃圾回收器回收内存。
import java.io.File;
import java.util.Scanner;

public class LargeFileProcessor {
    public static void main(String[] args) throws Exception {
        File largeFile = new File("huge_data.txt");
        // 指定编码和分隔符,默认按空白分割
        Scanner scanner = new Scanner(largeFile, "UTF-8");

        // 使用 hasNext() 进行迭代
        while (scanner.hasNext()) {
            String dataChunk = scanner.next();
            process(dataChunk);
            // 此处不保存 dataChunk,下次循环覆盖,前一次引用被GC
        }
        scanner.close();
    }

    private static void process(String chunk) {
        // 模拟处理逻辑,如写入数据库或聚合统计
        System.out.println("Processing: " + chunk);
    }
}
上述代码展示了标准的迭代模式。预期结果是控制台逐行打印处理信息,而内存曲线保持平稳。如果将 process 替换为向 ArrayList 添加元素,内存将随文件大小线性增长,导致失败。因此,迭代器的价值在于“用完即弃”的特性。
立即学习“Java免费学习笔记(深入)”;

自定义 Iterator 实现惰性加载
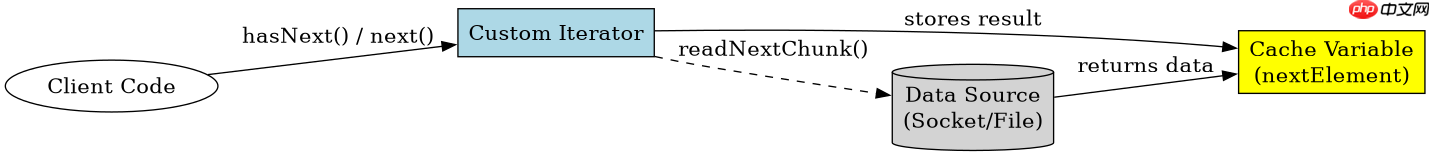
除了标准库,开发者常需实现自定义 Iterator<t></t> 来处理非标准格式或远程数据流。实现时需关注 hasNext() 的预读机制和 next() 的实际获取逻辑。通过在 hasNext() 中提前从数据源(如网络 Socket 或分块文件)读取下一个元素并存入缓存变量,可以确保 next() 调用时的即时性。这种设计同样遵循惰性求值原则,仅在客户端请求时才触发数据获取,适合分布式系统或实时数据管道。
import java.util.Iterator;
import java.util.NoSuchElementException;

public class ChunkedDataIterator implements Iterator<String> {
    private final DataFetcher fetcher;
    private String nextElement;
    private boolean hasLoaded = false;

    public ChunkedDataIterator(DataFetcher fetcher) {
        this.fetcher = fetcher;
        loadNext();
    }

    @Override
    public boolean hasNext() {
        return nextElement != null;
    }

    @Override
    public String next() {
        if (!hasNext()) {
            throw new NoSuchElementException();
        }
        String current = nextElement;
        loadNext(); // 预加载下一个,保持状态
        return current;
    }

    private void loadNext() {
        this.nextElement = fetcher.readNextChunk();
        this.hasLoaded = true;
    }
}

interface DataFetcher {
    String readNextChunk();
}
该自定义迭代器通过 loadNext() 方法在每次获取后预取下一项。预期行为是 hasNext() 始终反映真实剩余量,next() 返回当前有效数据。若 DataFetcher 连接的是无限流,此模式可无限运行而不积压内存。注意 nextElement 为 null 时视为结束,这要求 DataFetcher 在数据耗尽时返回 null。
Iterator 在处理空值或异常中断时的表现
当数据源在迭代中途抛出异常或返回 null 时,Iterator 的行为取决于具体实现。标准 Scanner 在遇到无法解析的字符时会抛出 InputMismatchException,此时迭代终止,已处理的数据不会自动回滚。自定义迭代器若在 loadNext() 中捕获异常并返回 null,则 hasNext() 将变为 false,循环自然结束。开发者需在 try-catch 块中包裹迭代逻辑,以区分正常结束和异常中断。例如,在处理 CSV 大文件时,某行格式错误可能导致 Scanner 报错,此时应记录错误位置而非直接崩溃,可通过设置 Scanner 的分隔符正则来容忍部分脏数据,或在自定义迭代器中跳过无效行。


















