








java hashmap 的扩容机制通过调整桶数组大小和重新哈希来维持性能,核心在于当元素数量超过阈值(容量乘以负载因子)时触发扩容。默认初始容量为16,负载因子为0.75,这意味着在插入第13个元素时会发生第一次扩容至32。理解这一机制的关键是避免频繁扩容带来的 o(n) 重哈希开销,以及在高并发或特定哈希分布下可能引发的性能瓶颈。
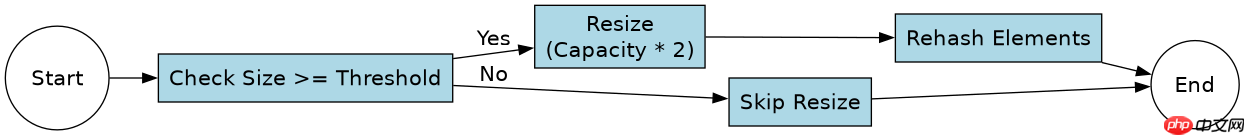
HashMap 扩容触发的具体条件是什么
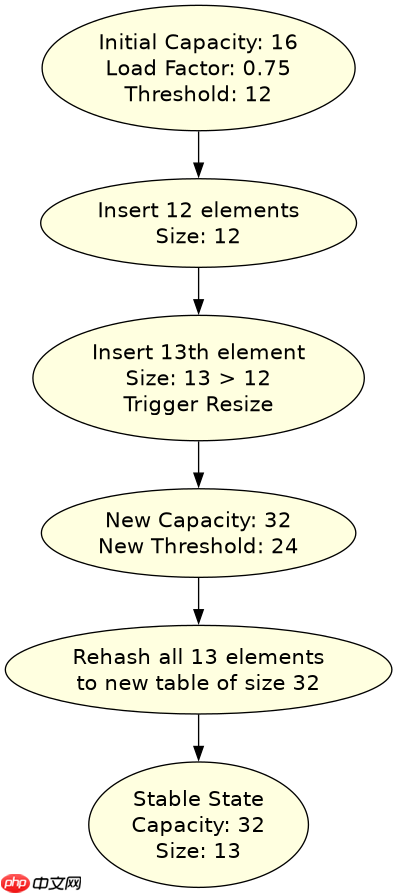
HashMap 扩容触发的具体条件是当 `size`(实际存储的元素个数)大于等于 `threshold`(阈值)。阈值的计算公式为 `capacity * loadFactor`。例如,使用默认构造函数创建 HashMap 时,初始容量为 16,负载因子为 0.75,因此阈值为 12。当插入第 13 个元素后,`size` 变为 13,大于 12,此时会触发 `resize()` 方法,将容量翻倍至 32,并重新计算新的阈值 24。
import java.util.HashMap;

public class HashMapResizeDemo {
    public static void main(String[] args) {
        // 使用默认构造函数:初始容量16,负载因子0.75
        HashMap<String, Integer> map = new HashMap<>();

        // 模拟插入过程,观察扩容点
        for (int i = 1; i <= 15; i++) {
            String key = "key" + i;
            int value = i;

            // 在插入前检查 size 和 threshold
            // 注意:threshold 是包私有字段,这里通过反射或直接逻辑推断
            // 默认情况下,threshold = 16 * 0.75 = 12
            if (i == 13) {
                System.out.println("Inserting element 13. This will trigger resize.");
            }
            map.put(key, value);
        }

        System.out.println("Final capacity: " + map.size()); // 实际元素数
        // 无法直接访问内部 table 长度,但可通过逻辑确认已扩容
    }
}
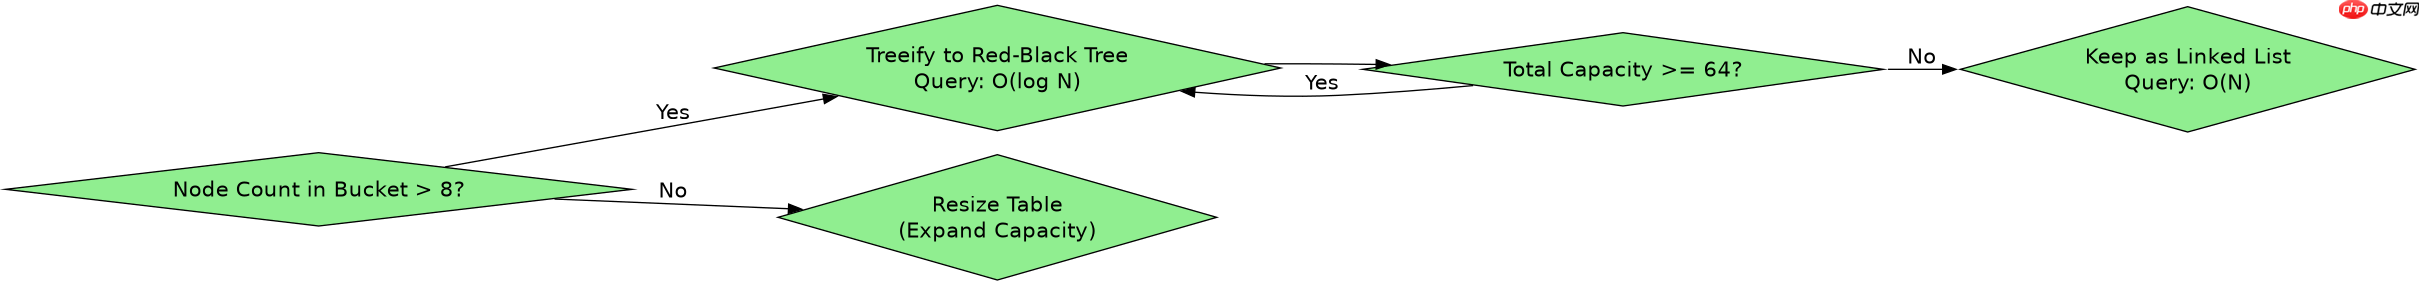
上述代码演示了默认配置下的扩容行为。当插入第13个元素时,由于超过了阈值12,HashMap 会执行扩容操作。扩容过程中,原有的节点会被重新分配到新的桶中。对于 JDK 8 及以后版本,如果链表长度超过8且总容量达到64,还会进行树化(红黑树转换),否则仅进行扩容。本例中未涉及树化,因为元素总数较少。
立即学习“Java免费学习笔记(深入)”;

FilePond 是一个 JavaScript 文件上传库,支持通过拖拽、粘贴和 API 方式处理文件、目录、URL 和 Data URI。它包含内置的图像优化功能、异步分块上传功能,并提供了适用于 React、Vue、Angular 和 Svelte 的适配器。
扩容过程中的重哈希如何影响性能
扩容过程中的重哈希是指将所有现有元素从旧的桶数组移动到新的桶数组。这是一个 O(N) 的操作,其中 N 是当前 HashMap 中的元素数量。在此期间,HashMap 不可用于其他写操作(单线程下无锁,但多线程下需外部同步),且 CPU 资源被大量消耗。如果频繁触发扩容,会导致性能显著下降。因此,预估数据量并初始化合适的容量可以减少扩容次数。
import java.util.HashMap;
import java.util.Map;

public class PerformanceImpactDemo {
    public static void main(String[] args) {
        // 场景1:不指定初始容量,频繁扩容
        long start1 = System.nanoTime();
        Map<String, Integer> map1 = new HashMap<>();
        for (int i = 0; i < 100000; i++) {
            map1.put("key" + i, i);
        }
        long end1 = System.nanoTime();
        System.out.println("Time taken without initial capacity: " + (end1 - start1) + " ns");

        // 场景2:指定初始容量,减少扩容
        long start2 = System.nanoTime();
        // 假设预计有100000个元素,负载因子0.75,所需容量约为 100000 / 0.75 = 133333
        // 向上取最近的2的幂次,即 131072 (2^17) 或更大
        Map<String, Integer> map2 = new HashMap<>(131072);
        for (int i = 0; i < 100000; i++) {
            map2.put("key" + i, i);
        }
        long end2 = System.nanoTime();
        System.out.println("Time taken with initial capacity: " + (end2 - start2) + " ns");
    }
}
通过对比两种场景,可以看出指定初始容量可以显著减少扩容次数,从而提升性能。在场景1中,HashMap 会从16开始,逐步扩容到32、64...直到足够容纳100000个元素,每次扩容都伴随重哈希。而在场景2中,一次性分配足够大的空间,避免了多次扩容开销。实际运行结果会显示场景2耗时更短。
当 HashMap 发生树化时,对查询性能有何具体影响
当 HashMap 中某个桶的链表长度超过8(TREEIFY_THRESHOLD),且当前 HashMap 的总容量大于等于64(MIN_TREEIFY_CAPACITY)时,该链表会转换为红黑树。树化后,查询、插入和删除操作的时间复杂度从 O(N) 降低到 O(log N),其中 N 是该桶中的元素数量。这在高冲突情况下能显著提升性能。但如果总容量小于64,即使链表长度超过8,也不会树化,而是先进行扩容,以期望通过增加桶数量来分散元素。




















