








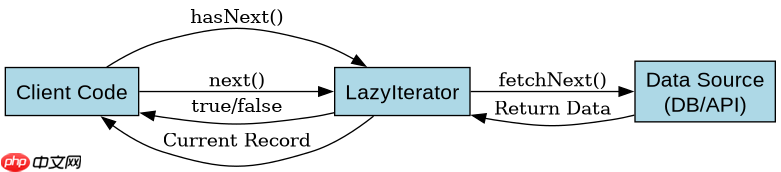
java iterator 实现懒加载的核心在于将数据的获取逻辑封装在 next() 方法的调用过程中,而非在迭代器创建时一次性加载所有数据。通过自定义一个实现了 java.util.iterator 接口的类,并在其内部维护当前状态和未处理的数据源,可以在每次调用 next() 时才从源头(如数据库、网络流或大文件)提取单条记录并返回,从而实现按需加载。
Iterator 接口中哪些方法支持懒加载行为
在 Java 的 Iterator 接口中,只有 next() 方法是驱动懒加载的关键入口,而 hasNext() 则是触发加载的前置检查点。remove() 方法通常用于清理已加载但未处理的数据,与加载时机无关。要实现真正的懒加载,必须在 next() 的实现体中编写从外部资源读取数据的代码,确保只有在客户端显式请求下一个元素时,系统才会执行昂贵的 I/O 操作或计算。
import java.util.Iterator;
import java.util.NoSuchElementException;

public class LazyDatabaseIterator implements Iterator<String> {
    private boolean hasLoaded = false;
    private String currentRecord = null;
    // 模拟数据库连接或远程服务
    private DatabaseService dbService = new DatabaseService();

    @Override
    public boolean hasNext() {
        if (!hasLoaded) {
            loadNextRecord();
        }
        return currentRecord != null;
    }

    @Override
    public String next() {
        if (!hasNext()) {
            throw new NoSuchElementException();
        }
        String record = currentRecord;
        // 重置状态,下次调用 next 时会重新加载
        hasLoaded = false;
        currentRecord = null;
        return record;
    }

    private void loadNextRecord() {
        // 实际场景中这里可能是 SQL 查询或 API 调用
        currentRecord = dbService.fetchNext();
        hasLoaded = true;
    }

    @Override
    public void remove() {
        throw new UnsupportedOperationException("Lazy iterator does not support removal");
    }
}

// 辅助类:模拟后端数据源
class DatabaseService {
    private int count = 0;
    public String fetchNext() {
        if (count < 5) {
            System.out.println("Fetching record " + count);
            return "Record-" + count++;
        }
        return null;
    }
}
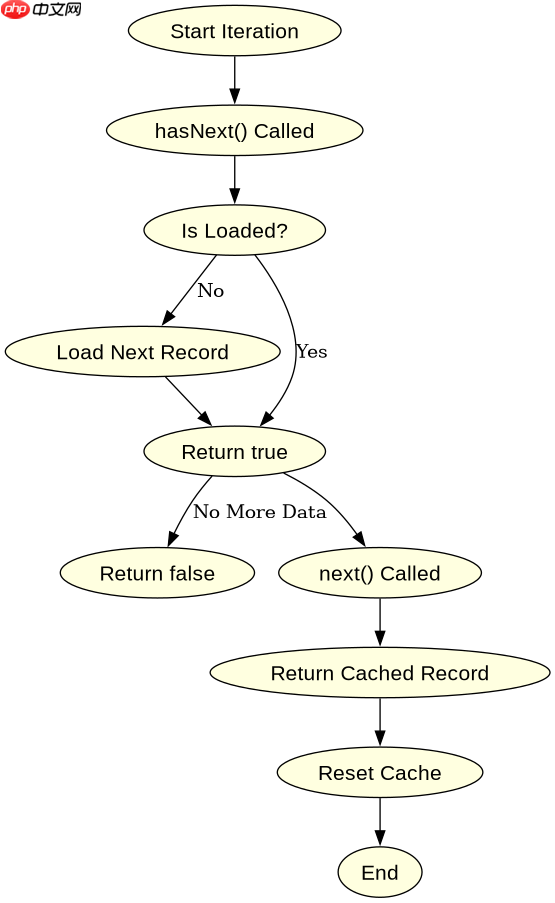
上述代码展示了最基础的懒加载迭代器结构。当调用 hasNext() 时,如果尚未加载,则调用 loadNextRecord() 获取数据;当调用 next() 时,返回当前缓存的记录并清除缓存,迫使下一次访问再次触发加载。这种模式避免了在初始化迭代器时遍历整个数据集。
立即学习“Java免费学习笔记(深入)”;

FilePond 是一个 JavaScript 文件上传库,支持通过拖拽、粘贴和 API 方式处理文件、目录、URL 和 Data URI。它包含内置的图像优化功能、异步分块上传功能,并提供了适用于 React、Vue、Angular 和 Svelte 的适配器。
如何结合 Stream API 优化懒加载迭代器的使用场景
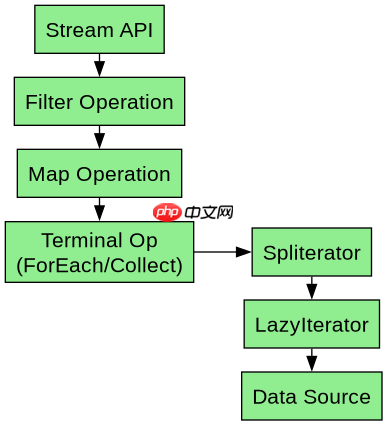
虽然原生 Iterator 可以实现懒加载,但在现代 Java 开发中,通常将其与 Stream API 结合使用以获得更强大的数据处理能力。通过将自定义的 Iterator 包装为 StreamSupport.stream(),可以利用流的中间操作(如 filter、map)进一步推迟计算,直到终端操作(如 collect 或 forEach)被调用时才真正开始迭代。这种方式不仅保留了内存优势,还简化了数据转换逻辑。
import java.util.Spliterator;
import java.util.stream.Stream;
import java.util.stream.StreamSupport;

public class StreamLazyExample {
    public static void main(String[] args) {
        // 创建懒加载迭代器
        LazyDatabaseIterator lazyIter = new LazyDatabaseIterator();

        // 转换为 Stream
        Stream<String> stream = StreamSupport.stream(
            Spliterators.spliteratorUnknownSize(lazyIter, Spliterator.NONNULL),
            false
        );

        // 中间操作不会触发加载
        Stream<String> filteredStream = stream.filter(s -> s.contains("Record-1"));

        // 终端操作触发实际加载
        filteredStream.forEach(System.out::println);
    }
}
在这个示例中,Spliterators.spliteratorUnknownSize() 用于创建一个未知的 Spliterator,因为懒加载迭代器无法预先知道总元素数量。通过 StreamSupport.stream() 转换后,所有的过滤和映射操作都是惰性的。只有当 forEach 被执行时,底层的 LazyDatabaseIterator 才会开始工作,按需从 DatabaseService 拉取数据。这种方法特别适用于处理海量数据或高延迟数据源的场景,能够显著降低内存占用并提高响应速度。
懒加载迭代器在遇到空值或异常时的具体表现
在懒加载迭代器的实现中,如果底层数据源在 loadNextRecord() 过程中抛出异常或返回空值,迭代器的行为将直接反映这些错误。例如,若 dbService.fetchNext() 因网络超时抛出 RuntimeException,该异常会直接向上传播至调用 hasNext() 或 next() 的代码块,导致程序中断。此外,若数据源返回 null,hasNext() 应正确识别并返回 false,以终止迭代。开发者需在 loadNextRecord() 中加入适当的异常处理和空值检查,以确保迭代器的健壮性。



















