








排查 java arraylist 内存泄漏,核心做法是定位持有大量无用对象的集合实例,并检查其生命周期是否超出必要范围。通常通过 mat (memory analyzer tool) 分析堆转储文件,使用 oql 查询或 dominator tree 找出占用内存最大的 arraylist 对象,进而追踪其 gc roots 引用链,确认是否存在静态集合、未关闭的资源监听器或缓存未清理等导致对象无法被回收的情况。

如何识别占用内存最大的 ArrayList 实例
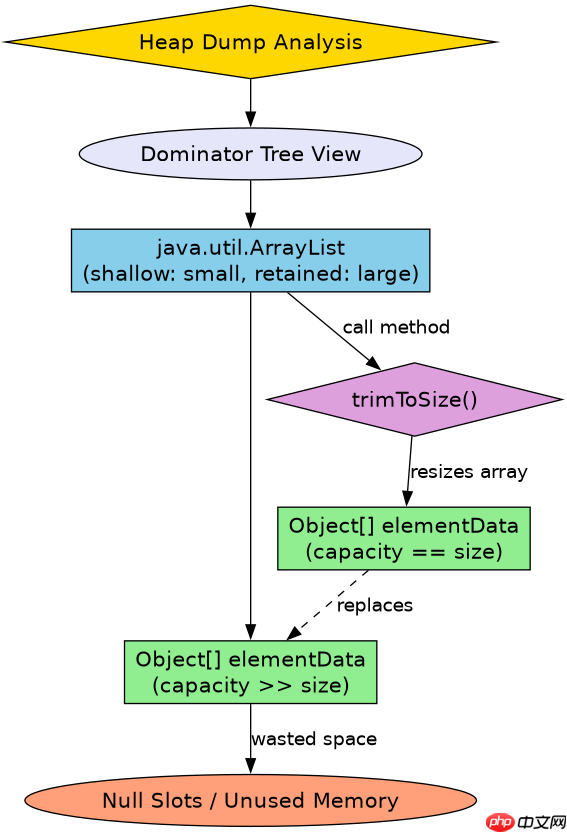
在堆转储中,直接按大小排序找到最大的 ArrayList 是最快的切入点。利用 MAT 的 Dominator Tree 视图,可以直观看到哪些对象支配了最多的内存。对于 ArrayList,其内部维护了一个 Object[] 数组,如果该数组长度远大于实际元素数量(即 size() 远小于 capacity()),或者数组中充满了不再需要的对象引用,这就是典型的泄漏迹象。通过右键点击该 ArrayList 选择 Path to GC Roots -> with outgoing references,可以找到是谁一直在引用它,从而确定泄漏源。
import java.util.ArrayList;
import java.util.List;

public class MemoryLeakExample {
    // 模拟一个长期存在的静态集合,容易导致泄漏
    private static List<String> cache = new ArrayList<>();

    public void processLargeData() {
        // 每次处理都添加新数据,但从未移除旧数据
        for (int i = 0; i < 100000; i++) {
            cache.add("Data-" + i);
        }
        // 假设这里应该清理缓存,但遗漏了
        // cache.clear();
    }

    public static void main(String[] args) {
        MemoryLeakExample example = new MemoryLeakExample();
        example.processLargeData();
        // 触发垃圾回收,观察 heap dump
        System.gc();
    }
}
运行上述代码并生成 Heap Dump 后,在 MAT 中打开文件。在 Dominator Tree 中搜索 java.util.ArrayList。你会发现这个静态 cache 变量持有的 ArrayList 位于树顶,因为它被 MemoryLeakExample 类本身(静态字段)所引用,属于强引用,GC 无法回收。其内部的 Object[] 数组将包含所有添加的字符串对象,占据大量内存。
立即学习“Java免费学习笔记(深入)”;

FilePond 是一个 JavaScript 文件上传库,支持通过拖拽、粘贴和 API 方式处理文件、目录、URL 和 Data URI。它包含内置的图像优化功能、异步分块上传功能,并提供了适用于 React、Vue、Angular 和 Svelte 的适配器。
如何分析 ArrayList 的内部数组膨胀问题
ArrayList 的底层实现是动态数组。当向其中添加元素时,如果当前容量不足,它会创建一个更大的新数组(通常是原容量的 1.5 倍),并将旧数据拷贝过去。如果程序频繁地向 ArrayList 添加大量数据后又清空它,或者一次性添加了极多数据但只使用很少一部分,会导致内部 Object[] 数组的 capacity 变得非常大,而 size 很小。这种“容量膨胀”会浪费内存,因为 JVM 堆中分配了大量未被使用的对象槽位。虽然这些槽位最终会被 GC 回收,但在高并发或长时间运行的应用中,这种持续的扩容和缩容(如果不手动 trim)会导致内存碎片化和不必要的 GC 压力。
import java.util.ArrayList;
import java.util.List;

public class CapacityLeakExample {
    public static void main(String[] args) {
        List<String> list = new ArrayList<>();

        // 模拟一次性添加大量数据,导致 capacity 激增
        for (int i = 0; i < 100000; i++) {
            list.add("Item-" + i);
        }

        // 此时 list.size() 是 100000, 但内部数组可能已经扩容到更大
        // 假设我们只需要前 10 个元素,其余丢弃
        List<String> smallList = new ArrayList<>(list.subList(0, 10));

        // 释放大列表引用
        list = null;

        // 关键步骤:如果 smallList 是通过 subList 创建的,它可能仍然引用原数组的一部分
        // 但如果是 new ArrayList<>(subList),则创建了新数组。
        // 为了演示内部数组膨胀,我们看原 list 即使被置空,如果在 GC 前被 dump,
        // 其内部数组依然巨大。更常见的情况是,对象被放入缓存但未 trim。

        // 模拟缓存场景:添加大量数据,然后只保留少量
        List<String> cache = new ArrayList<>();
        for (int i = 0; i < 100000; i++) {
            cache.add("Data-" + i);
        }
        // 业务逻辑变化,只关心最近的数据
        // 错误做法:不清理,导致内部数组保持大容量
        // 正确做法:trimToSize()
        cache.trimToSize();

        System.out.println("Capacity after trim: " + ((ArrayList<String>)cache).toArray().length); // 注意:toArray 会创建新数组,此处仅为示意
        // 实际上 trimToSize() 会缩小内部 backing array
    }
}在上述代码中,trimToSize() 方法可以将 ArrayList 的内部数组调整为当前 size 的大小。在 MAT 中分析时,如果看到一个 ArrayList 的 shallow size 很小,但 retained size 很大,且其内部 elementData 数组的长度远大于 size,这就是容量膨胀导致的内存浪费。通过调用 trimToSize() 或在初始化时指定合理的初始容量,可以避免这种情况。在堆转储中,你可以对比调用 trimToSize() 前后的 ArrayList 对象,观察其内部数组大小的变化。
基于 ArrayList 子列表 (subList) 的内存陷阱
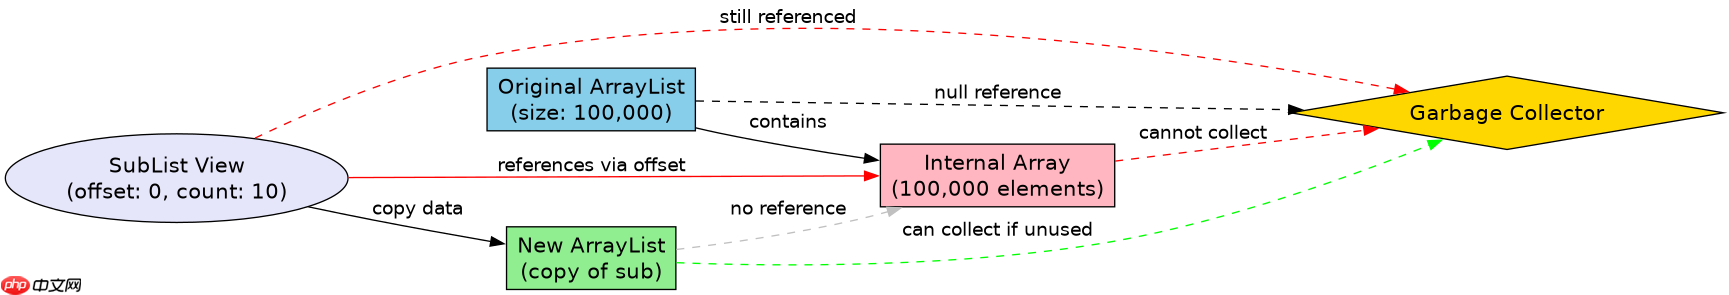
在使用 ArrayList.subList() 时,返回的视图对象仍然引用原始 ArrayList 的内部数组。如果原始列表非常庞大,而你只是通过 subList 获取了一小部分数据进行处理,并且这部分数据被存储在了另一个长期存活的集合中,那么原始的整个大数组将无法被回收,从而导致严重的内存泄漏。这是因为 SubList 的实现通常不复制数据,而是通过偏移量和计数来映射原数组。只要 SubList 或其引用的任何对象还活着,原 ArrayList 及其全部内部数组就都活着。
import java.util.ArrayList;
import java.util.List;

public class SubListLeakExample {
    public static void main(String[] args) {
        List<String> original = new ArrayList<>();
        for (int i = 0; i < 100000; i++) {
            original.add("BigData-" + i);
        }

        // 获取子列表,只取前 10 个
        List<String> sub = original.subList(0, 10);

        // 将子列表的内容复制到新的独立列表中
        List<String> independentList = new ArrayList<>(sub);

        // 此时,如果我们丢弃 original,但 sub 仍然引用它
        // 如果 sub 也被丢弃,original 才能被回收
        // 但如果我们将 sub 放入某个缓存,或者 original 被静态引用
        // 而 independentList 被长期使用,我们需要确保 original 不被意外引用

        // 常见错误:忘记断开 sub 与 original 的联系,或者 original 被意外保留
        // 正确的做法是:如果不再需要 original,将其置空
        original = null;

        // 但是,如果 sub 还被其他地方引用,original 依然无法回收
        // 因此,最安全的做法是使用 new ArrayList<>(subList) 创建完全独立的副本
        // 然后可以安全地丢弃 original 和 subList
    }
}
在 MAT 中,如果你发现一个小的 ArrayList 或 List 视图对象,其 Retained Size 却异常大,检查它的引用链。如果发现它是由 java.util.AbstractList$SubList 类型构成,并且指向一个巨大的原始 ArrayList,这就是典型的子列表泄漏。解决方法是,在只需要子集数据时,立即将其内容复制到新的 ArrayList 中,然后放弃对原始列表和子列表视图的引用。这样,原始的大数组就可以被 GC 正常回收。


















