








java 抽象类通过模板方法模式定义算法骨架,具体做法是创建一个包含 templatemethod 的抽象类,将不变逻辑放在该方法中,并将可变步骤声明为 abstract 或 protected 钩子。子类只需继承并实现这些特定步骤,即可复用整体流程。

如何设计包含固定流程与可变步骤的抽象基类
设计此类基类的核心在于提取公共逻辑并隔离差异点。在父类中编写一个 public final 的模板方法,按顺序调用各个步骤;对于需要子类定制的部分,定义为 abstract 方法强制实现,或定义为 protected 虚方法允许覆盖。
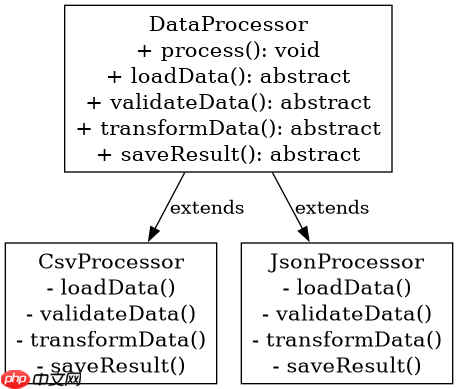
public abstract class DataProcessor {
    public final void process() {
        loadData();
        validateData();
        transformData();
        saveResult();
    }

    protected abstract void loadData();
    protected abstract void validateData();
    protected abstract void transformData();
    protected abstract void saveResult();
}
这种结构确保了执行顺序的稳定性,同时赋予了子类极大的灵活性。开发者可以通过扩展不同的子类来处理 CSV、JSON 或数据库数据,而无需重复编写加载、验证和保存的代码框架。
立即学习“Java免费学习笔记(深入)”;

FilePond 是一个 JavaScript 文件上传库,支持通过拖拽、粘贴和 API 方式处理文件、目录、URL 和 Data URI。它包含内置的图像优化功能、异步分块上传功能,并提供了适用于 React、Vue、Angular 和 Svelte 的适配器。
子类如何实现并调用该算法骨架
子类通过继承抽象基类并重写其抽象方法来提供具体实现。调用时,直接实例化子类并调用父类提供的 process 方法即可触发整个算法流程。这种方式实现了代码的高度复用,因为所有子类的执行路径完全一致,仅内部细节不同。

public class CsvProcessor extends DataProcessor {
    @Override
    protected void loadData() { System.out.println("Loading CSV..."); }
    @Override
    protected void validateData() { System.out.println("Validating CSV..."); }
    @Override
    protected void transformData() { System.out.println("Transforming CSV..."); }
    @Override
    protected void saveResult() { System.out.println("Saving CSV result..."); }
}

// Usage
new CsvProcessor().process();
运行上述代码将输出完整的处理日志,证明算法骨架已正确执行。子类可以专注于各自的数据格式逻辑,而不必关心流程控制。这种解耦使得系统易于维护和扩展,新增一种数据源只需添加一个新子类即可。
当子类需要跳过某个步骤时如何处理
如果某些子类不需要执行特定的步骤(如跳过验证),可以在基类中将对应步骤定义为 protected 的空实现方法,而非 abstract。子类可以选择覆盖该方法以提供自定义逻辑,或者保持默认空行为来跳过该步骤。这提供了比纯抽象方法更灵活的钩子机制。

















