








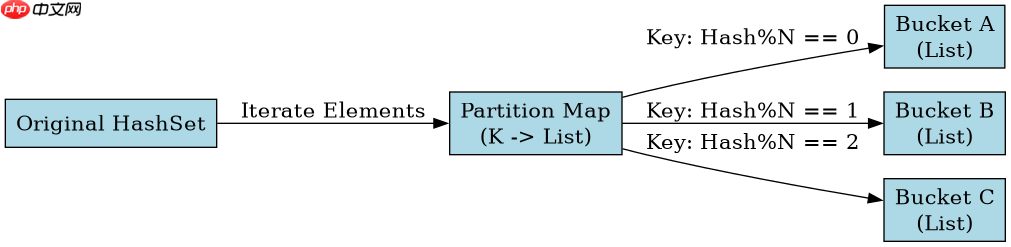
java 的 hashset 本身没有提供直接的分区方法,但可以通过遍历集合并根据条件将元素分配到多个子集合来实现。具体做法是创建一个新的 hashmap<k list>></k> 或类似结构作为分区容器,然后迭代原集合,根据元素的特征(如哈希值、特定字段或自定义规则)计算分区键,并将元素添加到对应的列表中。这样做可以将一个大集合拆分为多个逻辑上的小集合,便于并行处理或分类存储。
如何按哈希码余数进行简单分区
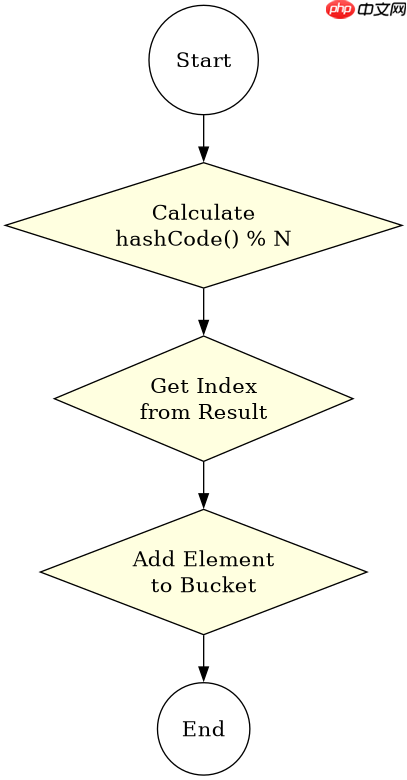
最直接且无需额外复杂逻辑的分区方式是依据元素在 HashSet 中的哈希码(hashCode)对分区数量取模。这种方法利用了 HashSet 内部基于哈希表实现的特性,能够相对均匀地将数据分散到不同的桶中。实现时,定义一个目标分区数 N,初始化一个包含 N 个 HashSet 或 List 的数组或列表,遍历原集合中的每个元素,计算 element.hashCode() % N 作为索引,将元素放入对应位置的子集中。这种方式适用于需要快速将数据打散的场景,例如负载均衡或简单的分片存储。
import java.util.*;

public class HashSetPartition {
    public static void main(String[] args) {
        Set<String> originalSet = new HashSet<>();
        originalSet.add("Apple");
        originalSet.add("Banana");
        originalSet.add("Cherry");
        originalSet.add("Date");
        originalSet.add("Elderberry");

        int numPartitions = 3;
        Map<Integer, Set<String>> partitions = new HashMap<>();
        for (int i = 0; i < numPartitions; i++) {
            partitions.put(i, new HashSet<>());
        }

        for (String item : originalSet) {
            int index = Math.abs(item.hashCode()) % numPartitions;
            partitions.get(index).add(item);
        }

        System.out.println(partitions);
    }
}
如何按业务属性进行自定义分区
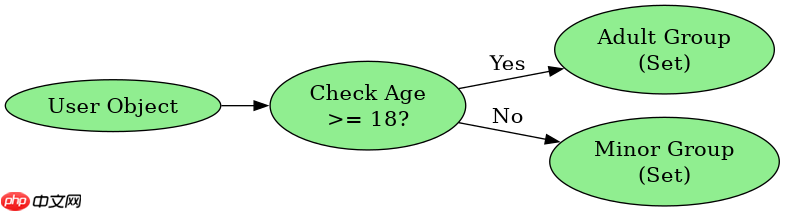
当需要根据业务逻辑而非底层哈希分布来分区时,应使用自定义的判断条件。例如,若集合中存储的是对象,可以根据对象的某个字段(如年龄、状态或类别)进行分类。实现上,同样初始化一个用于存放结果的映射结构,但在遍历时,不再使用哈希码取模,而是调用对象的 getter 方法获取关键属性,通过 if-else 或 switch 语句确定其所属分区,并追加到相应的子集合中。这种方式的灵活性更高,能确保具有相同业务属性的元素被归集在一起,适合报表统计或权限分组等场景。

FilePond 是一个 JavaScript 文件上传库,支持通过拖拽、粘贴和 API 方式处理文件、目录、URL 和 Data URI。它包含内置的图像优化功能、异步分块上传功能,并提供了适用于 React、Vue、Angular 和 Svelte 的适配器。
立即学习“Java免费学习笔记(深入)”;
import java.util.*;

class User {
    String name;
    int age;
    User(String name, int age) { this.name = name; this.age = age; }
    @Override public String toString() { return name + "(" + age + ")"; }
}

public class CustomPartition {
    public static void main(String[] args) {
        Set<User> users = new HashSet<>();
        users.add(new User("Alice", 25));
        users.add(new User("Bob", 17));
        users.add(new User("Charlie", 30));
        users.add(new User("David", 16));

        Map<String, Set<User>> groups = new HashMap<>();
        groups.put("Adult", new HashSet<>());
        groups.put("Minor", new HashSet<>());

        for (User u : users) {
            if (u.age >= 18) {
                groups.get("Adult").add(u);
            } else {
                groups.get("Minor").add(u);
            }
        }

        System.out.println(groups);
    }
}
分区操作后如何验证各子集的非空性与完整性
在执行完分区操作后,开发者通常需要验证结果是否符合预期,特别是检查是否有元素丢失或某些分区是否为空。可以通过遍历分区后的映射结构,检查每个子集合的大小(size)是否大于零,以及所有子集合的元素总数之和是否等于原始集合的大小。此外,还可以使用 Stream API 结合 Collectors.groupingBy 进行对比测试,确保手动实现的分区逻辑与标准库行为一致。这一步骤对于排查数据异常和保证程序健壮性至关重要。



















