








java jdbc 实现数据迁移的核心做法是关闭自动提交(autocommit),将多条 sql 语句包裹在同一个事务中,并在处理完成后显式调用 commit()。如果迁移过程中发生异常,则调用 rollback() 回滚所有操作以保证数据一致性。具体实施时,通常通过 connection.setautocommit(false) 开启事务,使用 preparedstatement 批量插入或更新数据,最后根据执行结果决定提交或回滚。
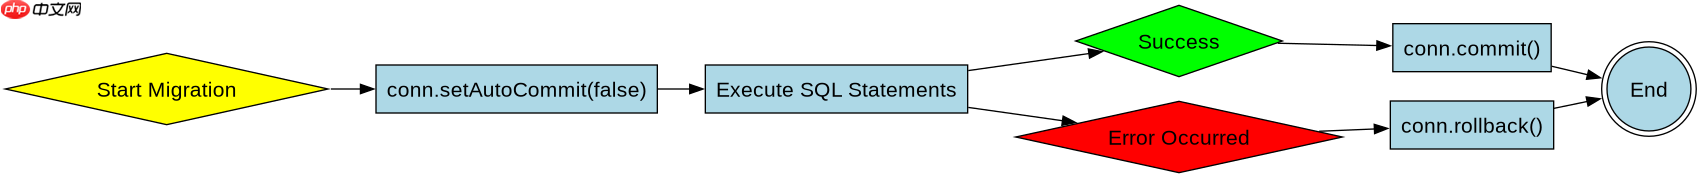
JDBC 事务的基本控制流程是怎样的
JDBC 事务的控制依赖于 java.sql.Connection 接口提供的三个核心方法:setAutoCommit(false)、commit() 和 rollback()。默认情况下,JDBC 连接处于自动提交模式,每条 SQL 语句执行后立即生效。为了进行数据迁移,必须首先禁用自动提交,这样所有的 DML(数据操纵语言)操作都会暂存在数据库中,直到显式提交。如果在迁移过程中捕获到任何异常,程序应进入 catch 块并调用 rollback(),撤销自事务开始以来的所有更改。这种机制确保了要么全部数据成功迁移,要么没有任何数据被修改,从而维持源数据和目标数据的一致性。
import java.sql.*;

public class JdbcMigration {
    public static void main(String[] args) {
        String url = "jdbc:mysql://localhost:3306/target_db";
        String user = "root";
        String password = "password";

        try (Connection conn = DriverManager.getConnection(url, user, password)) {
            // 1. 关闭自动提交,开启事务
            conn.setAutoCommit(false);

            String sql = "INSERT INTO users (name, email) VALUES (?, ?)";
            try (PreparedStatement pstmt = conn.prepareStatement(sql)) {
                // 模拟迁移一批数据
                pstmt.setString(1, "Alice");
                pstmt.setString(2, "alice@example.com");
                pstmt.addBatch();

                pstmt.setString(1, "Bob");
                pstmt.setString(2, "bob@example.com");
                pstmt.addBatch();

                // 2. 执行批量操作
                pstmt.executeBatch();

                // 3. 手动提交事务
                conn.commit();
                System.out.println("Migration completed successfully.");
            } catch (SQLException e) {
                // 4. 发生异常时回滚
                conn.rollback();
                System.err.println("Migration failed and rolled back.");
                throw e;
            }
        } catch (SQLException e) {
            e.printStackTrace();
        }
    }
}
如何优化大批量数据迁移的性能
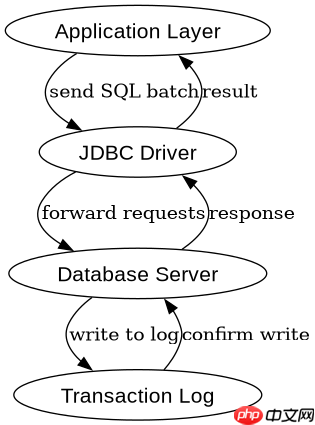
在处理大规模数据迁移时,逐条执行 SQL 会导致大量的网络往返开销和数据库日志写入压力。优化的关键在于使用 JDBC 的批处理功能(addBatch 和 executeBatch)。通过将多条 SQL 语句打包成一个批次发送给数据库,可以显著减少通信延迟。此外,还可以设置 Statement 的 batchSize 属性,或者在 URL 中配置 rewriteBatchedStatements=true(针对 MySQL)来进一步加速。对于超大数据集,建议分批次提交事务,例如每处理 1000 条记录后提交一次,这样既能保持一定的性能,又能避免单个事务过大导致的事务日志膨胀或内存溢出问题。

FilePond 是一个 JavaScript 文件上传库,支持通过拖拽、粘贴和 API 方式处理文件、目录、URL 和 Data URI。它包含内置的图像优化功能、异步分块上传功能,并提供了适用于 React、Vue、Angular 和 Svelte 的适配器。
立即学习“Java免费学习笔记(深入)”;
import java.sql.*;

public class BatchMigration {
    public static void main(String[] args) {
        String url = "jdbc:mysql://localhost:3306/target_db?rewriteBatchedStatements=true";
        String user = "root";
        String password = "password";
        int batchSize = 1000;

        try (Connection conn = DriverManager.getConnection(url, user, password)) {
            conn.setAutoCommit(false);
            String sql = "INSERT INTO logs (action, timestamp) VALUES (?, ?)";
            try (PreparedStatement pstmt = conn.prepareStatement(sql)) {
                for (int i = 0; i < 10000; i++) {
                    pstmt.setString(1, "ACTION_" + i);
                    pstmt.setTimestamp(2, new Timestamp(System.currentTimeMillis()));
                    pstmt.addBatch();

                    if (i % batchSize == 0 && i > 0) {
                        pstmt.executeBatch();
                        conn.commit(); // 分批提交
                        pstmt.clearBatch();
                    }
                }
                // 处理剩余数据
                pstmt.executeBatch();
                conn.commit();
            }
        } catch (SQLException e) {
            e.printStackTrace();
        }
    }
}
迁移过程中遇到主键冲突如何处理
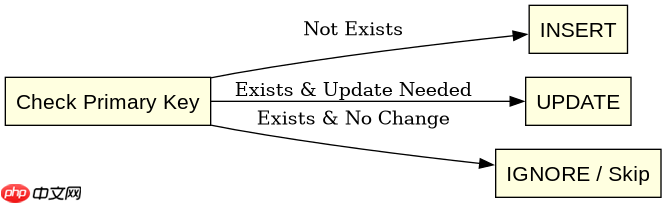
在数据迁移场景中,源数据的目标表可能已经存在部分数据,或者迁移过程中出现重复数据,导致违反唯一约束(如主键冲突)。此时,直接执行 INSERT 会抛出 SQLException 并触发事务回滚。为了解决这个问题,可以使用 INSERT IGNORE(MySQL)或 ON DUPLICATE KEY UPDATE 语法。这些语法允许数据库在检测到重复键时忽略插入操作或更新现有记录,而不是报错。另一种策略是在应用层先查询目标表是否存在该记录,再决定执行 INSERT 还是 UPDATE,但这会增加额外的查询开销。推荐使用数据库层面的冲突解决语法,以保持事务的原子性和执行的简洁性。



















