








java 中复合赋值运算符(如 a += b)会自动将右侧表达式的结果隐式转换为左侧变量的类型,从而避免在混合类型运算中因精度丢失或溢出导致的编译错误。具体做法是直接使用 +=、-= 等符号,编译器会将其自动展开为 (type) (left op right) 的形式。这意味着即使右侧是 int 而左侧是 long,或者右侧计算结果超出左侧类型范围,只要符合隐式转换规则,代码就能通过编译并正确执行,无需手动强制类型转换。
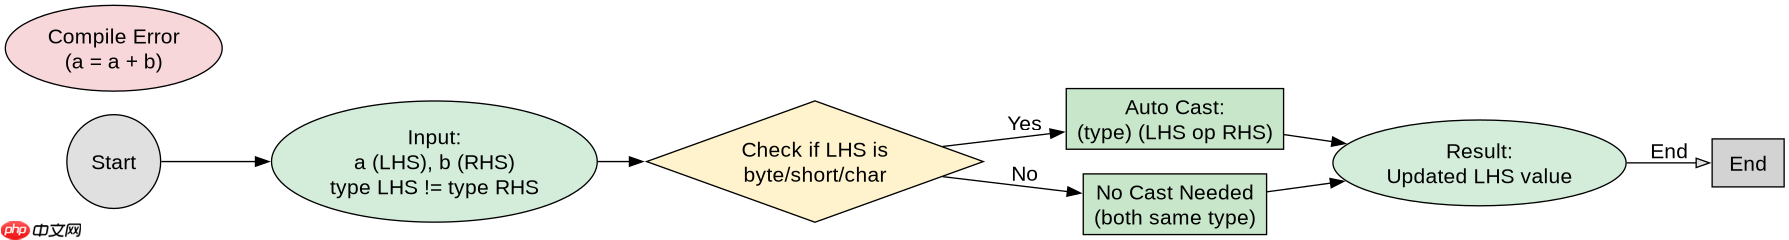
为什么 a += b 比 a = a + b 更安全?
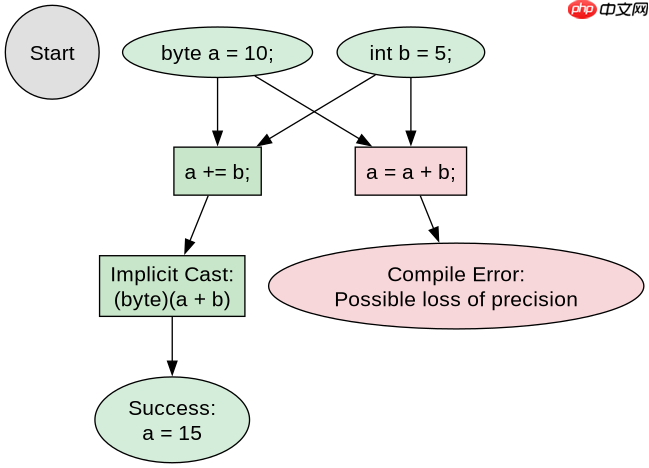
当左侧变量类型为 byte、short 或 char 时,a = a + b 会因右侧表达式提升为 int 而导致编译错误,必须显式强转;而 a += b 会自动处理这种窄化转换,直接修改原变量值且不会报错。例如 byte a = 10; 后执行 a += 5; 是合法的,但 a = a + 5; 则非法。这种机制简化了代码,避免了频繁的类型转换。
public class CompoundAssignmentTest {
    public static void main(String[] args) {
        byte a = 10;
        // a = a + 5; // 编译错误:可能损失精度
        a += 5; // 合法:自动转换为 (byte)(a + 5)
        System.out.println("a after += : " + a); // 输出 15

        short b = 20;
        int c = 10;
        // b = b + c; // 编译错误:int 不能直接赋给 short
        b += c; // 合法:自动转换为 (short)(b + c)
        System.out.println("b after += : " + b); // 输出 30
    }
}
复合赋值中的副作用与求值顺序如何影响结果?
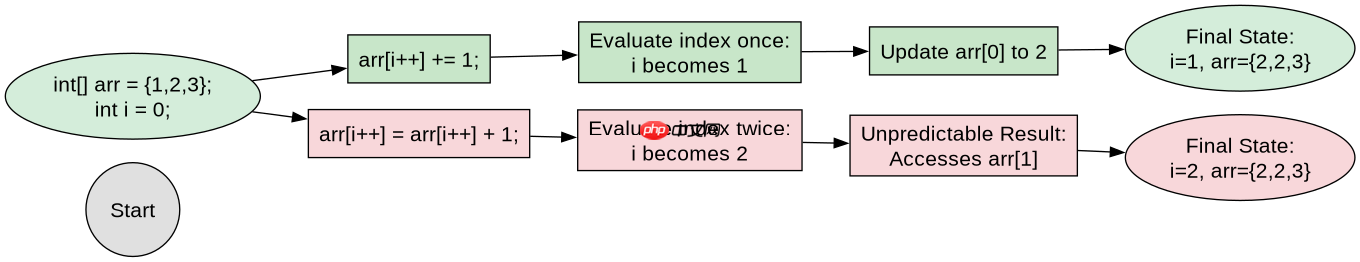
复合赋值运算符只对其左操作数求值一次,这在涉及数组索引或方法调用时能避免重复计算带来的副作用差异。例如 a[i++] += 1; 中,i++ 只执行一次,索引递增发生在整个赋值过程之后;而 a[i++] = a[i++] + 1; 会导致索引被递增两次,结果不可预测。此外,右操作数的计算结果在赋值前已确定,不会受左操作数后续变化的影响。这种特性使得复合赋值在循环和复杂表达式中更加可靠和安全。

FilePond 是一个 JavaScript 文件上传库,支持通过拖拽、粘贴和 API 方式处理文件、目录、URL 和 Data URI。它包含内置的图像优化功能、异步分块上传功能,并提供了适用于 React、Vue、Angular 和 Svelte 的适配器。
立即学习“Java免费学习笔记(深入)”;
public class SideEffectTest {
    public static void main(String[] args) {
        int[] arr = {1, 2, 3};
        int i = 0;

        // 使用复合赋值:i++ 只执行一次
        arr[i++] += 1;
        System.out.println("arr[0]: " + arr[0]); // 输出 2
        System.out.println("i: " + i); // 输出 1

        // 重置数组和索引
        arr = new int[]{1, 2, 3};
        i = 0;

        // 不使用复合赋值:i++ 执行两次
        arr[i++] = arr[i++] + 1;
        System.out.println("arr[0] with double increment: " + arr[0]); // 输出 2 (因为第二个 i++ 指向 arr[1])
        System.out.println("i after double increment: " + i); // 输出 2
    }
}
浮点数复合赋值如何处理 NaN 和 Infinity?
对于 float 和 double 类型,复合赋值运算符遵循 IEEE 754 标准,正确处理 NaN 和 Infinity。例如 float f = 0.0f; f += Double.POSITIVE_INFINITY; 结果是 Infinity,而 f += Float.NaN; 结果是 NaN。这些特殊值在运算中不会引发异常,而是按数学规则传播。开发者无需额外检查即可安全使用复合赋值处理边界情况,代码更简洁且行为可预测。



















