








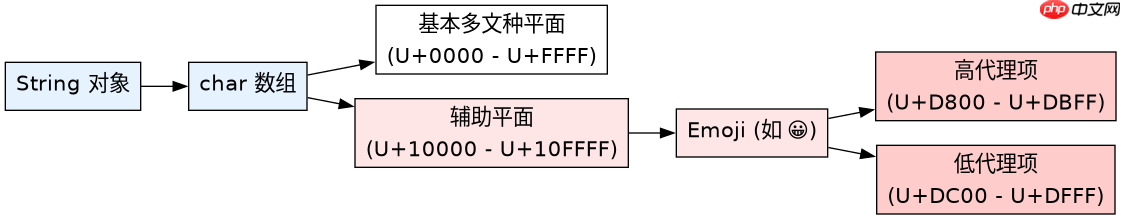
java 中的 char 类型无法直接存储 emoji,因为它仅占用 2 个字节(16 位),只能表示 unicode 基本多文种平面(bmp)内的字符。处理 emoji 需要将其视为代理对(surrogate pair),即使用两个 char 值组合来表示一个完整的码位。
如何判断字符串中是否包含 emoji
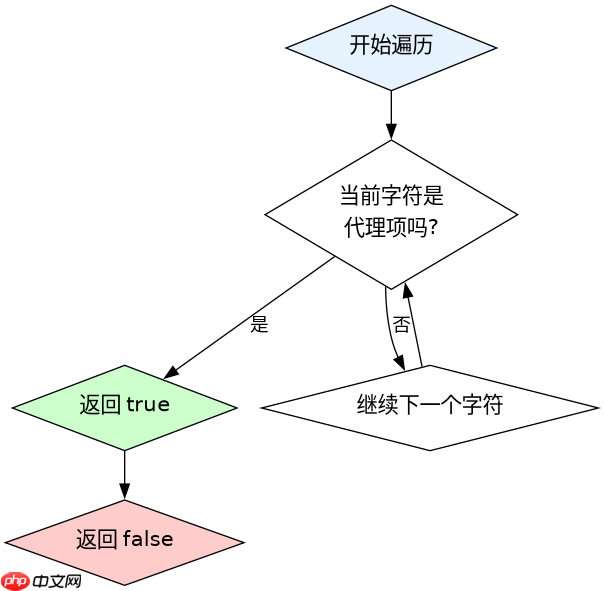
可以通过检查字符的 Unicode 范围或使用正则表达式来识别 emoji。由于 emoji 通常位于辅助平面,其码位大于 0xFFFF,在 Java 内部会被拆分为高代理项和低代理项。判断时只需检测是否存在处于代理范围的字符即可。
public class EmojiChecker {
    public static boolean containsEmoji(String str) {
        if (str == null) return false;
        for (int i = 0; i < str.length(); i++) {
            char ch = str.charAt(i);
            // 检查是否为代理对的一部分
            if (Character.isHighSurrogate(ch) || Character.isLowSurrogate(ch)) {
                return true;
            }
        }
        return false;
    }

    public static void main(String[] args) {
        String text = "Hello \uD83D\uDE00"; // Hello + Smiling Face
        System.out.println(containsEmoji(text)); // 输出: true
    }
}
上述代码遍历字符串中的每个 char。如果检测到任何字符属于高代理项或低代理项范围,则说明存在非 BMP 字符(如 emoji)。这种方法简单且高效,适用于大多数场景。
立即学习“Java免费学习笔记(深入)”;

FilePond 是一个 JavaScript 文件上传库,支持通过拖拽、粘贴和 API 方式处理文件、目录、URL 和 Data URI。它包含内置的图像优化功能、异步分块上传功能,并提供了适用于 React、Vue、Angular 和 Svelte 的适配器。
如何将包含 emoji 的字符串转换为 byte 数组
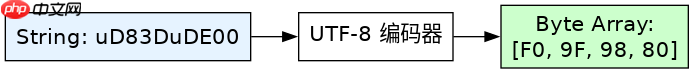
将包含 emoji 的字符串转换为字节数组时,必须使用支持 UTF-8 的编码方式。UTF-8 能够正确处理代理对,将每个 emoji 编码为 4 个字节。直接使用 getBytes() 并指定 StandardCharsets.UTF_8 是最可靠的方法。
import java.nio.charset.StandardCharsets;

public class EmojiEncoder {
    public static byte[] encodeEmoji(String str) {
        if (str == null) return new byte[0];
        return str.getBytes(StandardCharsets.UTF_8);
    }

    public static void main(String[] args) {
        String emoji = "\uD83D\uDE00"; // Smiling Face
        byte[] bytes = encodeEmoji(emoji);
        System.out.println(bytes.length); // 输出: 4
        for (byte b : bytes) {
            System.out.printf("%02X ", b);
        }
        // 输出: F0 9F 98 80
    }
}
该程序展示了如何将 emoji 转换为字节数组。UTF-8 编码下,一个 emoji 通常占用 4 个字节。通过打印字节内容,可以验证编码的正确性。注意不要使用 ISO-8859-1 等单字节编码,否则会导致数据丢失。
如何处理从输入流读取的包含 emoji 的数据
当从输入流读取包含 emoji 的数据时,应确保使用正确的字符集解码。推荐使用 InputStreamReader 并指定 StandardCharsets.UTF_8,或者使用 BufferedReader 包装它。这样可以保证 emoji 被正确解析为字符串,而不会因编码错误导致乱码。



















