








java 中实现异常分组批量处理的核心做法是定义一个包含多个具体异常类型的父类或接口,在 catch 块中捕获该父类,从而一次性处理所有子类的异常。通过继承 exception 创建自定义的分组基类(如 businessexception),并将所有业务相关的异常(如 orderexception、userexception)继承自它,即可在代码中统一拦截和响应。
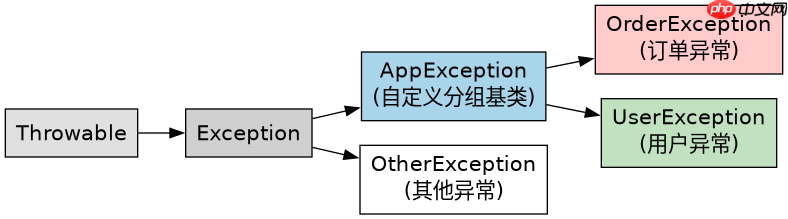
如何设计异常的继承结构
设计异常分组的直接方法是创建一个公共的父级异常类,让所有需要被归为一组处理的异常都继承自这个父类。这样做的结果是,任何子类抛出的异常都可以被针对父类的 catch 语句捕获,从而实现逻辑上的归类。例如,可以定义一个名为 AppException 的基类,它本身不携带特殊逻辑,仅作为类型标识。
public class AppException extends Exception {
    public AppException(String message) {
        super(message);
    }
}

public class OrderException extends AppException {
    public OrderException(String message) {
        super(message);
    }
}

public class UserException extends AppException {
    public UserException(String message) {
        super(message);
    }
}
上述代码定义了三个类:AppException 是根节点,OrderException 和 UserException 是其子节点。这种结构确保了它们在类型检查时具有共同的祖先,为后续的批量捕获奠定了基础。
立即学习“Java免费学习笔记(深入)”;

FilePond 是一个 JavaScript 文件上传库,支持通过拖拽、粘贴和 API 方式处理文件、目录、URL 和 Data URI。它包含内置的图像优化功能、异步分块上传功能,并提供了适用于 React、Vue、Angular 和 Svelte 的适配器。
如何在代码中实现批量捕获
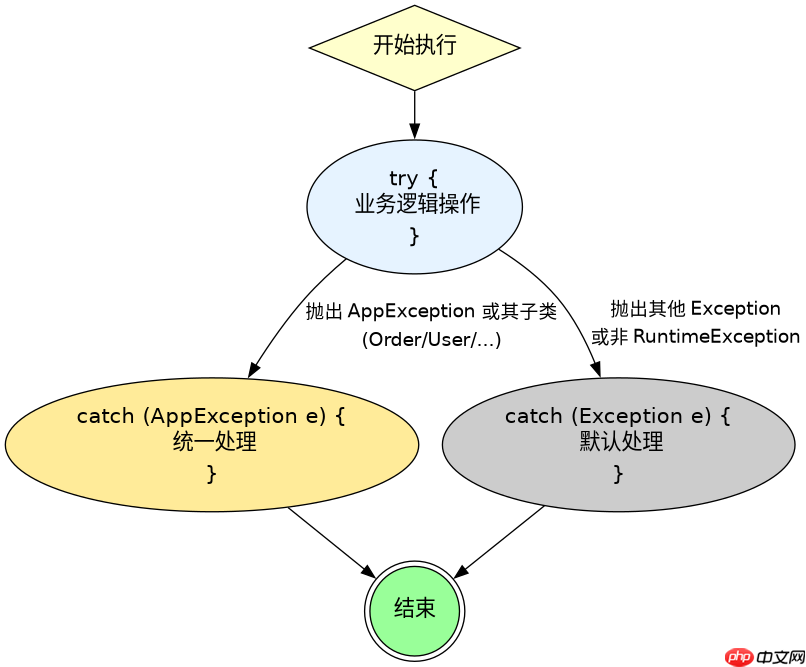
在业务逻辑中实现批量处理的直接方法是在 try-catch 块中使用父类异常作为捕获目标。当程序执行到可能抛出 OrderException 或 UserException 的代码段时,如果发生错误,JVM 会向上查找匹配的 catch 块。由于 AppException 是它们的父类,因此会被优先匹配并执行统一的错误处理逻辑,如记录日志或返回标准错误码。
public void processTransaction() {
    try {
        // 模拟可能抛出不同业务异常的操作
        if (Math.random() > 0.5) {
            throw new OrderException("订单处理失败");
        } else {
            throw new UserException("用户信息无效");
        }
    } catch (AppException e) {
        // 统一处理所有 AppException 及其子类
        System.out.println("捕获到业务异常: " + e.getMessage());
    } catch (Exception e) {
        // 处理其他非业务异常
        System.out.println("捕获到其他异常: " + e.getMessage());
    }
}
在这个示例中,processTransaction 方法内部抛出了两种不同的异常,但外层的 catch (AppException e) 能够同时捕获它们。这避免了为每个具体异常编写重复的 catch 块,简化了代码结构。需要注意的是,更具体的异常捕获块必须放在更通用的父类捕获块之前,否则会导致编译错误,因为父类块会“吃掉”所有子类异常。
基于实际运行结果的具体问题分析
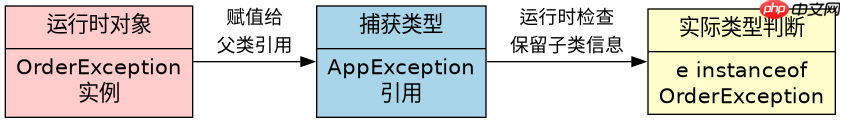
基于程序中 catch (AppException e) 块的执行结果,具体问题是:当 OrderException 被抛出时,e.getClass() 返回的实际类型是什么?答案是 OrderException,而不是 AppException。虽然 catch 声明的是父类类型,但运行时对象仍然是具体的子类实例。这意味着在 catch 块内部,可以通过 instanceof 或 getClass() 进一步区分具体的异常来源,如果需要的话。



















