








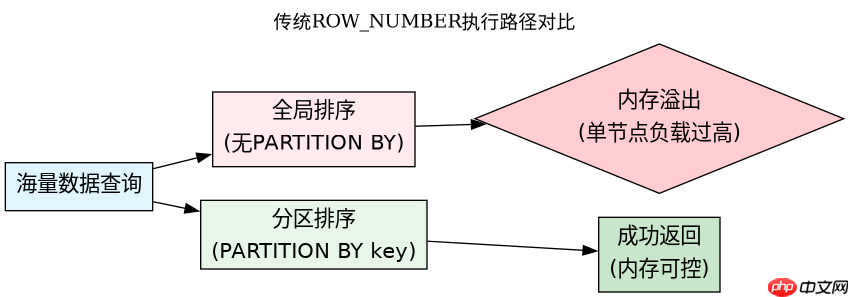
在sql中避免 row_number() 在海量数据下内存溢出,核心策略是限制窗口函数的分区粒度、使用分页游标替代全量排序,以及利用数据库的临时表或物化视图进行预计算。直接调用不带 partition by 的全局排序极易导致单节点内存耗尽,而通过分桶(sharding)或分批处理可以将压力分散到多个执行单元。
如何优化全局排序导致的内存瓶颈
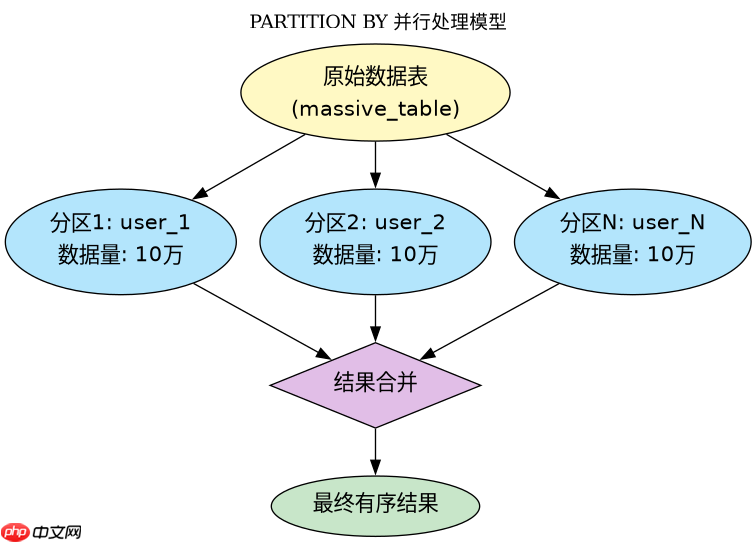
当 ROW_NUMBER() 用于全局排名时,数据库引擎通常需要在单个工作进程中对所有数据进行排序和计数,这会占用巨大的堆内存。解决这一问题的最直接方法是引入 PARTITION BY 子句,将全局大任务拆解为多个小分区。例如,按业务主键(如 user_id 或 tenant_id)进行分区,确保每个分区的数据量在内存可承受范围内。如果必须全局排序,应结合 LIMIT 和索引优化,或者使用数据库特定的流式排序特性(如 PostgreSQL 的 MERGE 排序),但最稳妥的方式仍是物理层面的数据分片。
-- 错误示例:无分区,全表排序,易OOM
SELECT id, ROW_NUMBER() OVER (ORDER BY created_at DESC) as rn
FROM massive_table;

-- 正确示例:按租户ID分区,分散内存压力
SELECT id, tenant_id,
       ROW_NUMBER() OVER (PARTITION BY tenant_id ORDER BY created_at DESC) as rn
FROM massive_table;
如何使用游标分页替代全量窗口函数
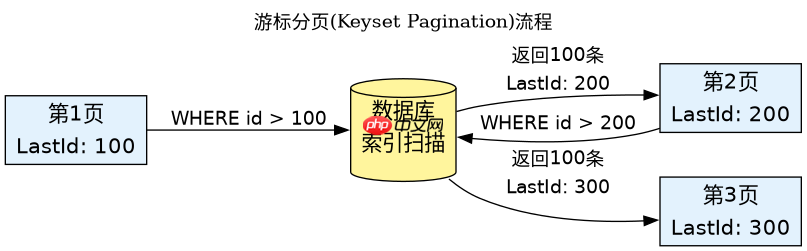
对于需要逐行处理或导出海量数据的场景,直接使用 ROW_NUMBER() 生成完整序列号是不现实的,因为结果集本身可能超出内存限制。此时应采用基于主键或唯一索引的“游标分页”(Keyset Pagination)。这种方法不依赖窗口函数计算全局序号,而是通过上一次查询的最后一条记录的主键值作为下一次查询的过滤条件。这种方式时间复杂度稳定在 O(log N),且内存占用仅为当前页的大小,彻底避免了因计算全量序号导致的内存溢出。
-- 游标分页示例:无需ROW_NUMBER,仅靠WHERE条件
-- 第一次查询
SELECT * FROM orders ORDER BY id LIMIT 100;
-- 假设最后一条id为1000,第二次查询
SELECT * FROM orders WHERE id > 1000 ORDER BY id LIMIT 100;
当分区键分布极度倾斜时如何处理
在使用 PARTITION BY 优化后,如果某个分区键的值(如热门商品ID或超级用户ID)数据量极大,该特定分区仍可能导致局部内存溢出。这种情况下,需要在应用层或存储过程层面进行二次拆分。具体做法是将倾斜的分区进一步按二级维度(如时间范围或哈希取模)拆分,或者在数据库中创建中间临时表,先对倾斜数据进行独立处理并写入临时表,再与其他正常分区的数据合并。这种“热点隔离”策略能确保即使存在极端倾斜数据,也不会拖垮整个查询作业。

















