








在postgresql的sql中使用string_agg指定去重,需要在函数调用中直接加入distinct关键字。具体做法是将select列表中的聚合字段置于distinct之后、逗号之前,例如string_agg(distinct column_name, separator)。这样做会先对分组内的值进行去重处理,然后再按指定的分隔符拼接成字符串。如果同时需要排序,可以在distinct之后追加order by子句,确保去重后的结果顺序一致。
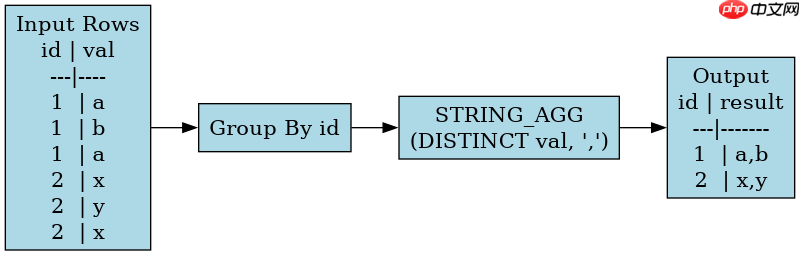
STRING_AGG基本语法与去重位置
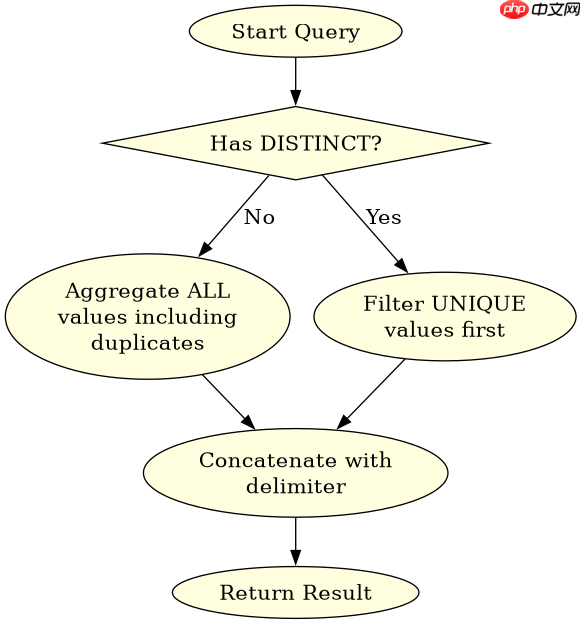
STRING_AGG函数的标准签名接受两个主要参数:要聚合的表达式和分隔符字符串。当需要去重时,必须在表达式部分显式声明DISTINCT。如果不加DISTINCT,函数会将组内所有行(包括重复值)全部拼接。正确的语法结构是STRING_AGG([DISTINCT] expression, delimiter [ORDER BY ...])。注意,DISTINCT的作用范围仅限于被聚合的列,不会影响GROUP BY的其他列。若省略DISTINCT,默认行为是保留所有重复项。
CREATE TABLE test_strings (id INT, val TEXT);
INSERT INTO test_strings VALUES
(1, 'a'),
(1, 'b'),
(1, 'a'),
(2, 'x'),
(2, 'y'),
(2, 'x');

-- 不去重
SELECT id, STRING_AGG(val, ',') AS no_distinct_agg
FROM test_strings
GROUP BY id;

-- 去重
SELECT id, STRING_AGG(DISTINCT val, ',') AS distinct_agg
FROM test_strings
GROUP BY id;
运行上述代码后,第一组查询的结果为:
id=1时,no_distinct_agg为'a,b,a'
id=2时,no_distinct_agg为'x,y,x'
第二组查询的结果为:
id=1时,distinct_agg为'a,b'(顺序可能不定)
id=2时,distinct_agg为'x,y'(顺序可能不定)
结合ORDER BY确保去重后顺序稳定
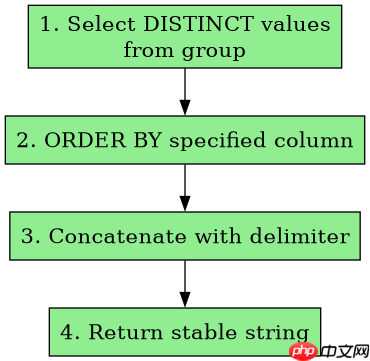
仅使用DISTINCT去重时,PostgreSQL不保证剩余值的排列顺序,这可能导致每次执行结果不同。为了获得可预测的输出,应在DISTINCT之后添加ORDER BY子句。语法为STRING_AGG(DISTINCT expression, delimiter ORDER BY sort_column)。这使得数据库先过滤重复值,再对唯一值进行排序,最后拼接。这种组合常用于生成固定格式的标签列表或权限字符串。
-- 去重并排序
SELECT id, STRING_AGG(DISTINCT val, ',' ORDER BY val) AS sorted_distinct_agg
FROM test_strings
GROUP BY id;
运行上述代码后,结果为:
id=1时,sorted_distinct_agg为'a,b'
id=2时,sorted_distinct_agg为'x,y'
无论输入顺序如何,只要值相同,输出始终一致。
STRING_AGG返回NULL的条件与处理
当分组内所有值均为NULL,或者分组内没有行时,STRING_AGG返回NULL。即使使用了DISTINCT,如果去重后只剩一个NULL值,结果仍为NULL。这是因为SQL标准规定聚合函数在忽略NULL值后若无有效数据则返回NULL。若希望在这种情况下返回空字符串而非NULL,需在外层包裹COALESCE函数,如COALESCE(STRING_AGG(DISTINCT val, ','), '')。这一行为在构建前端展示字符串时尤为重要,避免前端出现'null'文本。















