








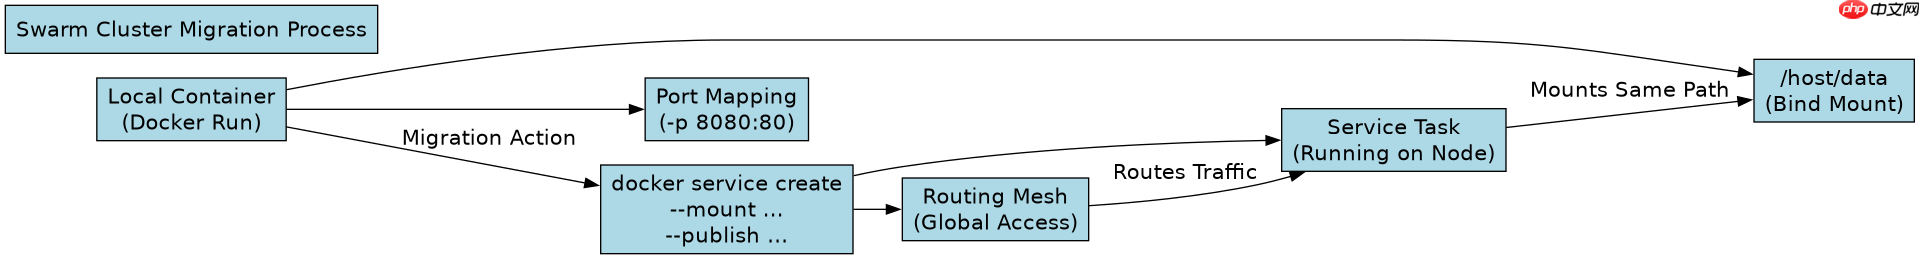
将单机 docker 容器平滑迁移到 swarm 集群,核心做法是使用 docker service create 命令创建服务,并配合 --mount type=bind,source=/host/path,target=/container/path 参数挂载原有数据卷。这样做可以将本地容器的配置和数据无缝接入集群管理,实现从独立运行到集群服务的过渡。
如何确保迁移后的服务能访问宿主机上的现有数据
要确保迁移后的服务能访问宿主机上的现有数据,必须在创建服务时显式指定绑定挂载(Bind Mount)。Swarm 默认使用分布式存储驱动,但为了保持与单机行为一致且无需额外配置存储后端,直接映射宿主机路径是最稳妥的方式。只需在 docker service create 命令中加入 --mount 标志,指向原容器使用的目录即可。
docker service create \
  --name my-migrated-service \
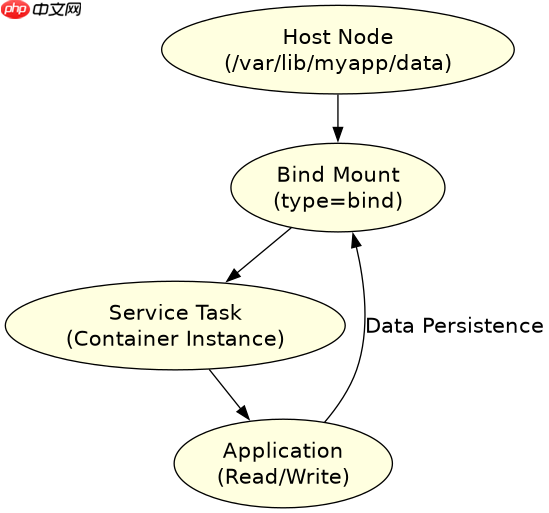
  --mount type=bind,source=/var/lib/myapp/data,target=/app/data \
  --replicas 1 \
  my-image:latest
执行上述命令后,Swarm 会在某个节点上启动一个任务(Task),该任务内的容器将直接读写宿主机的 /var/lib/myapp/data 目录。如果原单机容器使用的是命名卷(Named Volume),则需要先在节点上创建同名卷,或者改用绑定挂载方式以简化迁移过程。此方法确保了数据的持久性和一致性,且不需要停机重建数据。
如何处理单机容器的网络暴露端口问题
处理单机容器的网络暴露端口问题,需要使用 --publish 或 -p 参数将服务端口发布到集群的所有节点。单机模式下通常使用 -p host_port:container_port,而在 Swarm 中,docker service create 的 --publish 同样支持这种映射,但会将端口开放给集群中的所有 Worker 节点,而不仅仅是部署该任务的节点。这提供了更高的可用性和负载均衡能力。

「在我电脑上明明能跑」——因为少了Docker。帮你写Dockerfile、构建镜像、配置多环境、编排docker-compose,从本地开发到服务器部署一条龙。支持Node.js/Python/Go/Java/前端全栈,覆盖CI/CD集成、安全加固、监控告警,告别环境不一致的噩梦。 触发词:Docker部署、容...
docker service create \
  --name web-service \
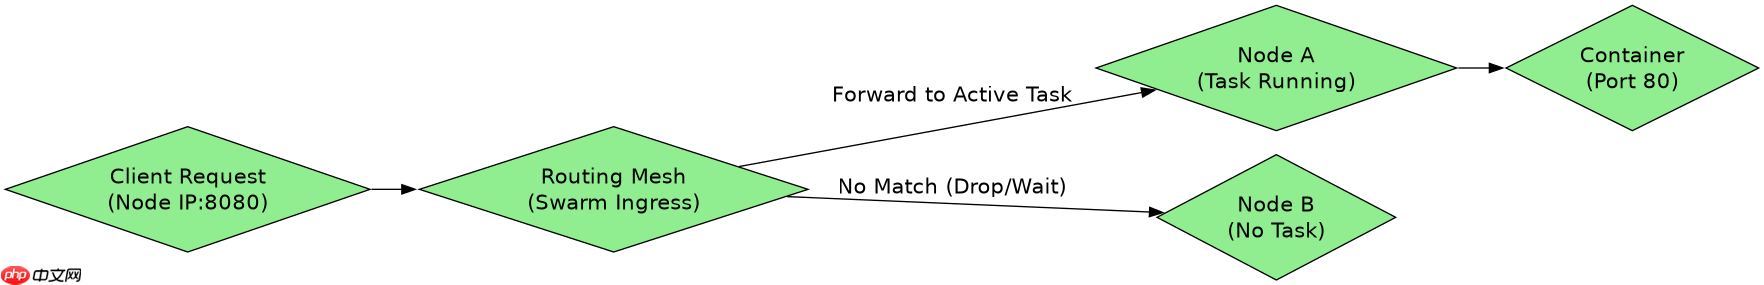
  --publish published=8080,target=80 \
  --replicas 3 \
  nginx:alpine
在上述示例中,所有集群节点的 8080 端口都会转发到对应节点上运行的 Nginx 容器的 80 端口。如果希望限制端口仅在特定节点可用,可以结合 --constraint 进行调度约束,但通常发布模式是为了实现全局访问。此外,Swarm 内置了路由网格(Routing Mesh),即使服务副本未运行在当前请求到达的节点上,流量也会被正确转发到正确的副本,这是单机模式不具备的特性。迁移时,只需将原有的端口映射参数原样复制到 service create 命令中即可。
基于服务副本数为1时的具体行为验证
当基于程序中某个输入、条件或结果的具体问题时,例如验证在 --replicas 1 条件下服务是否真的只在一个节点运行,可以通过 docker service ps 命令查看任务分布。在单副本模式下,Swarm 会尝试将任务调度到满足约束条件的节点上,如果只有一个节点可用,则任务只会在该节点运行。此时,如果该节点宕机,服务将不可用,除非有备用节点或增加了副本数。
为了验证这一点,可以创建一个单副本服务并检查其状态:
docker service create \
  --name test-single-replica \
  --replicas 1 \
  alpine sleep 3600

docker service ps test-single-replica
预期结果是 docker service ps 的输出中只显示一个 RUNNING 状态的任务,且其 NODE 列指向具体的某个节点 ID。这与单机容器固定在一台机器上的行为类似,但具备了被 Swarm 调度和监控的能力。如果后续需要高可用,只需增加 --replicas 的数量,Swarm 会自动在其他节点启动额外的副本,实现平滑扩容。
















