








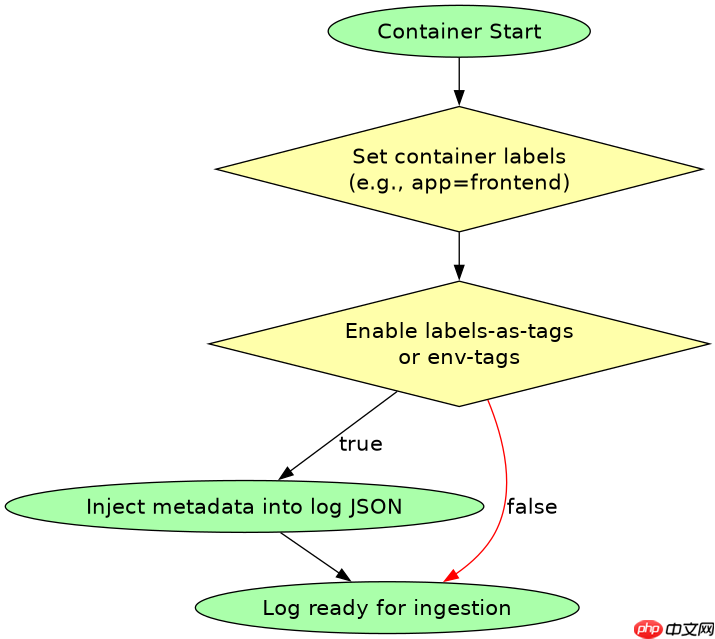
将 docker 容器日志发送至 logstash 最可靠的做法是配置 docker 的 json-file 驱动,并设置 env-tags 或 labels-as-tags 参数,让每条日志自动携带容器元数据,随后在 logstash 中通过 docker-container 输入插件或 filebeat 采集这些带标签的 json 日志。具体而言,启动容器时指定 --log-driver=json-file --log-opt env-tags=container_name,container_id(或使用 labels-as-tags=true),logstash 接收后利用 json 解码器解析日志体,并用 mutate 提取标签字段,最终写入 elasticsearch。若需处理非 json 格式的 stdout/stderr 日志,可改用 fluentd 或 filebeat 作为中间代理,但原生 json-file 驱动配合 logstash 的 beats 或 tcp/udp 输入也能实现直连。关键条件是:日志必须为 json 格式,且 logstash 管道需正确映射容器 id 与名称,否则无法区分不同容器的日志流。

Docker 容器日志如何自动携带元数据标签
Docker 的 json-file 日志驱动支持通过 env-tags 和 labels-as-tags 选项,将环境变量或容器标签嵌入日志 JSON 的 stream 和 logtag 字段之外的自定义键值对中。启用后,每条日志记录会包含 container_name、container_id 等字段,便于 Logstash 识别来源。例如,设置 --log-opt labels-as-tags=true 会将所有容器标签转为日志中的 tag_<label_key></label_key> 形式。此功能无需额外代理,直接由 Docker 引擎注入,确保元数据与日志内容同步生成。实际效果是,Logstash 收到的每条消息都自带结构化元数据,避免后续通过 IP 或主机名反查容器身份。
{
  "log": "2023-10-05T10:00:00Z INFO Starting service\n",
  "stream": "stdout",
  "time": "2023-10-05T10:00:00.000000000Z",
  "container_id": "abc123def456",
  "container_name": "web-app",
  "label_app": "frontend",
  "label_env": "production"
}
上述示例展示了启用 labels-as-tags 后的典型日志结构。其中 container_id 和 container_name 由 Docker 自动填充,label_app 和 label_env 来自容器启动时指定的标签。Logstash 可通过 json { source => "message" } 解析该 JSON,再用 mutate { add_field => { "app_name" => "%{label_app}" } } 提取业务标识。注意:若未启用标签注入,则 label_* 字段不存在,需依赖其他机制如 docker-container 插件动态获取元数据。此方法适用于所有使用 json-file 驱动的容器,且不影响日志性能。

「在我电脑上明明能跑」——因为少了Docker。帮你写Dockerfile、构建镜像、配置多环境、编排docker-compose,从本地开发到服务器部署一条龙。支持Node.js/Python/Go/Java/前端全栈,覆盖CI/CD集成、安全加固、监控告警,告别环境不一致的噩梦。 触发词:Docker部署、容...
Logstash 如何解析并路由带标签的容器日志
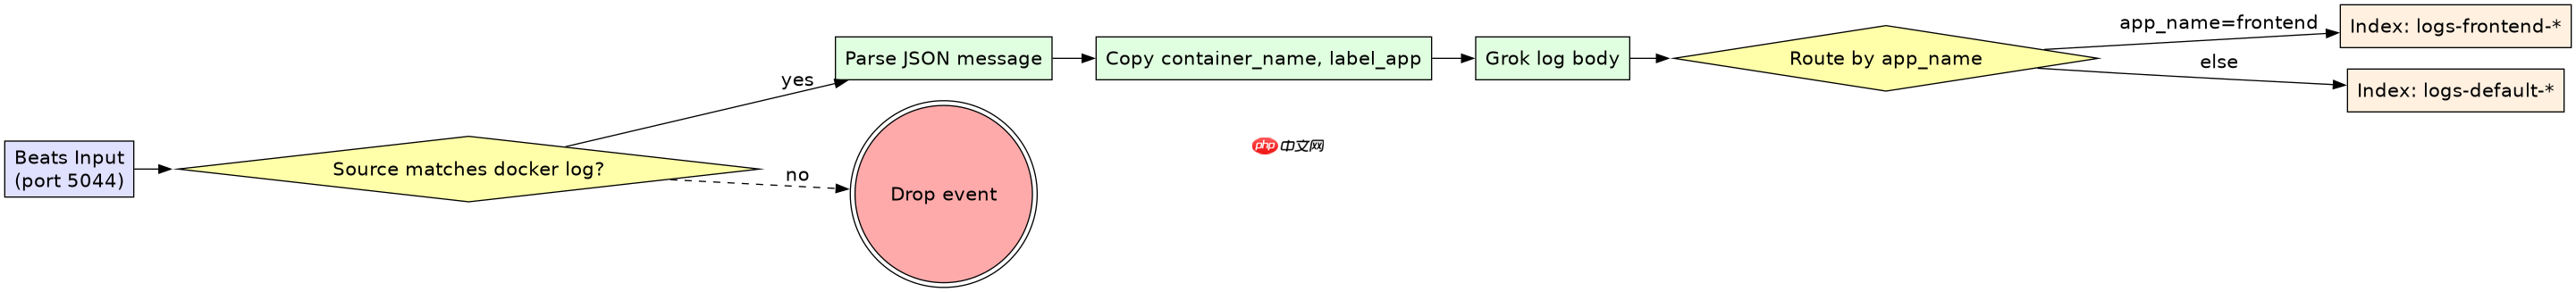
Logstash 接收 Docker 日志后,需通过 input 插件获取原始数据,再经 filter 阶段解析 JSON 并提取元数据,最后由 output 写入 Elasticsearch。推荐使用 beats 输入插件(如 Filebeat)或直接监听 json-file 生成的日志文件。在 filter 中,先使用 json 解码器解析日志体,再通过 mutate 或 grok 提取 container_name、label_app 等字段。路由逻辑可根据标签值设置索引别名,例如 if [label_env] == "production" { index => "logs-prod-%{+YYYY.MM.dd}" }。此流程确保日志按环境、应用分类存储,便于查询和分析。关键点在于:JSON 解析必须在元数据提取之前完成,否则字段不可用;同时需处理日志截断或多行合并问题,通常通过 multiline 插件解决。
input {
  beats {
    port => 5044
  }
}

filter {
  if [source] =~ /docker.*\.log$/ {
    json {
      source => "message"
      target => "docker_log"
    }
    mutate {
      copy => { "[docker_log][container_name]" => "container_name" }
      copy => { "[docker_log][label_app]" => "app_name" }
    }
    grok {
      match => { "[docker_log][log]" => "%{TIMESTAMP_ISO8601:timestamp} %{LOGLEVEL:level} %{GREEDYDATA:msg}" }
    }
  }
}

output {
  if [app_name] == "frontend" {
    elasticsearch {
      hosts => ["http://es:9200"]
      index => "logs-frontend-%{+YYYY.MM.dd}"
    }
  }
  else {
    elasticsearch {
      hosts => ["http://es:9200"]
      index => "logs-default-%{+YYYY.MM.dd}"
    }
  }
}
该 Logstash 配置演示了完整的数据流。beats 输入接收 Filebeat 发送的压缩日志,filter 中首先检查源路径是否匹配 Docker 日志文件,然后解析 JSON 消息体至 docker_log 子对象。接着,mutate 插件复制 container_name 和 label_app 到顶层字段,便于后续条件判断。grok 插件从日志正文中提取时间戳、日志级别和消息内容。输出部分根据 app_name 字段决定写入哪个 Elasticsearch 索引。若容器无 label_app 标签,则走默认索引。此配置假设 Filebeat 已正确配置 docker 模块并启用 json-file 日志采集。实际部署时需调整 hosts 地址和索引命名策略。
当容器未设置任何标签时 Logstash 如何处理日志
若容器启动时未指定任何 labels 或未启用 labels-as-tags,则日志中不会包含 label_* 字段,此时 Logstash 仍可通过 container_id 和 container_name 识别来源,但无法按应用或环境分类。解决方案是在 Logstash 中使用 if 条件判断字段是否存在,并为缺失标签提供默认值。例如,if ! [app_name] { mutate { add_field => { "app_name" => "unknown" } } }。此外,可结合 Docker API 定期查询容器标签,补充元数据,但这会增加延迟和复杂度。更简单的做法是强制要求所有容器必须定义至少一个 app 标签,或在编排工具(如 Docker Compose、Kubernetes)中统一注入标签。对于临时调试容器,接受其进入默认索引即可,不影响核心监控链路。

















