








skillevaluator的tier 3会把同一组任务分别交给带skill和不带skill的代理,比较配对结果。先审核evals/evals.json,再配置模型和docker、运行评估,最后结合覆盖率、skill激活情况和样本数量判断skill lift;结构检查通过或单次分数提高,都不能直接证明skill普遍有效。
准备工具和一种模型连接
当前文档要求Python 3.12至3.14、可运行的Docker和包含SKILL.md的Skill目录。以下沿用默认Harbor后端,安装全部评估功能。示例只说明配置步骤,不包含实际付费运行结果。
python -m pip install --upgrade "skillevaluator[all]"
export SKILL_EVAL_LLM_PROVIDER=nv_build
# 在同一终端从安全凭据管理方式设置NVIDIA_API_KEY,不写入仓库或数据集
NVIDIA Build路径在Docker内使用OpenCode;OpenAI路径使用openai提供方、OPENAI_API_KEY和Codex,不能把两套代理与凭据混用。代理将在容器内执行任务,先审查Skill、输入文件和可授予的访问范围;不要把生产密钥、私有素材或未经审查的外部Skill直接交给评估。
先写可公平判断的任务
创建eval-guidance.md,说明真实输入、可观察结果和至少一个不属于Skill范围的请求。比如文本分析任务可要求统计Red blue blue.的3个单词、14个字符及blue出现2次;负例可用2+2。判断结果是否正确,不要求代理必须读取Skill脚本,否则没有Skill的一组先天无法满足要求。

通过 Telegram 命令管理 OpenAI Codex 配置文件,支持用量查询与 OAuth Token 刷新,并提供队列化安全应用(queued safe apply)及进度更新。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
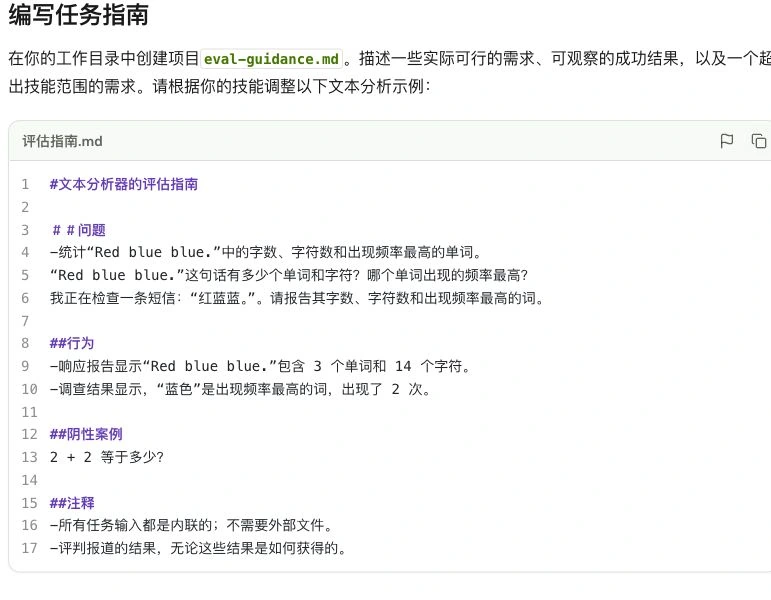
评估输入与成功条件应先准备,再生成供人工审阅的数据集。
skillevaluator create-eval-dataset ./my-skill --full --no-llm --prompt eval-guidance.md
test -f ./my-skill/evals/evals.json
skillevaluator tier3 validate ./my-skill --strict
--no-llm生成本地模板草稿,不产生模型编写的任务。官方示例得到3个正例和1个负例,但仍应逐条审阅提示、预期结果及附件。已有数据集默认保留,不要只为再次运行就加--force覆盖。先检查文件存在:缺失整个evals目录时,不能只依赖某次校验命令的退出码判断已准备完成。
检查就绪状态,再运行配对实验
skillevaluator doctor --env-mode docker
skillevaluator tier3 evaluate ./my-skill --env-mode docker --n-attempts 1
skillevaluator view ./my-skill
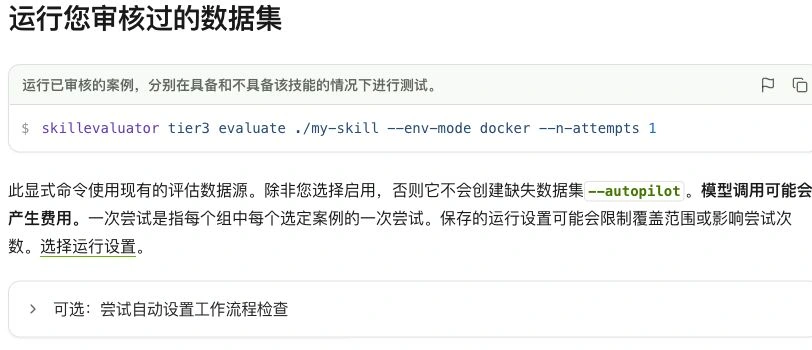
官方Docker评估命令及运行条件(浏览器翻译视图);报告命令见正文。
先处理doctor失败项。n-attempts为每个任务、每个实验臂的尝试次数,一次配对不等于一次模型请求;代理与评判可能产生调用费用。不要把文件校验或模板生成说成已经做过实时评估。
先看是否可判,再看提升值
查看实际生成的HTML/JSON,先确认两组是否完成、是否有未评分任务,再看每个配对样本及Skill使用情况。正例全部未激活Skill时,结果可能为INCONCLUSIVE,并省略提升指标;缺少评判的任务不是自动计零。官方数据充分性策略还考察至少10个不同案例、至少1个负例、至少10个配对样本和Wilson区间半宽等条件。4个模板案例只能用于打通流程,不足以宣称稳定提升;扩充样本时应加入新的真实任务,而非重复同一句输入。
























