








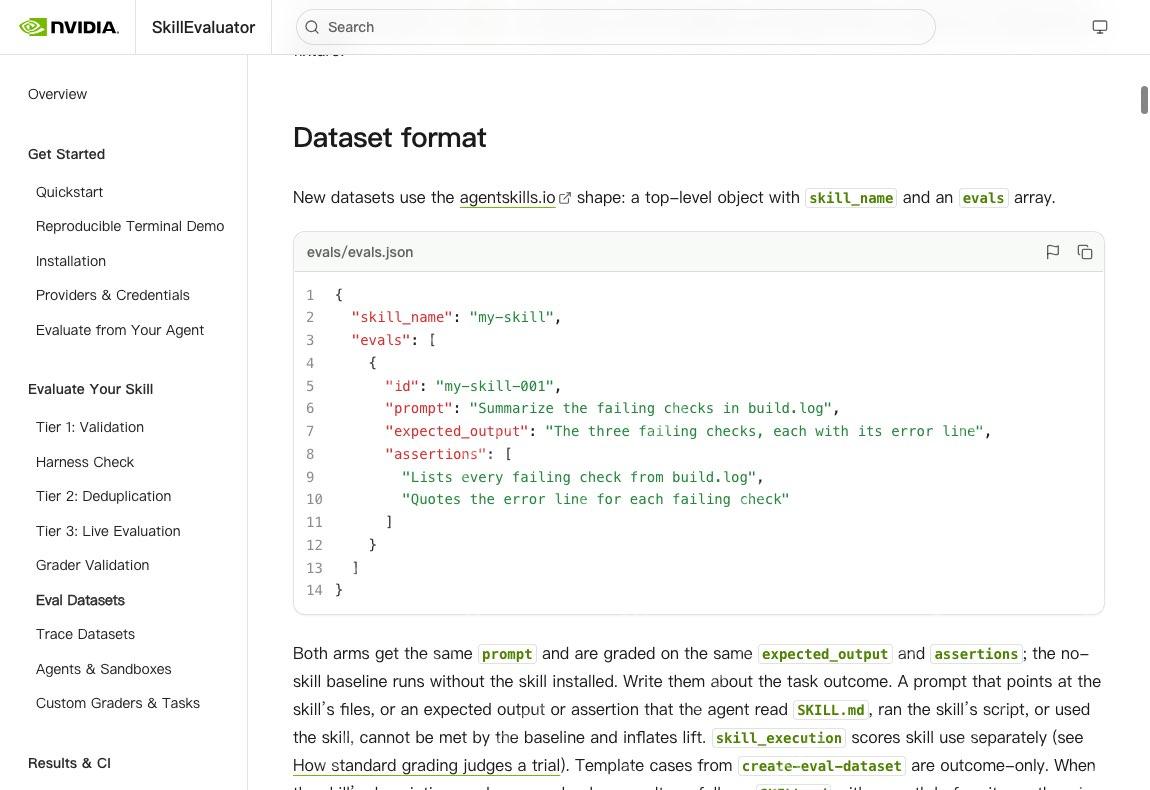
SkillEvaluator 的评估用例可以写在技能目录的 evals/evals.json。为同一个任务定义输入、预期结果和断言,再用严格验证检查结构和措辞。
先准备一个可以手算结果的技能
进入 skillevaluator 源码仓库的根目录,新建名为 word-counter 的技能文件夹,入口文件命名为 skill.md,把下面的内容存到这个文件里,之后再新建 evals 子目录。这里的词数统计规则直接按空白字符拆分文本,特意绕开标点、多语言分词的常见争议问题。
mkdir -p word-counter/evals
---
name: word-counter
description: >-
  Counts words in short text. Use when asked for a word count.
---

# Word Counter

Split the supplied text on whitespace and count the resulting words.
Return the total.
正例验收输出,负例验收任务边界
正例用刚好4个词的文本,预期成功触发词数统计技能,最终输出结果为4。负例用单位换算的请求,预期不会触发这个词数统计技能,但要给出正确的换算结果。把下面的JSON内容保存到 word-counter/evals/evals.json 路径下。
{
  "skill_name": "word-counter",
  "evals": [
    {
      "id": "word-counter-001",
      "expected_skill": "word-counter",
      "prompt": "Count the words in: red blue red green",
      "expected_output": "The text contains 4 words.",
      "assertions": [
        "Reports a total of 4 words"
      ]
    },
    {
      "id": "word-counter-002",
      "expected_skill": null,
      "prompt": "Convert 2 kilograms to grams.",
      "expected_output": "2000 grams",
      "assertions": [
        "Returns 2000 grams"
      ]
    }
  ]
}
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
严格验证不过时先看什么?
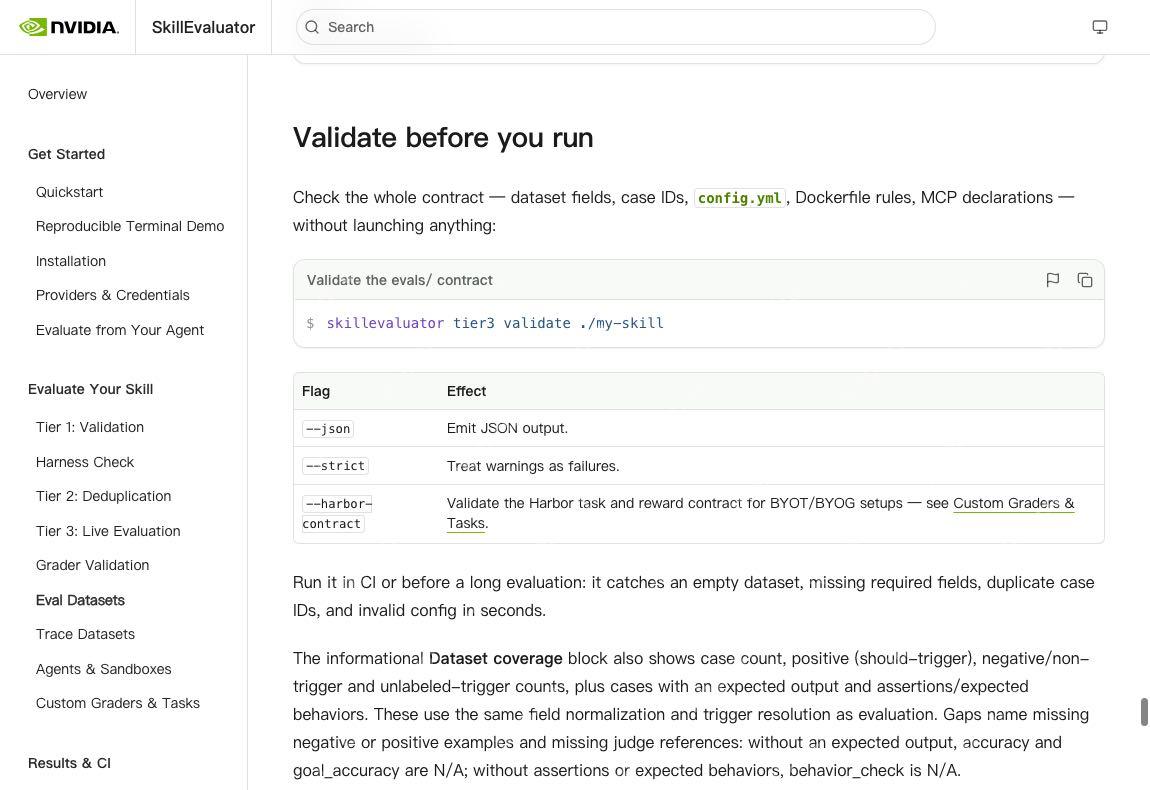
回到仓库根目录运行下面的命令,校验报错先排查三点:JSON格式是否合法、技能名是否和配置一致、所有用例ID是不是唯一。如果规则提示断言和技能本身强绑定,就把“必须读SKILL.md”这类要求,改写成可以直接从输出结果核对的条件。
uv run --python 3.13 --extra tier3 skillevaluator tier3 validate ./word-counter --strict
怎样判断这组用例够不够?
上面两条用例只能覆盖最基础的边界情况,和真实使用场景差距很大。可以再加几个没直接出现“词数统计”关键词的隐式正例,再补充连续空白字符、空字符串这类极端场景的用例,提前写清触发条件和预期输出,也留几组相同任务的用例给无技能的基线版本做对照。
如果精简安装报缺少 harbor,按上面的命令加上 Tier 3 依赖。只校验数据集时,先处理格式和断言问题,再进入需要模型和沙箱的运行环节。






















