用 SkillEvaluator 做技能对照评估时,让同一 Agent 分别在有技能和无技能的环境中完成同一批任务,再比较结果。Docker 路径需要安装 Tier 3 依赖并配置 Agent 与评估所需的模型服务。
先固定两组都能完成的任务
对照组和实验组的题目、预期输出、调用的模型、运行环境所有参数必须完全对齐。开了技能的实验组正常给agent装好对应技能就行,写任务说明的时候,绝对不能要求agent必须调用技能专属的脚本。举个例子,统计文本词数的任务,两组最后只要输出符合统一规则、可以直接核验的数字就达标。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
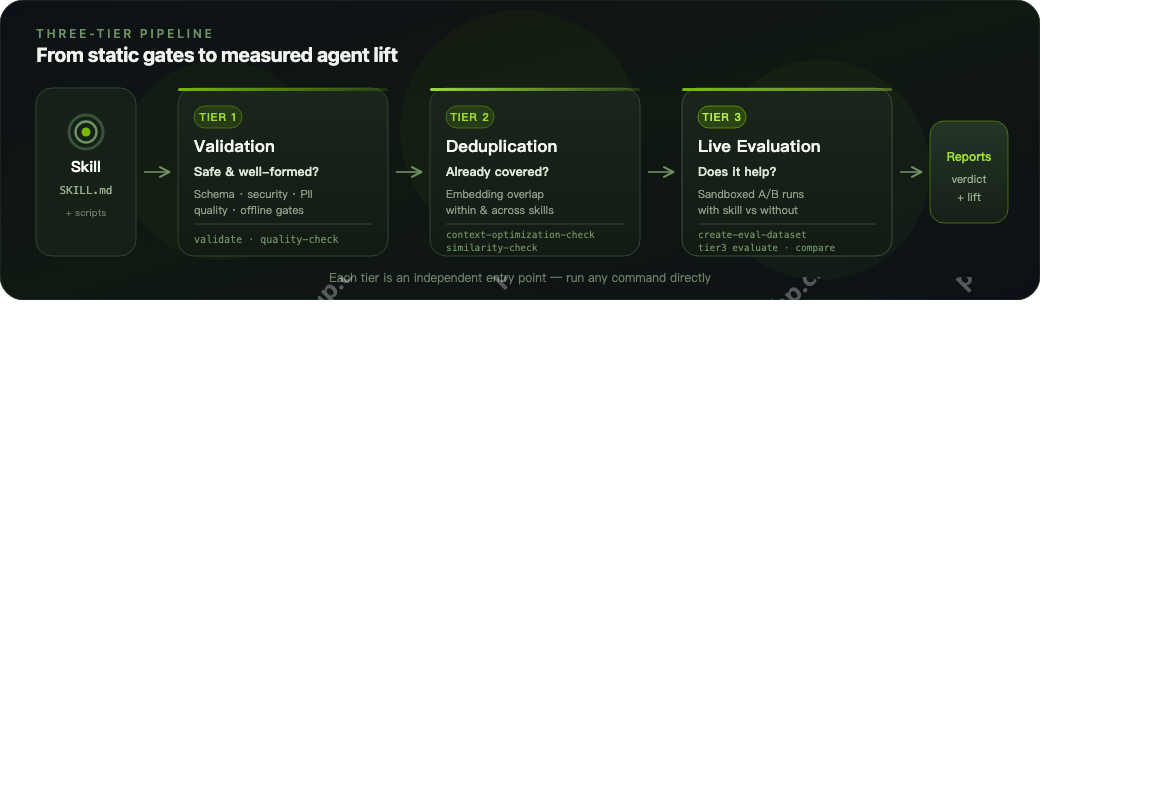
验证用例,再从一次小规模运行开始
下面的命令要在源码根目录下执行,前提是你准备的my-skill文件夹里已经放好了校验有效的evals测试数据集。此时Docker要处于启动状态,Codex能正常访问适配的模型服务,评估用的大模型也要按照对应服务商的要求提前配置好。第一次跑先选单个Agent、只做1次尝试,先把容器启动、结果文件生成的全流程走通,确认没有问题再继续。
docker info
uv run --python 3.13 --extra tier3 skillevaluator tier3 validate ./my-skill --strict
uv run --python 3.13 --extra tier3 skillevaluator tier3 evaluate ./my-skill --agents codex --env-mode docker --n-attempts 1 --grading-mode default
报告先看完整性,再看增益
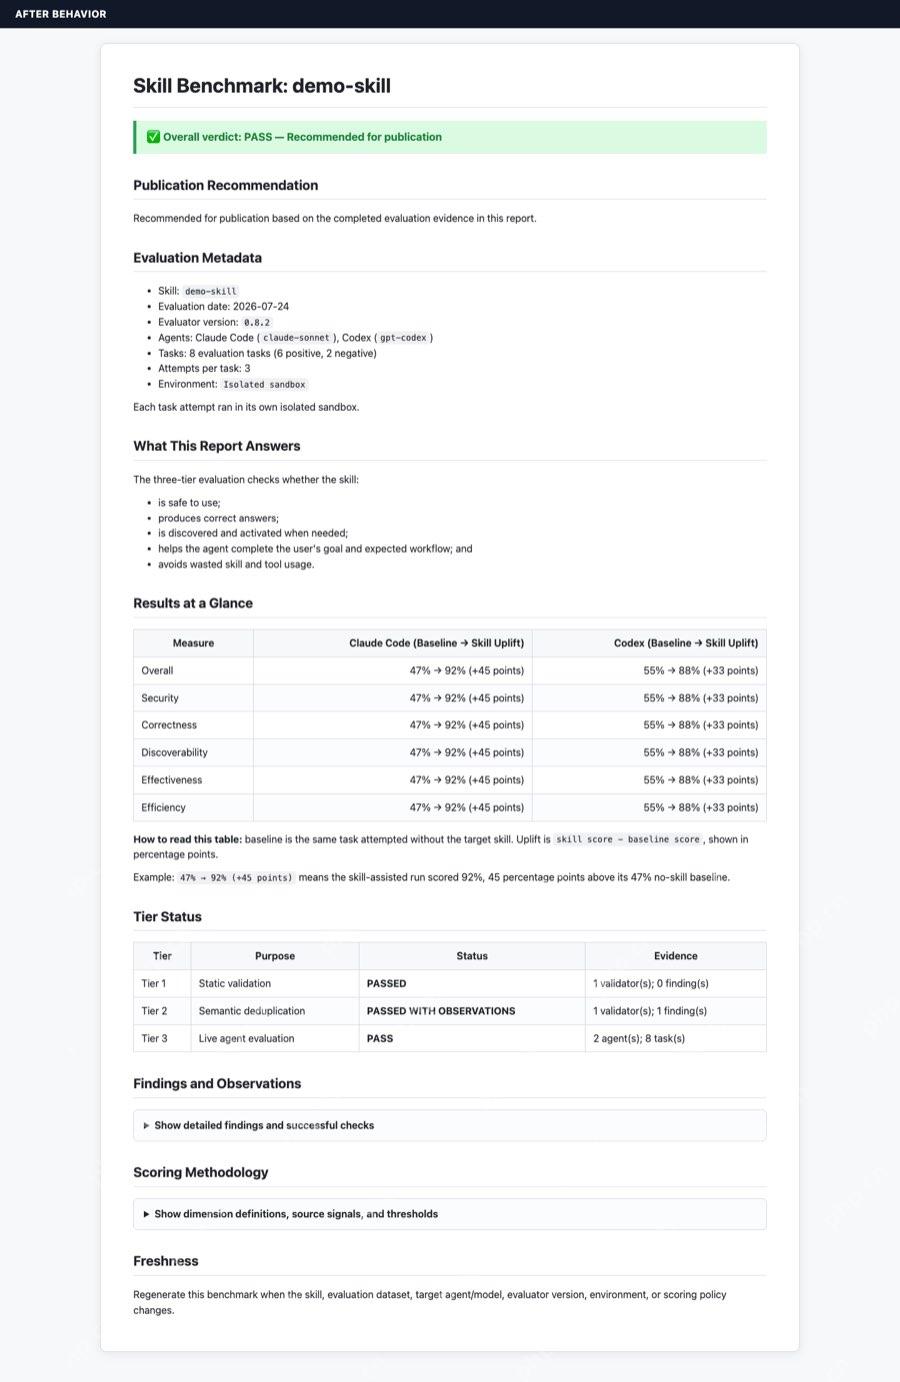
全部跑完之后,去对应技能目录下的evals/results文件夹里,找最新生成的带时间戳的子目录,里面的report.html、result.json、run_config.json三个文件都要检查一遍,确认有技能、无技能两组的运行记录都完整存在。只跑一轮只能用来验证流程通不通,最终的性能指标必须结合多任务测试、多次重复运行的结果一起解读才有效。

将来自 Marvis 或微信的可信远程软件开发请求中继至用户本地的 Codex CLI,等待编码任务完成,并返回经验证的结果。当用户通过 Codex 要求 Marvis 检查、实现、修复、测试、review 或继续在明确指定的本地项目目录中开展工作时,使用此功能。
技能没触发和任务失败怎么区分?
排查的时候先确认任务失败是不是模型鉴权失败、容器启动报错、运行超时这类通用问题导致的。等两组任务都完整跑完之后,再逐条核对每条任务的输出,区分到底是Agent输出结果本身出错,还是技能根本没被触发。如果所有装了技能的正向测试用例里,技能都完全没被触发,最终生成的报告里根本看不到技能带来的增益,这种情况先调整技能的加载路径,或者修改测试用例的触发条件,再用完全相同的配置重新跑一遍就行。