谷歌公布的gemini 4 neon评测表中,同一swe-sweep任务在antigravity框架下为39.0%,在mini-swe框架下为12.8%。两个数字的差异说明代理框架和执行条件会显著影响结果,不能只取较高值当作模型在任何编程环境中的统一能力,也不能直接换算成开发效率提升。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
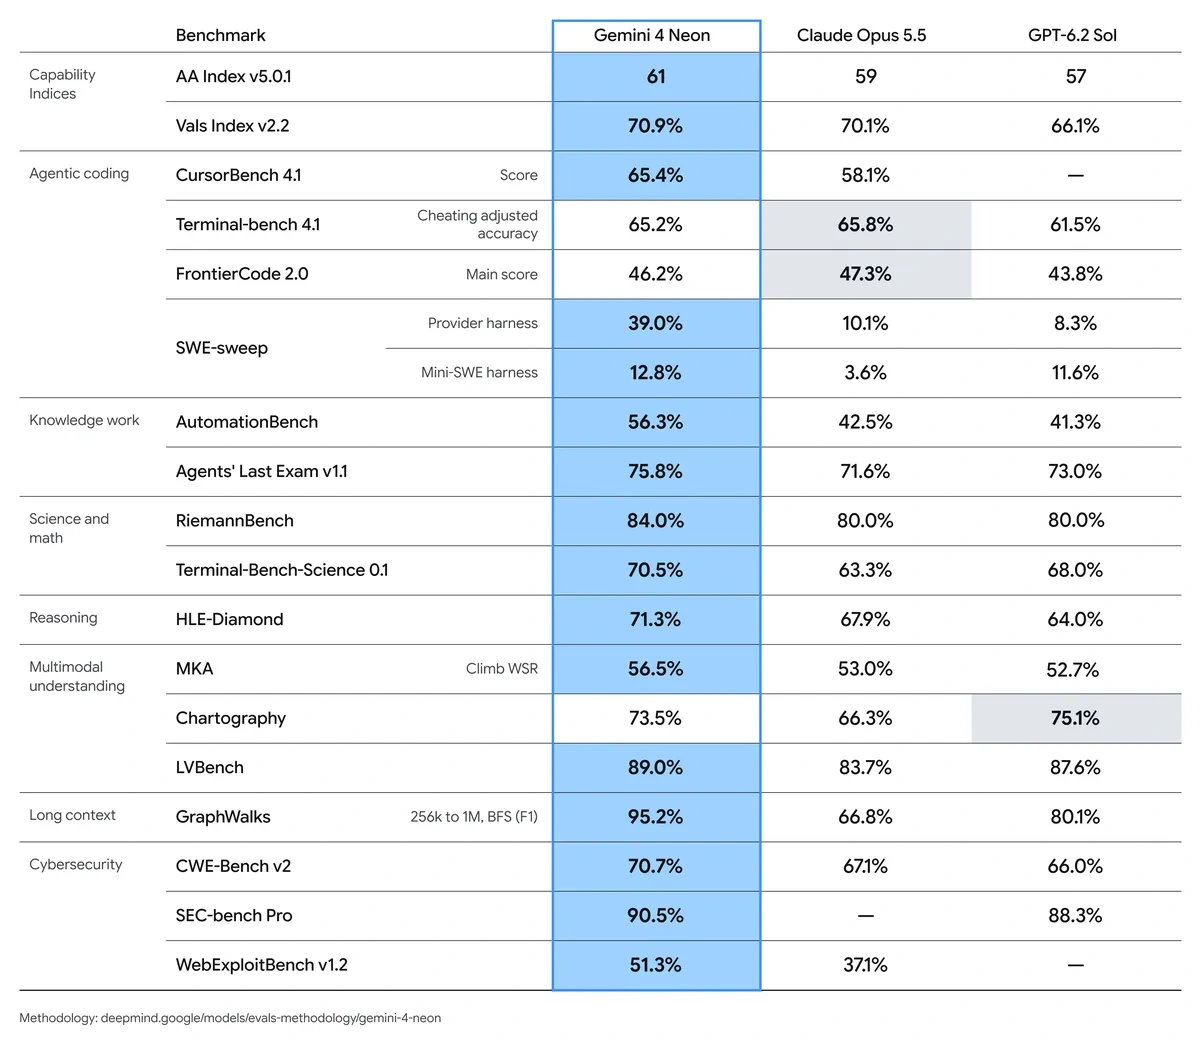
SWE-sweep分列提供方代理框架与Mini-SWE框架结果。
编程成绩不是一个通用百分比
官方还列出Terminal-bench 4.1的65.2%和FrontierCode 2.0主分数46.2%。这些基准的任务集合、评分规则和运行资源不同,应分别引用。模型卡补充了评测范围与条件,比较其他模型时也需要保证框架、工具权限和预算口径一致。

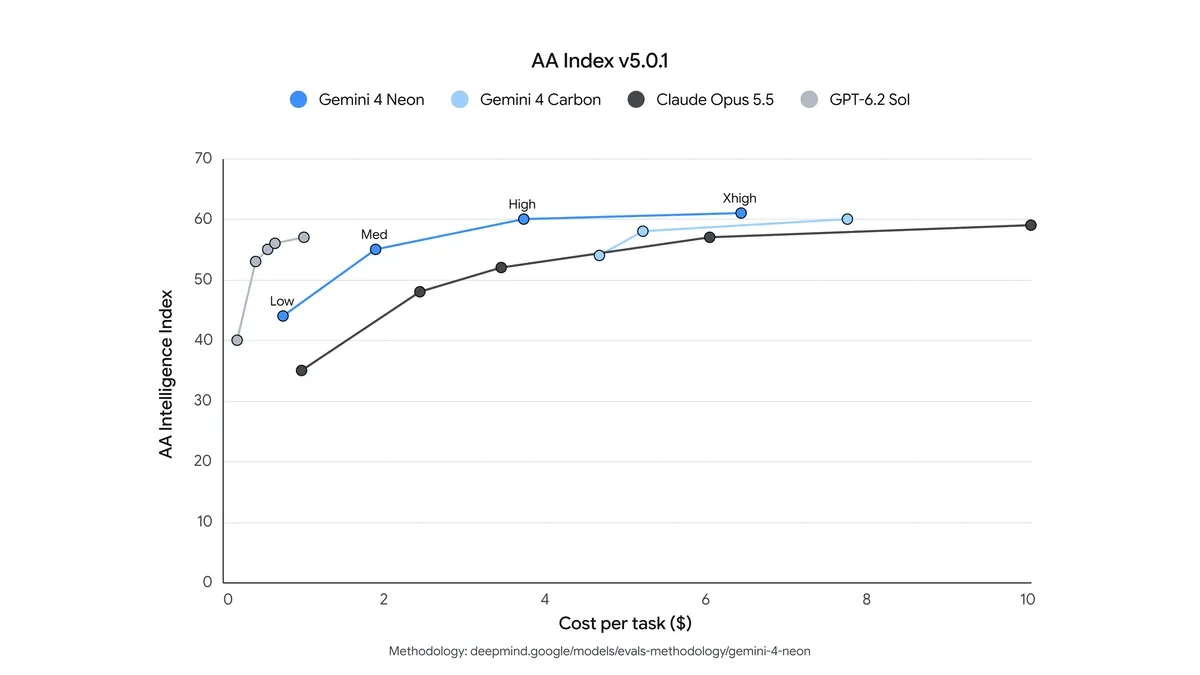
横轴为该评测的每任务成本,纵轴为AA Index;不同思考档位分别标记。
更高思考档位有预算代价
Neon默认high,也提供xhigh。官方能力与成本图显示不同档位处于不同位置,不能把xhigh成绩和低档成本混成一个结论。公告中相对Carbon的成本变化限定于所选评测,并不是对所有代码库的统一节省承诺。团队评估时应使用自己的任务集,同时记录成功标准、代理框架、重试次数和总调用成本,再决定是否替换现有方案。