








在java中通过编码注解传输标记字段,核心做法是使用spring框架的`@requestparam`、`@pathvariable`或`@requestbody`等注解,并配合`characterencodingfilter`确保请求体或查询参数的字符集(如utf-8)被正确解析。具体而言,需在web配置中注册过滤器以强制设置请求和响应的编码,同时在controller方法参数上直接标注对应注解,spring会自动将http请求中的字节流按指定编码解码为java字符串,从而避免乱码。
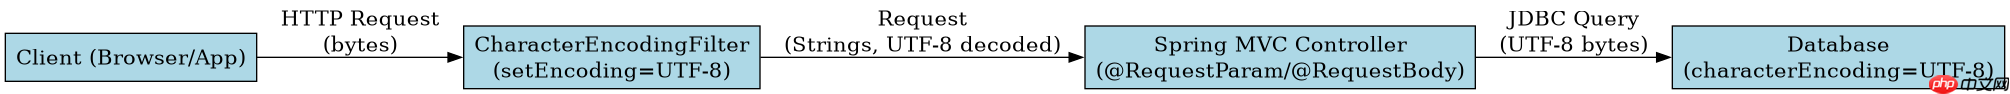
如何配置全局字符编码过滤器
要确保所有进入Spring应用的请求都使用UTF-8编码,最直接的方式是配置一个`CharacterEncodingFilter`。这个过滤器会拦截所有HTTP请求,强制调用`request.setCharacterEncoding("UTF-8")`和`response.setCharacterEncoding("UTF-8")`。这样,当Controller接收到数据时,底层字节流已经被正确转换为Unicode字符,后续的注解解析就不会出现乱码问题。
import org.springframework.boot.web.servlet.FilterRegistrationBean;
import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;
import org.springframework.web.filter.CharacterEncodingFilter;

@Configuration
public class WebConfig {
    @Bean
    public FilterRegistrationBean<CharacterEncodingFilter> encodingFilter() {
        FilterRegistrationBean<CharacterEncodingFilter> bean = new FilterRegistrationBean<>();
        CharacterEncodingFilter filter = new CharacterEncodingFilter();
        filter.setEncoding("UTF-8");
        filter.setForceEncoding(true); // 同时强制响应编码
        bean.setFilter(filter);
        bean.addUrlPatterns("/*");
        return bean;
    }
}
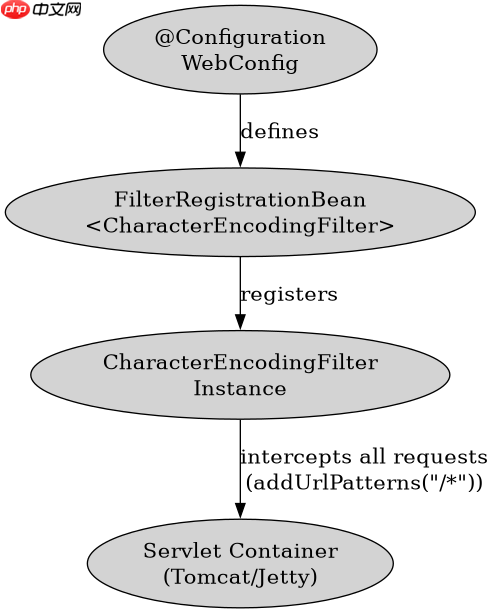
上述代码定义了一个`FilterRegistrationBean`,它将`CharacterEncodingFilter`注册到Servlet容器中。`setForceEncoding(true)`是关键,它确保不仅请求,响应输出也使用UTF-8。对于基于Spring Boot的应用,如果未自定义此过滤器,Spring Boot默认已启用UTF-8编码,但显式配置能确保在非Boot环境或特殊场景下的一致性。
立即学习“Java免费学习笔记(深入)”;

如何使用注解接收不同来源的标记字段
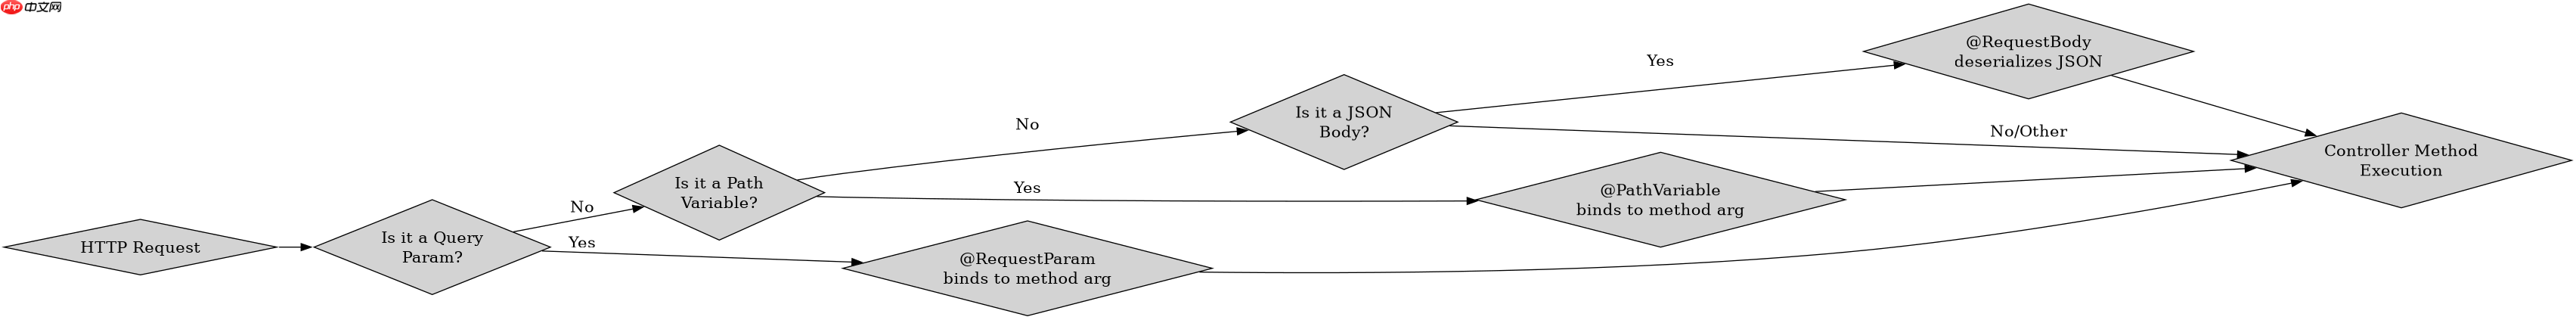
在控制器层,根据标记字段在HTTP请求中的位置,选择对应的注解进行绑定。如果是URL查询参数,使用`@RequestParam`;如果是路径变量,使用`@PathVariable`;如果是JSON请求体,使用`@RequestBody`。这些注解本身不处理编码,它们依赖底层的HttpMessageConverter或参数解析器,而后者依赖于前面配置的过滤器所设置的字符集。
import org.springframework.stereotype.Controller;
import org.springframework.web.bind.annotation.*;

@Controller
@RequestMapping("/api")
public class MarkedFieldController {

    // 处理查询参数: /api/test?tag=hello&value=world
    @GetMapping("/test")
    public String handleQuery(@RequestParam String tag, @RequestParam String value) {
        // tag和value已按UTF-8解码
        return "Tag: " + tag + ", Value: " + value;
    }

    // 处理路径变量: /api/path/special-tag
    @GetMapping("/path/{tag}")
    public String handlePath(@PathVariable String tag) {
        return "Path Tag: " + tag;
    }

    // 处理JSON请求体
    @PostMapping("/json")
    public String handleJson(@RequestBody MarkedData data) {
        return "Received: " + data.getTag();
    }
}

class MarkedData {
    private String tag;
    private String value;
    // getters and setters
}
在`handleQuery`方法中,`@RequestParam`直接从请求的参数Map中获取值,这些值在过滤器处理后已是正确的String。在`handleJson`方法中,`@RequestBody`使用`MappingJackson2HttpMessageConverter`(假设引入了Jackson)将JSON字符串反序列化为`MarkedData`对象。JSON解析器通常默认使用UTF-8,但如果底层请求流编码错误,这里也会出错。因此,全局过滤器是基础,注解是接口。
当标记字段包含特殊字符或Emoji时会发生什么
如果标记字段中包含非ASCII字符,如中文、Emoji或特殊符号,只要全局过滤器正确配置了UTF-8,且前端发送的请求头`Content-Type`或URL编码符合规范,后端就能完整接收。例如,发送`tag=%F0%9F%98%80`(UTF-8编码的?表情),后端`@RequestParam`接收到的将是正确的Unicode字符。若未配置过滤器或使用错误的编码(如ISO-8859-1),则会出现乱码或截断。
// 测试用例:验证特殊字符传输
@Test
public void testSpecialCharInTag() throws Exception {
    mockMvc.perform(get("/api/test")
            .param("tag", "\uD83D\uDE00") // Emoji UTF-16 surrogate pair in Java string
            .param("value", "test"))
        .andExpect(status().isOk())
        .andExpect(content().string(containsString("Tag: \uD83D\uDE00")));
}
// 注意:在HTTP传输中,Emoji会被编码为多字节UTF-8序列,如%E3%...%...
在实际开发中,需确保数据库连接URL也指定了`characterEncoding=UTF-8`,否则即使应用层正确接收,存入数据库时也可能因驱动默认编码不同而损坏。此外,前端JavaScript在发送请求时,`encodeURIComponent`函数会自动将特殊字符转为UTF-8百分号编码,与后端过滤器配合即可实现无损传输。



















