








非相关子查询只执行一次是因为它完全独立于外部查询,不依赖外部表的任何列,数据库优化器可以将其视为一个独立的静态数据集预先计算并缓存结果;而相关子查询的执行依赖于外部查询当前行的特定值,导致数据库必须为外部查询的每一行重新评估子查询的逻辑。这种差异源于两者对数据上下文的依赖关系不同:非相关子查询是“自包含”的,相关子查询则是“绑定”到外部游标的。
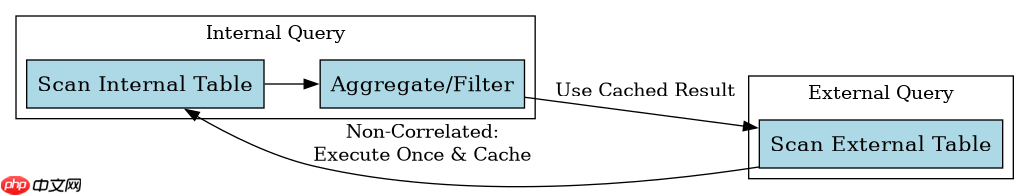
非相关子查询的执行流程是怎样的
非相关子查询在执行时,数据库引擎会先单独解析并执行内部的 SELECT 语句,生成一个临时的结果集(通常是一个虚拟表或集合),然后将这个结果集返回给外部查询进行过滤或连接操作。整个过程分为两个清晰的阶段:先算内部,再算外部。由于内部查询不引用外部表的字段,它的执行次数固定为一次,无论外部表有多少行数据。
SELECT * FROM employees
WHERE department_id IN (
    SELECT id FROM departments
    WHERE location = 'New York'
);
在这个例子中,子查询 SELECT id FROM departments WHERE location = 'New York' 首先被执行,假设返回了 [10, 20]。随后,外部查询使用这个固定的列表去筛选 employees 表。即使 employees 表有十万行,子查询也只会运行一次,结果被复用。
相关子查询为何需要多次执行
相关子查询在定义中包含了对外部查询表中列的引用,这使得子查询无法独立执行。数据库引擎必须采用嵌套循环的方式:对于外部查询返回的每一行,提取该行的关联列值,将其作为参数传递给子查询,然后执行子查询以获取针对该行有效的结果。因此,子查询的执行次数等于外部查询的结果行数(或在优化后接近该数量)。
SELECT e.name, e.salary
FROM employees e
WHERE salary > (
    SELECT AVG(salary)
    FROM employees
    WHERE department_id = e.department_id
);
在上述代码中,子查询计算的是每个员工所在部门的平均工资。因为 e.department_id 随外部行的变化而变化,所以每次处理不同的员工记录时,子查询都必须重新计算其对应部门的平均值。如果外部查询返回 1000 名员工,子查询理论上最多可能执行 1000 次(具体取决于数据库是否进行了半连接优化,但逻辑上它是逐行相关的)。
当外部表为空时相关子查询的行为是什么
当外部查询的结果集为空时,相关子查询将不会执行任何一次。因为相关子查询的执行驱动源是外部查询的行迭代器,如果没有行可供迭代,子查询体内的逻辑就没有触发点。这与非相关子查询形成对比,非相关子查询即使外部表为空,依然会执行一次以生成空集或常量集供外部查询处理(尽管最终结果仍为空)。















