








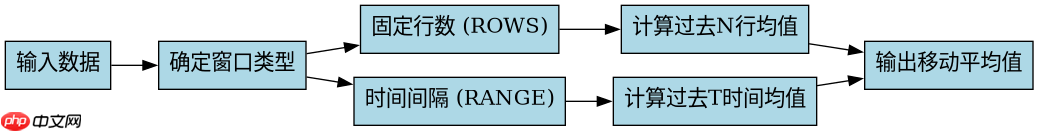
在sql中按时间段滑动聚合计算移动平均值,核心做法是使用窗口函数配合`rows between`或`range between`子句定义时间范围的滑动窗口。具体实现时,需确保时间列已排序,并根据业务需求选择基于固定行数(如过去3天)还是基于实际时间间隔(如过去24小时)来计算平均值。若使用`range`,需注意处理同一时间戳的多条记录以避免重复计算;若使用`rows`,则严格依赖物理行序。正确设置窗口边界后,数据库引擎会逐行动态计算指定时间范围内的均值。
如何基于固定行数计算移动平均
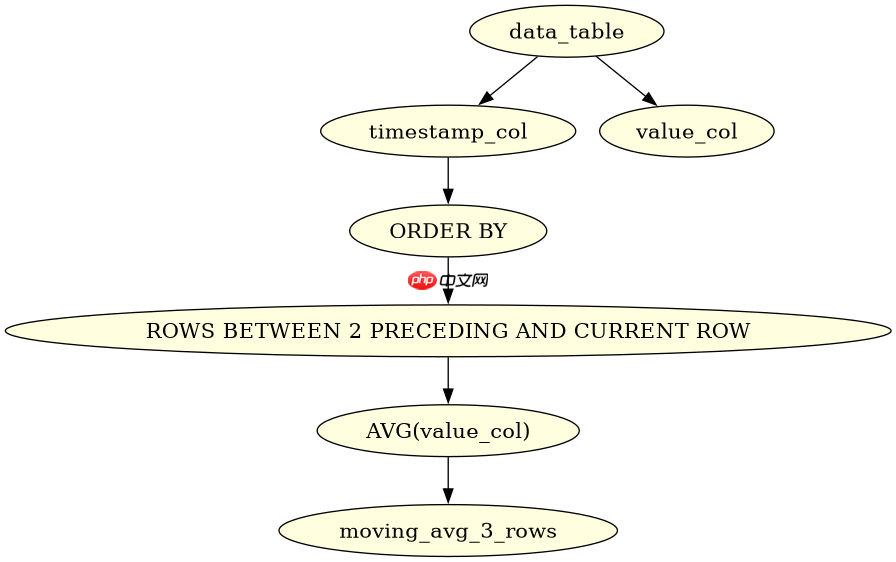
基于固定行数计算移动平均值是最常见的场景,适用于数据点密度均匀的情况。通过指定`ORDER BY`和`ROWS BETWEEN`子句,可以明确界定当前行及其前后若干行的范围。例如,计算过去两行加上当前行的平均值,只需设置`ROWS BETWEEN 2 PRECEDING AND CURRENT ROW`。这种方法执行效率高,因为不需要进行复杂的时间比较运算,但前提是数据必须按时间顺序连续插入且无缺失。
SELECT
    timestamp_col,
    value_col,
    AVG(value_col) OVER (
        ORDER BY timestamp_col
        ROWS BETWEEN 2 PRECEDING AND CURRENT ROW
    ) AS moving_avg_3_rows
FROM data_table
ORDER BY timestamp_col;
上述代码中,`AVG`函数作为窗口函数应用,`OVER`子句定义了窗口框架。`ROWS BETWEEN 2 PRECEDING AND CURRENT ROW`表示窗口包含当前行以及之前的两行,共三行数据。如果表中有少于三行的数据,窗口会自动调整为可用行数,不会报错。结果中的`moving_avg_3_rows`列即为每行对应的三行移动平均值。
如何基于实际时间间隔计算移动平均
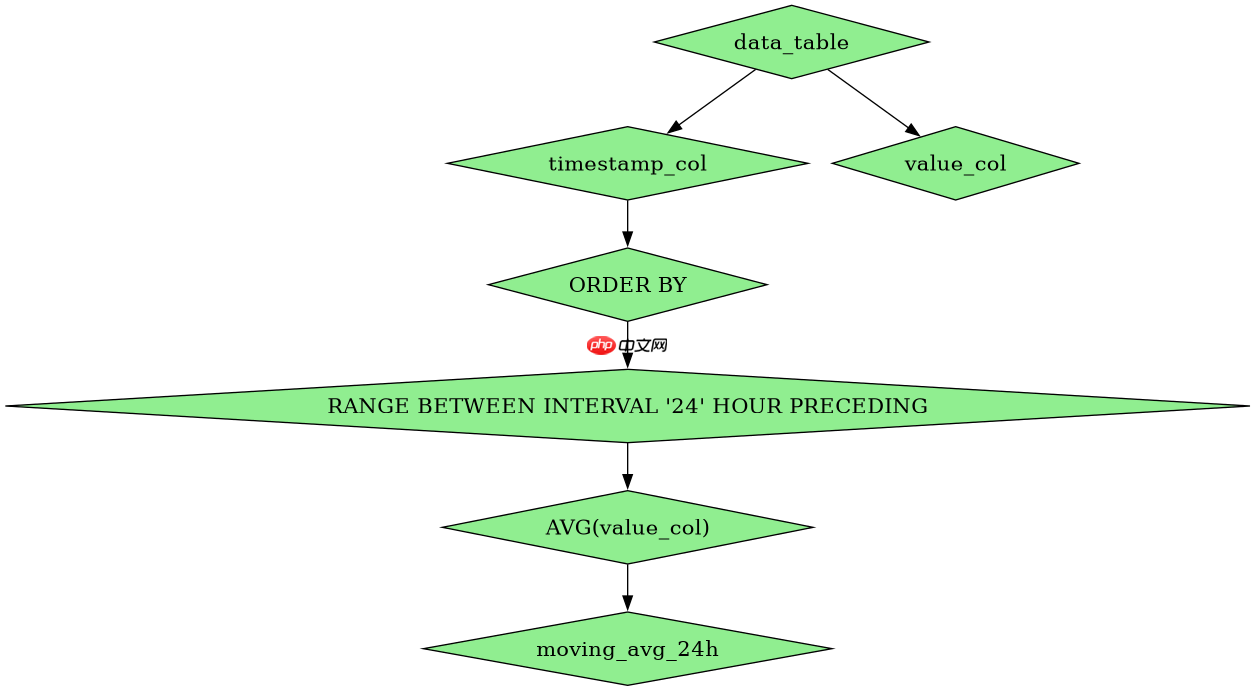
当数据点时间间隔不均匀时,基于固定行数的方法会导致统计偏差,此时应使用基于时间间隔的滑动窗口。通过`RANGE BETWEEN INTERVAL '24' HOUR PRECEDING AND CURRENT ROW`,可以精确计算过去24小时内所有数据的平均值。这种方法更贴合业务逻辑,能准确反映特定时间段内的趋势,但性能开销略大,因为需要比较每一行的时间值。此外,使用`RANGE`时,如果存在相同时间戳的多条记录,它们会被视为同一组一起纳入计算,这通常符合“时间段内”的语义。
SELECT
    timestamp_col,
    value_col,
    AVG(value_col) OVER (
        ORDER BY timestamp_col
        RANGE BETWEEN INTERVAL '24' HOUR PRECEDING AND CURRENT ROW
    ) AS moving_avg_24h
FROM data_table
ORDER BY timestamp_col;
在这段代码中,`RANGE`子句替代了`ROWS`,并使用了`INTERVAL`来定义时间跨度。`INTERVAL '24' HOUR PRECEDING`意味着从当前行的时间戳向前推24小时,这段时间内的所有记录都参与平均值的计算。需要注意的是,不同数据库对`INTERVAL`的支持程度不同,MySQL、PostgreSQL和Oracle等主流数据库均支持此语法,但具体写法可能略有差异。例如,在某些数据库中可能需要使用`TIMESTAMPADD`或类似函数来构建时间边界。
如何处理时间窗口内的空值或缺失数据
在实际应用中,时间窗口内可能存在空值(NULL)或缺失的数据点。默认情况下,`AVG`函数会自动忽略NULL值,只计算非空值的平均数。然而,如果希望将缺失数据视为0或填充前一个有效值,则需要预先处理数据。例如,可以使用`COALESCE`函数将NULL替换为0,或者使用`LAG`函数获取上一个有效值进行填充。此外,如果时间序列中存在较大的时间间隙,可能导致移动平均值波动剧烈,此时可以考虑插值法填补缺失数据,或使用加权平均来降低极端值的影响。关键在于根据业务场景决定如何处理这些异常数据,以确保移动平均值的准确性和稳定性。
















