








使用 exists 子查询配合 delete 是处理孤儿数据最高效且安全的方案,因为它能利用索引进行半连接(semi-join)优化,避免全表扫描和临时表开销。具体做法是在 delete 语句中通过 where not exists (select 1 from ...) 定位那些在关联表中找不到对应记录的父表行,数据库引擎会逐行检查存在性并直接删除匹配项,无需先计算差集再执行删除。
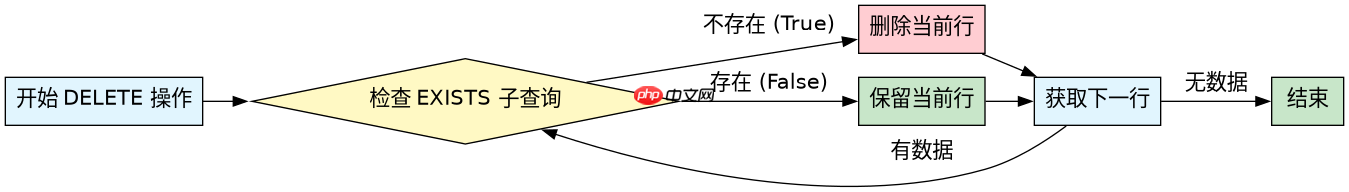
如何编写标准的NOT EXISTS删除语句
标准写法是将待删除的表作为主查询目标,在 WHERE 子句中嵌套一个引用该表的 SELECT 查询,若子查询返回空结果集则条件成立。例如删除 orders 表中没有对应 customers 记录的行,需确保两表通过外键关联字段进行比对,这种结构对大多数关系型数据库如 MySQL、PostgreSQL 均适用。
DELETE FROM orders
WHERE customer_id NOT IN (
    SELECT id FROM customers
);
-- 或者更推荐的 EXISTS 写法:
DELETE FROM orders o
WHERE NOT EXISTS (
    SELECT 1
    FROM customers c
    WHERE c.id = o.customer_id
);
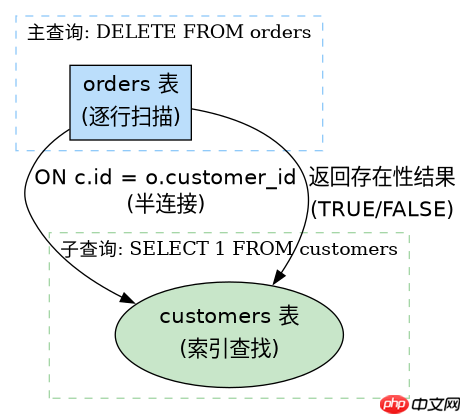
上述代码中,外层遍历 orders 的每一行,内层查询针对当前行的 customer_id 在 customers 表中查找是否存在 id 相等的记录。如果内层查询结果为空(即不存在),NOT EXISTS 为真,该行被标记删除。相比 NOT IN,EXISTS 不受 NULL 值干扰,且在大数据量下通常能更好地利用索引。
如何处理多表关联中的复杂孤儿数据
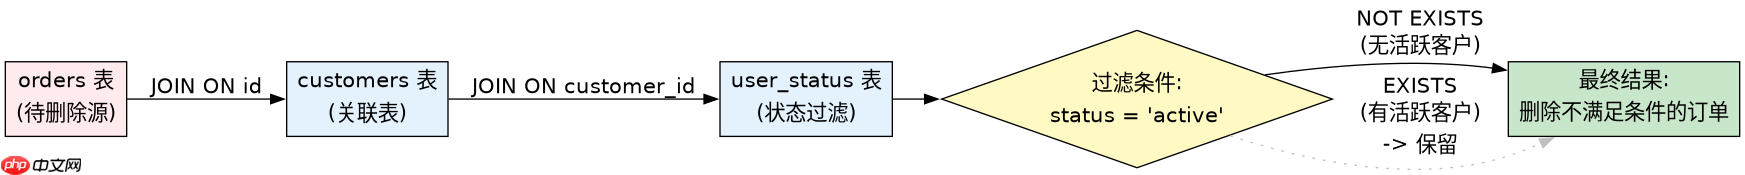
当孤儿数据的判断涉及多个关联表或复杂条件时,可以在 EXISTS 子查询中加入额外的过滤条件或连接逻辑。例如,不仅要检查客户是否存在,还要检查该客户是否处于“活跃”状态,此时只需在子查询的 WHERE 中添加状态判断即可,主 DELETE 语句结构保持不变,依然保持高效。
DELETE FROM orders o
WHERE NOT EXISTS (
    SELECT 1
    FROM customers c
    JOIN user_status s ON c.id = s.customer_id
    WHERE c.id = o.customer_id
      AND s.status = 'active'
);
在这个例子中,子查询不仅关联了 customers 和 user_status 表,还增加了 s.status = 'active' 的条件。只有当订单对应的客户存在且状态为活跃时,子查询才返回非空结果,NOT EXISTS 为假,订单保留;否则订单被删除。这种灵活性使得 EXISTS 能够适应复杂的业务逻辑筛选需求,同时维持良好的执行性能。
基于执行计划分析EXISTS的性能优势
在实际运行中,EXISTS 的执行计划通常显示为 NESTED LOOP ANTI JOIN 或类似的半连接操作,这意味着数据库引擎在找到第一个匹配的子查询记录后即可立即停止搜索当前行的子查询过程,从而大幅减少 I/O 和 CPU 消耗。相比之下,NOT IN 可能需要构建完整的子查询结果集并进行排序或哈希去重,尤其在子查询结果包含 NULL 时会导致逻辑错误或性能急剧下降。
-- 查看执行计划示例 (MySQL/PostgreSQL)
EXPLAIN DELETE FROM orders o
WHERE NOT EXISTS (
    SELECT 1 FROM customers c WHERE c.id = o.customer_id
);
通过 EXPLAIN 命令可以验证这一点,输出中应看到子查询部分使用了索引扫描(Index Scan)而非全表扫描(Seq Scan)。确保 customer_id 和 id 字段上有合适的索引,是保证 EXISTS 高效运行的关键。若无索引,数据库可能退化为低效的全表扫描,导致锁表时间过长甚至超时。


















