








在sql中实现分组并计算每个组内的中位数,核心思路是利用窗口函数对组内数据进行排序并分配行号,同时统计每组的总行数,然后筛选出位于中间位置的行进行聚合。具体做法是结合 rank() 或 row_number() 与 count(*) over(partition by ...),通过判断行号是否等于总行数的一半(奇数)或处于中间两个值之间(偶数),来提取中位数候选项,最后对这些候选项求平均值即可得到准确的中位数。

如何确定组内数据的排序位置与总数
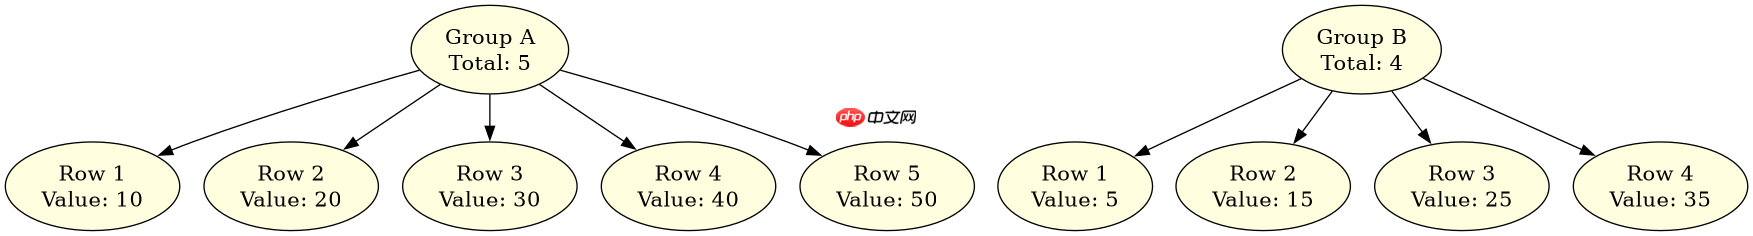
要计算中位数,首先需要明确每个数据点在组内的相对位置以及该组的规模。这可以通过窗口函数 ROW_NUMBER() 和 COUNT(*) OVER() 来实现。ROW_NUMBER() 为组内每一行按指定列排序后赋予唯一的序号,而 COUNT(*) OVER(PARTITION BY group_col) 则计算每个分组的总记录数。这两个值构成了后续筛选中位数的基础坐标。
WITH RankedData AS (
    SELECT
        group_id,
        value,
        ROW_NUMBER() OVER (PARTITION BY group_id ORDER BY value) as row_num,
        COUNT(*) OVER (PARTITION BY group_id) as total_count
    FROM my_table
)
SELECT * FROM RankedData;
上述查询返回了每个组内数据的排序位置和总数。例如,若某组有5条数据,行号分别为1到5,总数为5;若某组有6条数据,行号分别为1到6,总数为6。这些数据将用于下一步的逻辑判断。
如何筛选并计算最终的中位数值
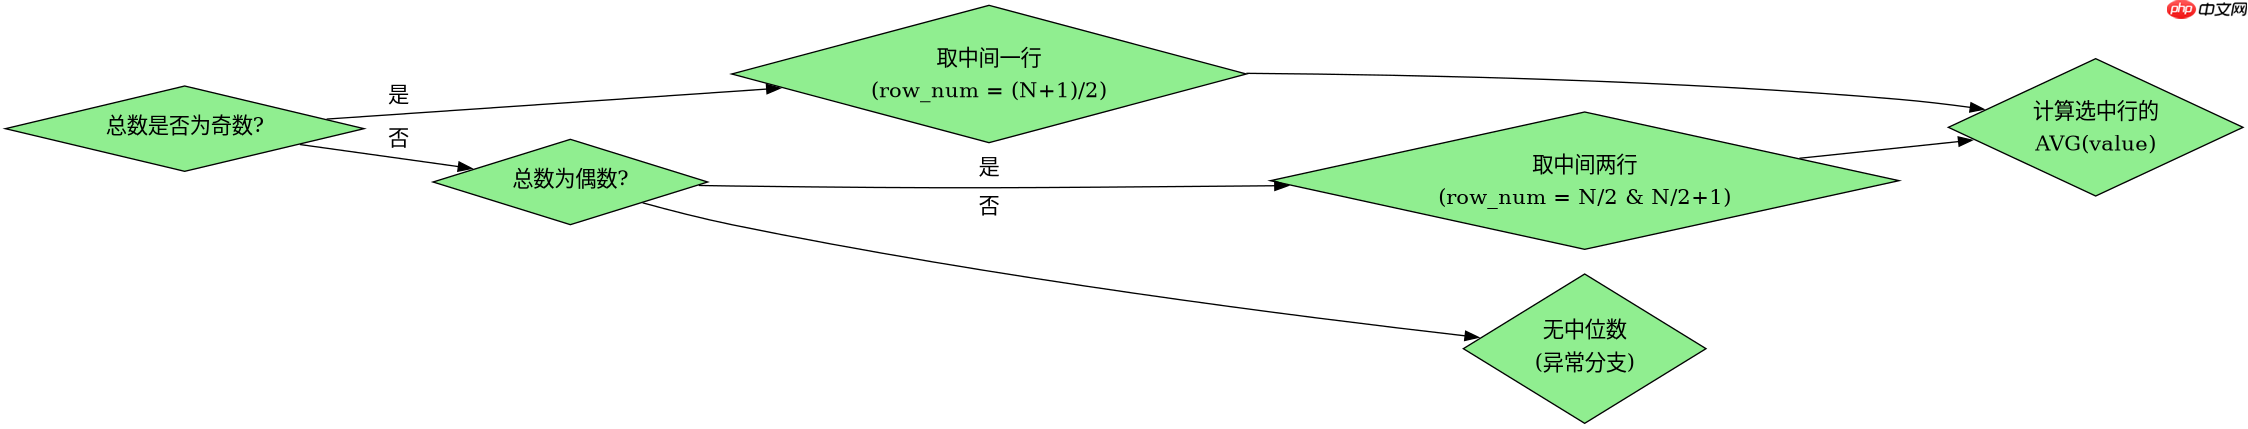
在获得行号和总数后,需要根据总数的奇偶性筛选出中位数对应的行。对于奇数个数据,中位数是第 (total_count + 1) / 2 行的值;对于偶数个数据,中位数是第 total_count / 2 和 total_count / 2 + 1 两行值的平均值。通过 CASE WHEN 语句可以精确匹配这些条件,并使用 Avg(value) 进行聚合,从而得出每组的中位数。
WITH RankedData AS (
    SELECT
        group_id,
        value,
        ROW_NUMBER() OVER (PARTITION BY group_id ORDER BY value) as row_num,
        COUNT(*) OVER (PARTITION BY group_id) as total_count
    FROM my_table
),
MedianCandidates AS (
    SELECT
        group_id,
        value,
        CASE
            WHEN total_count % 2 = 1 AND row_num = (total_count + 1) / 2 THEN 1
            WHEN total_count % 2 = 0 AND row_num IN (total_count / 2, total_count / 2 + 1) THEN 1
            ELSE 0
        END as is_median
    FROM RankedData
)
SELECT
    group_id,
    AVG(value) as median_value
FROM MedianCandidates
WHERE is_median = 1
GROUP BY group_id;
该查询首先构建候选集,仅保留符合中位数位置条件的行,然后按组聚合求平均。对于奇数行,只有一个候选值,平均值即为其本身;对于偶数行,有两个候选值,平均值即为两者的算术平均。这种方法兼容大多数支持窗口函数的现代SQL数据库(如PostgreSQL、MySQL 8.0+、SQL Server等)。
当组内存在重复值时中位数计算是否受影响
当组内存在重复值时,中位数的计算逻辑依然有效,因为排序是基于值的顺序而非唯一标识。如果多个行具有相同的值,它们的行号会根据 ORDER BY 的稳定排序规则依次分配,但筛选条件仅依赖行号与总数的关系,因此重复值不会导致逻辑错误。例如,若组内值为 [1, 2, 2, 3],总数为4,中位数应为第2和第3行的平均值,即 (2+2)/2=2,程序能正确识别并计算。


















