








oracle 11g rac实例重启导致长事务阻塞无法恢复,核心原因是rac环境下的全局锁管理器(global enqueue service, ges)在节点故障切换时,会强制终止该节点上所有未提交的事务并回滚,同时释放其持有的资源锁。如果其他正在等待这些资源的会话(即“长事务”的依赖方)未能正确感知或处理这种跨节点的锁状态变更,或者因为网络分区、缓存失效等原因导致锁请求超时或死锁检测机制触发异常,就会表现为阻塞无法恢复。具体做法是检查gv$lock和gv$session视图,确认是否存在因实例重启引发的全局锁争用或tm/tx锁的异常持有状态,并通过清理僵死的会话或调整初始化参数来缓解。
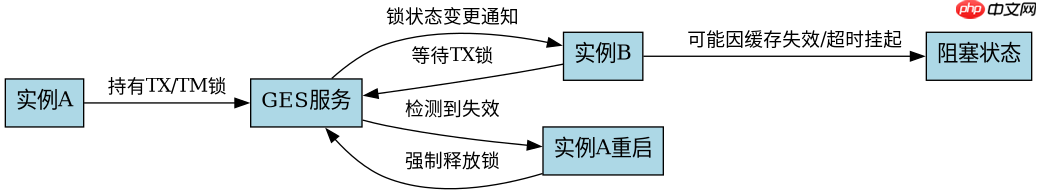
实例重启后全局锁GES的状态变化
当RAC中的一个实例重启时,Oracle集群件(Clusterware)会检测到该实例的失效,并启动故障转移流程。在这个过程中,全局 enqueue 服务(GES)负责协调所有实例间的资源锁。重启实例上的事务会被标记为失败,其持有的所有行级锁(TX锁)和表级锁(TM锁)会被强制释放。然而,其他实例上正在等待这些锁的会话可能会进入一种不确定的状态,特别是当它们已经获取了部分锁但尚未完成整个事务逻辑时。此时,如果等待队列中的会话尝试重新获取已被释放但可能已被其他会话占用的锁,就可能形成循环等待或长时间挂起。

SELECT inst_id, sid, serial#, username, status, event, wait_time
FROM gv$session
WHERE event LIKE 'enq: TX%'
   OR event LIKE 'library cache%'
   OR event LIKE 'row cache%';
-- 预期结果:查看是否有会话处于'waiting'状态且wait_time持续增加,event显示为TX锁等待或其他相关事件。
如何识别和解决由重启引起的阻塞会话
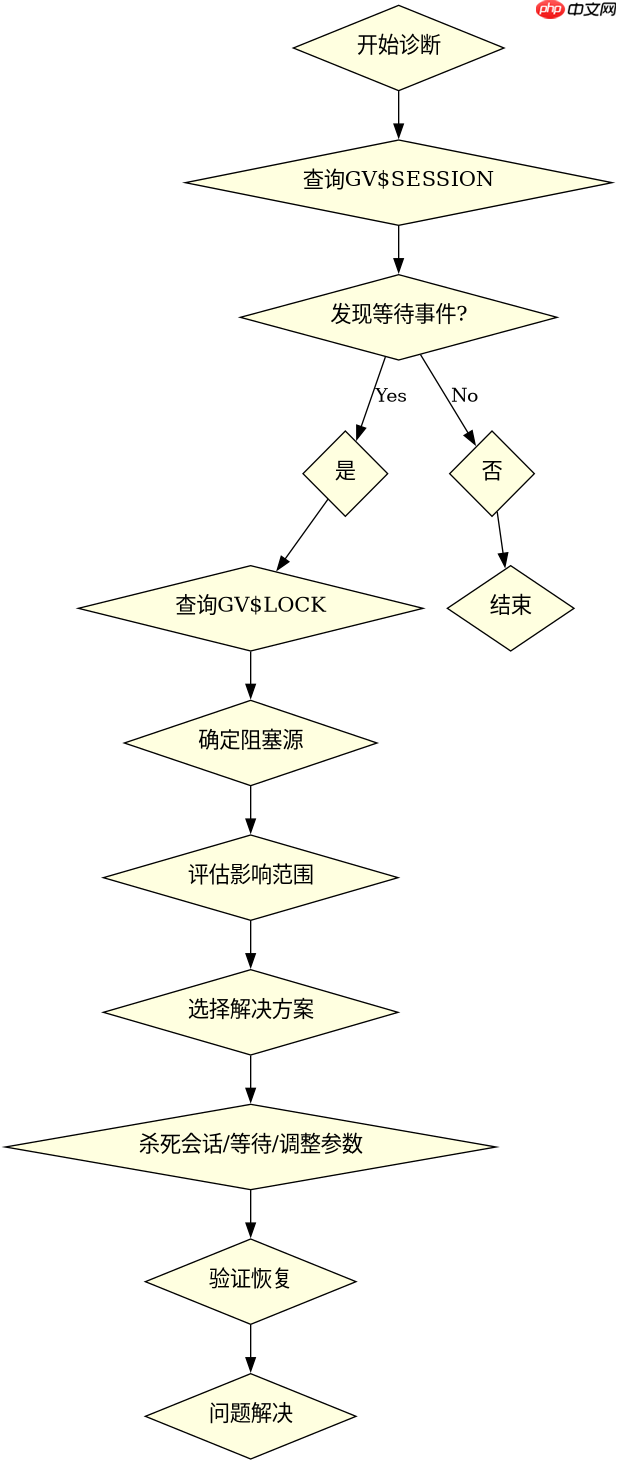
要解决因实例重启导致的长事务阻塞,首先需要识别出那些被阻塞的会话以及它们所等待的资源。可以通过查询GV$SESSION和GV$LOCK视图来获取这些信息。一旦确定了阻塞源,可以尝试以下几种方法:一是直接杀死阻塞的会话;二是如果是因为锁冲突,可以等待锁自动释放或手动干预;三是检查是否有应用层面的问题导致事务长时间未提交,从而加剧了阻塞情况。此外,还可以考虑调整Oracle的参数,如设置适当的超时时间或启用更严格的锁管理策略。
-- 查找阻塞其他会话的会话ID
SELECT blocking_session, sid, serial#
FROM gv$session
WHERE blocking_session IS NOT NULL;

-- 杀死阻塞会话(谨慎操作)
ALTER SYSTEM KILL SESSION 'sid,serial#' INSTANCES (inst_id);
-- 预期结果:阻塞会话被终止,等待它的会话应能继续执行或报错退出。
基于特定输入条件验证锁释放行为
为了验证实例重启后锁释放的行为是否符合预期,可以构造一个测试场景:在一个RAC环境中,创建一个长事务并在另一个实例上尝试访问相同的数据行。然后模拟第一个实例的重启,观察第二个实例上的会话是否会出现阻塞以及阻塞持续时间。通过这种方式,可以更直观地理解RAC环境下锁管理的复杂性,并为生产环境中的类似问题提供参考依据。




















