








在c#中将datatable高效写入oracle物理临时表,最佳实践是使用oracle提供的oraclebulkcopy类。通过实例化该类并设置destinationtablename属性指向具体的全局临时表名(如temp_data),调用writetoserver方法即可完成批量插入。这种方式利用了oracle的直连路径,避免了逐行执行的开销,能显著提升大数据量的写入性能。

如何配置OracleBulkCopy以适配临时表结构?
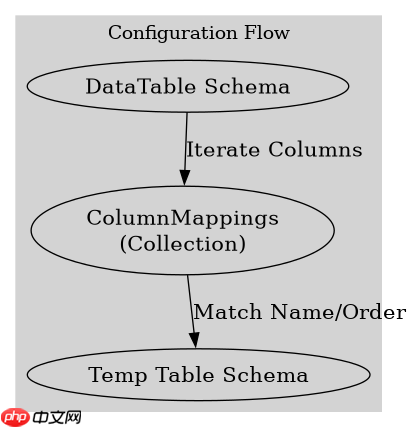
配置的核心在于确保内存中的DataTable列顺序与目标临时表的物理列顺序严格一致,并通过ColumnMappings进行显式映射。由于临时表通常用于存储中间结果,其结构可能在会话开始时由DDL定义,因此在代码中必须预先创建好该临时表。若列顺序不一致,OracleBulkCopy会抛出异常或导致数据错位,因此建议在使用前通过GetSchemaTable验证或手动指定映射关系。
using System;
using System.Data;
using Oracle.ManagedDataAccess.Client;

public class BulkInsertHelper
{
    public static void InsertToTempTable(OracleConnection conn, DataTable data)
    {
        // 假设临时表名为 TEMP_IMPORT_DATA
        using (var bulkCopy = new OracleBulkCopy(conn))
        {
            bulkCopy.DestinationTableName = "TEMP_IMPORT_DATA";

            // 显式映射列,防止顺序错误
            for (int i = 0; i < data.Columns.Count; i++)
            {
                bulkCopy.ColumnMappings.Add(data.Columns[i].ColumnName, data.Columns[i].ColumnName);
            }

            // 执行批量写入
            bulkCopy.WriteToServer(data);
        }
    }
}
上述代码展示了标准的写入流程。首先获取数据库连接,然后实例化OracleBulkCopy。关键点在于ColumnMappings的添加,它确保了DataTable的每一列都正确对应到临时表的字段。最后调用WriteToServer将数据推送到数据库。此操作应在事务外执行以获得最大吞吐量,或者在需要原子性时包裹在事务中,但需注意大事务可能带来的锁竞争。

如何处理大数据量下的内存与网络瓶颈?
当DataTable数据量极大时,一次性加载可能导致内存溢出或网络超时。解决策略是将数据分块处理,即每次只提交固定行数(如10,000行)的数据。通过循环遍历DataTable的行集合,提取子集生成新的DataTable或IEnumerable<datarow></datarow>,然后多次调用WriteToServer。此外,调整BatchSize属性可以控制每次网络往返的数据包大小,平衡内存占用与I/O效率。

public static void BatchInsertToTempTable(OracleConnection conn, DataTable fullData, int batchSize)
{
    int totalRows = fullData.Rows.Count;
    int processed = 0;

    while (processed < totalRows)
    {
        int currentBatchSize = Math.Min(batchSize, totalRows - processed);
        DataTable batchTable = fullData.Clone(); // 克隆结构

        for (int i = 0; i < currentBatchSize; i++)
        {
            batchTable.ImportRow(fullData.Rows[processed + i]);
        }

        using (var bulkCopy = new OracleBulkCopy(conn))
        {
            bulkCopy.DestinationTableName = "TEMP_IMPORT_DATA";
            bulkCopy.BatchSize = currentBatchSize;

            // 重新映射列
            for (int i = 0; i < batchTable.Columns.Count; i++)
            {
                bulkCopy.ColumnMappings.Add(batchTable.Columns[i].ColumnName, batchTable.Columns[i].ColumnName);
            }

            bulkCopy.WriteToServer(batchTable);
        }

        processed += currentBatchSize;
    }
}
这段代码实现了分块写入逻辑。它首先克隆DataTable的结构,然后在循环中导入指定数量的行。每次迭代都创建一个新的OracleBulkCopy实例并执行写入。这种方法有效控制了单次操作的内存峰值。需要注意的是,频繁创建对象可能带来轻微的性能损耗,但在处理百万级数据时,这种权衡是必要的。同时,确保临时表在会话期间存在,且没有并发写入冲突。
写入完成后临时表数据何时清除?
Oracle物理临时表的数据清除机制取决于表的定义类型。如果是ON COMMIT DELETE ROWS类型的临时表,数据会在每次事务提交(Commit)后自动清空;如果是ON COMMIT PRESERVE ROWS类型,数据则保留直到会话结束(Session End)或显式截断。在OracleBulkCopy场景中,如果未包裹在显式事务中,默认行为类似于自动提交,因此使用DELETE ROWS类型的临时表需格外小心,可能导致数据在预期时间前被清除。最佳做法是使用PRESERVE ROWS并在业务逻辑结束后显式执行TRUNCATE TABLE或关闭连接来清理资源。



















