








在oracle中利用dbms_parallel_execute并行切分大表更新,核心做法是调用该包将大表按rowid或主键范围切分为多个chunk(块),然后注册一个包含update语句的process procedure,最后通过run_process启动并行执行。具体步骤包括创建任务、定义切分方式、编写处理过程、设置并发度并运行任务,最终实现高效的大规模数据更新。

如何定义CHUNK切分策略
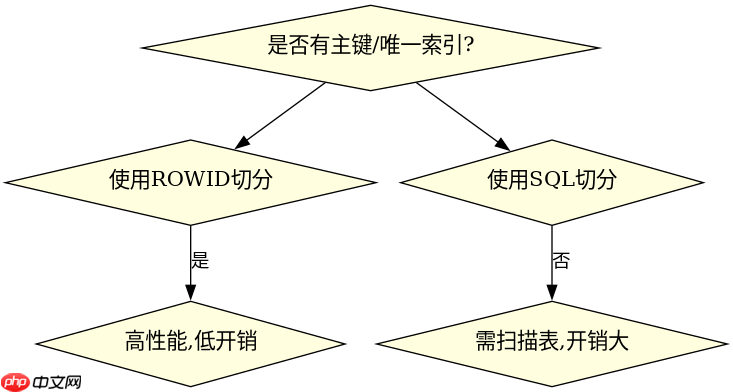
定义CHUNK切分策略时,需选择基于ROWID还是SQL查询进行切分。对于有主键或唯一索引的大表,推荐使用ROWID切分,因为它性能更高且无需额外扫描;若无合适索引,则可使用SQL切分,但需注意其开销较大。切分粒度由CHUNK_SIZE参数控制,通常建议设置为几千到几万行,以平衡并行效率与锁竞争。
-- 假设表名为LARGE_TABLE,主键为ID
BEGIN
  DBMS_PARALLEL_EXECUTE.CREATE_TASK('UPDATE_LARGE_TABLE');

  -- 使用ROWID切分,每块约10000行
  DBMS_PARALLEL_EXECUTE.CREATE_CHUNKS_BY_ROWID(
    task_name   => 'UPDATE_LARGE_TABLE',
    owner_name  => USER,
    table_name  => 'LARGE_TABLE',
    by_row      => TRUE,
    chunk_size  => 10000
  );

  COMMIT;
END;
/
上述代码创建了名为UPDATE_LARGE_TABLE的任务,并按ROWID将LARGE_TABLE切分为多个块,每块约10000行。执行后,可通过查询USER_PARALLEL_EXECUTE_CHUNKS视图查看生成的CHUNK信息。

如何编写并注册PROCESS过程
编写PROCESS过程时,需创建一个存储过程,接收START_ROWID和END_ROWID作为参数,用于限定当前CHUNK的范围。在该过程中执行具体的UPDATE语句,并提交事务。注册过程时,需指定PROCESS名称及是否允许重试。若更新逻辑复杂,可结合异常处理机制确保部分失败不影响整体任务。

-- 创建PROCESS过程
CREATE OR REPLACE PROCEDURE UPDATE_CHUNK_PROC(
  start_rowid IN ROWID,
  end_rowid   IN ROWID
) AS
BEGIN
  UPDATE LARGE_TABLE
  SET STATUS = 'UPDATED'
  WHERE ROWID BETWEEN start_rowid AND end_rowid;

  COMMIT;
EXCEPTION
  WHEN OTHERS THEN
    ROLLBACK;
    RAISE;
END;
/

-- 注册PROCESS
BEGIN
  DBMS_PARALLEL_EXECUTE.RUN_PROCESS(
    task_name     => 'UPDATE_LARGE_TABLE',
    process_name  => 'UPDATE_CHUNK_PROC',
    sql_stmt      => NULL, -- 使用已注册的PROCEDURE
    parallel_level => 4 -- 设置4个并行进程
  );
END;
/
上述代码定义了UPDATE_CHUNK_PROC过程,并在其中执行针对特定ROWID范围的UPDATE操作。随后通过RUN_PROCESS启动任务,设置并行级别为4,系统会自动分配CHUNK给各个并行进程执行。若某CHUNK更新失败,可根据业务需求配置重试机制。
如何监控任务执行状态
监控任务执行状态时,可通过查询USER_PARALLEL_EXECUTE_TASKS和USER_PARALLEL_EXECUTE_CHUNKS视图获取任务进度、CHUNK状态及错误信息。若发现某些CHUNK长时间未完成或报错,可手动干预,如调整并行度或重新执行失败CHUNK。此外,DBMS_PARALLEL_EXECUTE提供STATUS函数,可直接返回任务当前状态,便于集成到监控脚本中。




















