








使用 java 处理批量编码转换,核心做法是读取源文件字节流,根据目标编码重新构建字符串,再按新编码写回。具体实现时,通过 files.readallbytes() 获取原始数据,利用 new string(bytes, sourcecharset) 解码,再用 standardcharsets.utf_8 等指定编码进行 files.write() 输出。若遇到乱码,通常是因为源文件编码识别错误,需手动指定或尝试多编码检测。

如何遍历目录并筛选特定后缀的文件
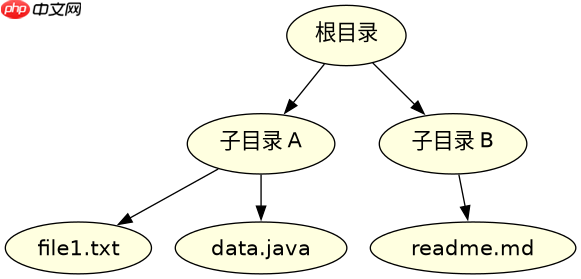
批量处理的第一步是定位文件。Java 8 引入了 NIO.2 API,其中 Files.walk() 可以递归遍历目录树。结合 PathMatcher 或简单的 String.endsWith() 判断,可以精准筛选出需要转换的文本文件(如 .txt, .java)。这一步确保了后续转换只作用于目标文件,避免误改二进制文件。
import java.io.IOException;
import java.nio.file.*;
import java.nio.charset.StandardCharsets;
import java.util.stream.Stream;

public class FileWalker {
    public static void main(String[] args) throws IOException {
        Path startDir = Paths.get("./src");
        // 使用 walk 遍历,限制深度为无限,过滤仅包含 .txt 文件
        try (Stream<Path> paths = Files.walk(startDir)) {
            paths.filter(Files::isRegularFile)
                 .filter(p -> p.toString().endsWith(".txt"))
                 .forEach(FileWalker::convertFile);
        }
    }
}
上述代码中,Files.walk() 返回一个 Stream<path></path>。通过 filter 链式调用,先排除目录,再排除非目标后缀的文件。最终 forEach 将每个匹配的路径传递给转换逻辑。这种流式处理方式内存友好,适合大目录遍历。
立即学习“Java免费学习笔记(深入)”;

如何安全地执行读写与异常处理
在确定文件后,实际转换过程必须处理 I/O 异常和字符集映射问题。推荐使用 try-with-resources 确保流关闭,但在 NIO.2 中,Files.readAllBytes 和 Files.write 是原子性操作,无需显式管理流对象。关键在于捕获 IOException 和 MalformedInputException。如果源文件包含无法解码的非法字节序列,直接转换会抛出异常,导致整个批处理中断。因此,需要在循环中加入异常捕获,记录失败文件并继续处理其余文件。
import java.io.IOException;
import java.nio.charset.Charset;
import java.nio.charset.StandardCharsets;
import java.nio.file.Files;
import java.nio.file.Path;
import java.nio.file.Paths;

public class EncoderConverter {
    private static final Charset SOURCE_CHARSET = Charset.forName("GBK");
    private static final Charset TARGET_CHARSET = StandardCharsets.UTF_8;

    public static void convertFile(Path path) {
        try {
            byte[] bytes = Files.readAllBytes(path);
            // 关键步骤:用源编码解码,用目标编码编码
            String content = new String(bytes, SOURCE_CHARSET);
            byte[] newBytes = content.getBytes(TARGET_CHARSET);

            // 覆盖原文件
            Files.write(path, newBytes);
            System.out.println("Converted: " + path);
        } catch (IOException e) {
            System.err.println("Failed to convert " + path + ": " + e.getMessage());
        }
    }
}
这段代码展示了完整的转换逻辑。new String(bytes, SOURCE_CHARSET) 是将字节数组解析为 Java 内部 Unicode 字符串的关键。如果源编码设置错误(例如 GBK 文件误用 UTF-8 解码),生成的字符串将包含乱码字符,后续写入 UTF-8 也会保留这些乱码。因此,准确识别源编码是批量转换成功的前提。对于未知编码的文件,可引入 juniversalchardet 等库进行自动探测,但会增加复杂度。
当源文件编码未知且存在混合编码时如何处理
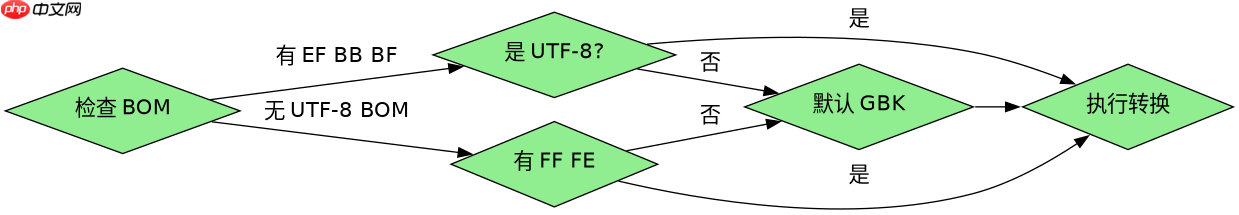
在实际项目中,最棘手的问题是源文件编码不统一。有些文件可能是 UTF-8,有些是 GBK,甚至同一目录下存在混合情况。此时,硬编码 SOURCE_CHARSET 会导致部分文件转换失败或产生乱码。解决策略是先尝试检测编码,若检测失败则回退到默认编码。可以使用 Apache Commons IO 的 CharsetUtils 或 ICU4J 的 UniversalDetector 来猜测编码。以下代码演示了基于简单启发式规则的检测与转换流程:
import java.io.IOException;
import java.nio.charset.Charset;
import java.nio.charset.StandardCharsets;
import java.nio.file.Files;
import java.nio.file.Path;
import java.util.Arrays;

public class SmartConverter {
    public static void convertWithDetection(Path path) {
        try {
            byte[] bytes = Files.readAllBytes(path);
            Charset detected = detectEncoding(bytes);
            String content = new String(bytes, detected);
            Files.write(path, content.getBytes(StandardCharsets.UTF_8));
        } catch (IOException e) {
            e.printStackTrace();
        }
    }

    private static Charset detectEncoding(byte[] bytes) {
        // 简单启发式:检查 BOM
        if (bytes.length > 3 && bytes[0] == (byte)0xEF && bytes[1] == (byte)0xBB && bytes[2] == (byte)0xBF) {
            return StandardCharsets.UTF_8;
        }
        if (bytes.length > 2 && bytes[0] == (byte)0xFF && bytes[1] == (byte)0xFE) {
            return StandardCharsets.UTF_16LE;
        }
        // 若无 BOM,默认假设 GBK(针对中文环境常见情况)
        // 生产环境建议集成 juniversalchardet
        return Charset.forName("GBK");
    }
}
该方案通过检查文件头部的 BOM(Byte Order Mark)来快速识别 UTF-8 或 UTF-16 编码。如果没有 BOM,则根据业务场景设定默认编码(如中文项目常默认为 GBK)。虽然这不是 100% 准确的方法,但对于大多数批量转换场景已足够。若需更高精度,应替换 detectEncoding 方法中的逻辑,调用专业的编码检测库。注意,编码检测本身也有误差率,因此在自动化脚本中,建议先备份原文件,并在测试环境中验证转换结果。


















