








使用 fetch 发起请求时,必须将 responsetype 设置为 arraybuffer 或 blob,以防止浏览器自动解析 json 导致二进制数据损坏。获取到原始字节后,通过 xlsx.read 函数配合 type: 'array' 参数即可将数据还原为工作簿对象。

如何配置 fetch 以正确接收二进制流
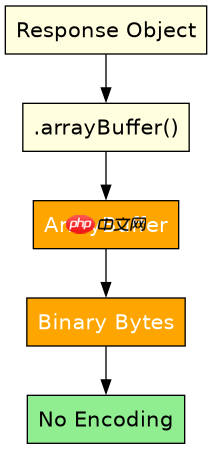
直接调用 .json() 会报错,因为 XLSX 文件不是文本格式。正确的做法是调用 .arrayBuffer() 方法,它会将响应体作为二进制缓冲区返回,保持数据的完整性。
const url = '/api/export.xlsx';

fetch(url)
  .then(response => {
    if (!response.ok) throw new Error('Network error');
    return response.arrayBuffer();
  })
  .then(data => {
    // data 是 ArrayBuffer 类型
    console.log(data.byteLength);
  });
上述代码展示了最基础的获取方式。关键在于 response.arrayBuffer() 这一步,它确保了从服务器到客户端的传输过程中,字节序列没有被编码转换破坏。如果接口返回的是 Blob 类型,也可以直接使用 response.blob(),后续处理逻辑类似。
立即学习“Java免费学习笔记(深入)”;

如何将 Buffer 转换为 Excel 工作簿对象
拿到 ArrayBuffer 后,需要借助 SheetJS (xlsx) 库进行解析。调用 XLSX.read(data, { type: 'array' }) 即可生成 workbook 对象。该对象包含所有 sheet 的名称和数据结构,方便进一步提取单元格内容。

import * as XLSX from 'xlsx';

async function loadExcel() {
  const response = await fetch('/api/data.xlsx');
  const buffer = await response.arrayBuffer();

  const workbook = XLSX.read(buffer, { type: 'array' });
  const firstSheetName = workbook.SheetNames[0];
  const worksheet = workbook.Sheets[firstSheetName];

  // 转换为 JSON 数组以便查看
  const jsonData = XLSX.utils.sheet_to_json(worksheet);
  console.log(jsonData);
}
这里使用了 sheet_to_json 辅助函数将内部结构转为通用的 JavaScript 对象数组,这是最常用的后续处理方式。如果只需要特定单元格,可以直接通过 worksheet['A1'] 访问。整个过程无需后端特殊配置,只要 MIME 类型正确(通常为 application/vnd.openxmlformats-officedocument.spreadsheetml.sheet),前端即可独立处理。
如何处理大文件导致的内存溢出问题
当 XLSX 文件体积超过几十 MB 时,一次性加载到内存可能导致页面卡顿或崩溃。此时应改用流式读取或分片处理。虽然 SheetJS 核心库主要面向全量解析,但可以通过限制解析范围或使用 worker 线程来缓解主线程压力。对于超大数据,建议后端改为 CSV 格式或提供分页下载接口。

















