








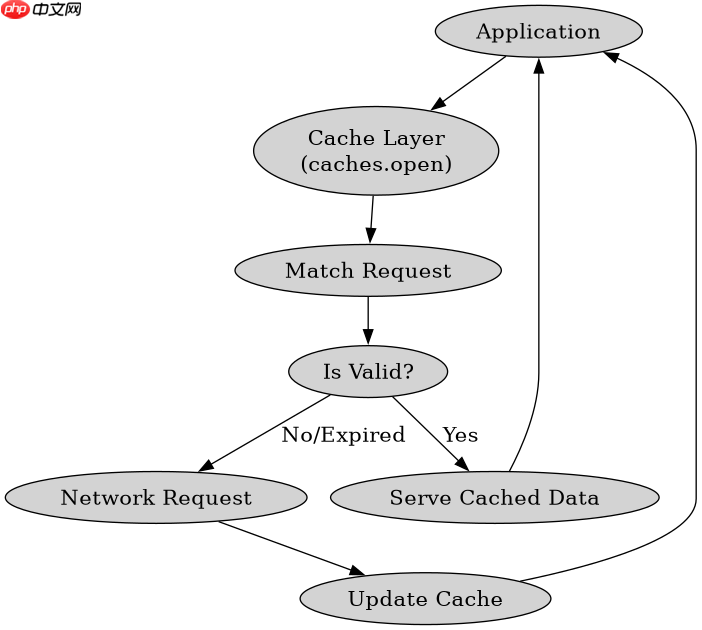
通过拦截 fetch 请求并结合 cachestorage api,可以在网络请求前后自动实现离线缓存。具体做法是封装一个自定义函数,在发起请求前检查缓存是否存在且未过期,若存在则直接返回缓存数据;若不存在或已失效,则发起网络请求并将响应写入缓存,同时返回响应数据。

如何判断缓存是否有效并优先使用
在请求发出前,调用 caches.open() 获取缓存实例,并使用 cache.match() 查找对应的请求记录。如果匹配到结果,需进一步验证其有效性(如检查时间戳或版本号),确认无误后直接构造 Response 对象返回,从而跳过网络 I/O。
async function fetchWithCache(url, options = {}) {
  const cacheName = 'api-cache-v1';
  const cache = await caches.open(cacheName);

  // 1. 尝试从缓存中获取
  const cachedResponse = await cache.match(url);
  if (cachedResponse) {
    console.log('Serving from cache');
    return cachedResponse;
  }

  // 2. 缓存未命中,发起网络请求
  try {
    const networkResponse = await fetch(url, options);

    // 3. 克隆响应并存入缓存(因为响应体只能消费一次)
    if (networkResponse.ok) {
      const clonedResponse = networkResponse.clone();
      await cache.put(url, clonedResponse);
    }

    return networkResponse;
  } catch (error) {
    console.error('Network error:', error);
    throw error;
  }
}
上述代码展示了完整的拦截逻辑。首先打开名为 api-cache-v1 的缓存空间。接着尝试匹配 URL,如果找到缓存,直接返回。如果没找到,则执行正常的 fetch 请求。关键在于,只有当网络请求成功(ok 为 true)时,才将响应的克隆体存入缓存。这样既保证了数据的可用性,又避免了因错误响应污染缓存。
立即学习“Java免费学习笔记(深入)”;
如何处理缓存过期与更新策略
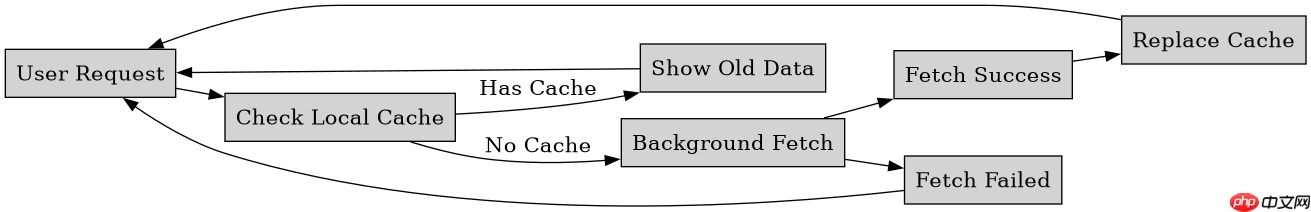
简单的缓存匹配无法处理数据时效性问题。为了实现更精细的控制,可以在存储时附带元数据,或在请求头中设置 Cache-Control。在实际开发中,通常采用“后台更新”或“强制刷新”策略。这里演示一种基于时间戳的简单过期机制:在缓存键中嵌入时间戳,或者在读取时检查存储的额外信息。

// 增强版:带过期时间的缓存
const CACHE_TTL = 5 * 60 * 1000; // 5分钟

async function fetchWithTTL(url) {
  const cache = await caches.open('api-ttl-cache');
  const request = new Request(url);
  const cached = await cache.match(request);

  if (cached) {
    // 假设我们在缓存的 metadata 中存了时间戳
    // 实际项目中可能需要单独存储 metadata 或使用 Service Worker 的 waitUntil
    // 这里简化处理:如果缓存存在,先返回,再后台更新
    const response = cached.clone();

    // 后台静默更新
    fetch(url).then(networkRes => {
      if (networkRes.ok) {
        cache.put(request, networkRes.clone());
      }
    }).catch(() => {}); // 忽略后台更新失败

    return response;
  }

  // 无缓存,正常请求
  const res = await fetch(url);
  if (res.ok) {
    cache.put(request, res.clone());
  }
  return res;
}该方案引入了后台更新的思路。当用户请求数据时,如果本地有缓存,立即返回旧数据以保证速度,同时在后台发起新的网络请求。如果新请求成功,则替换掉旧的缓存内容。这种策略在用户体验和数据新鲜度之间取得了平衡。注意,cache.put 和 fetch 都是异步操作,不会阻塞主线程的返回。
缓存键冲突时如何处理不同 HTTP 方法
在使用 cache.match() 时,默认只比较 URL。如果同一个 URL 既有 GET 请求又有 POST 请求,它们会被视为同一个缓存键,导致数据混乱。例如,POST 提交的数据可能被 GET 请求误读。解决方法是在构建缓存键时,将 HTTP 方法也包含进去,确保每个请求的唯一性。
在之前的代码示例中,我们直接使用 url 字符串作为键。如果业务场景复杂,建议修改如下:
function getCacheKey(request) {
  // 将方法和 URL 组合作为唯一键
  return `${request.method}:${request.url}`;
}

// 使用时
const key = getCacheKey(new Request(url));
const cached = await cache.match(key);
通过将 method 和 url 拼接,可以确保 GET 和 POST 请求互不干扰。这是处理多方法请求时的标准实践,能有效避免数据错乱。


















