








java preparedstatement 执行批量状态管理的核心做法是调用 addbatch() 积累 sql,随后用 executebatch() 统一提交。针对同一语句的多次参数更新,先设置好参数值并调用 addbatch(),最后通过 executebatch() 获取各条语句的执行结果数组。若需处理大量数据,应配合 setautocommit(false) 开启事务以提升性能。

如何为单条 SQL 准备不同参数的批量更新
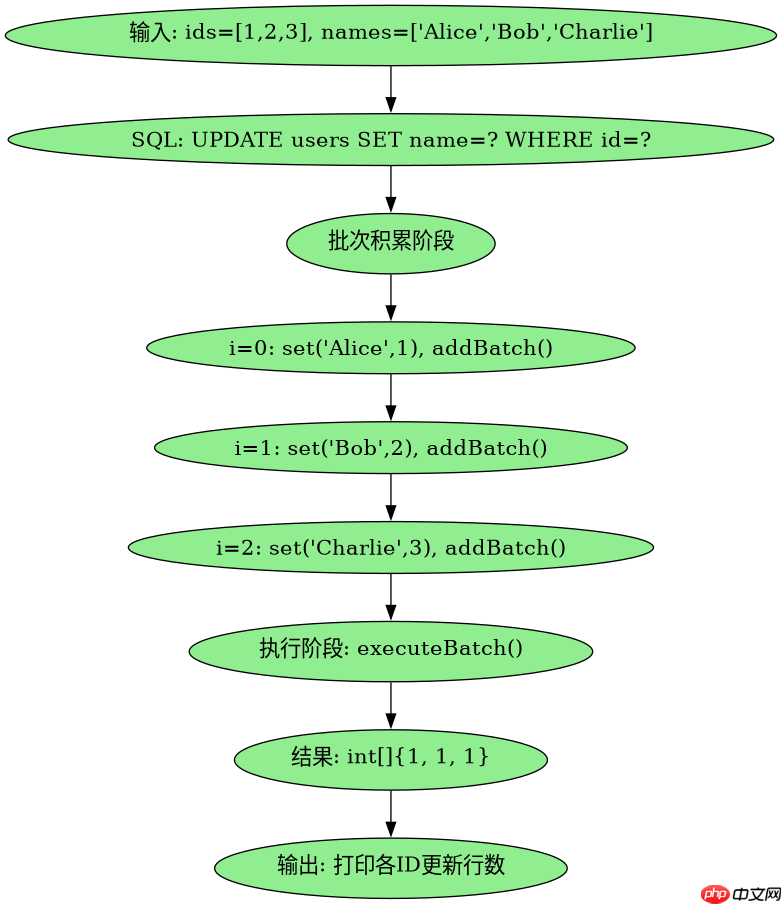
当需要基于不同的输入条件对数据库进行相同的操作时,可以通过循环设置参数并累积批次来实现。具体做法是在循环体内依次调用 setInt()、setString() 等 setter 方法填入当前迭代的数据,紧接着调用 addBatch() 将该组参数加入队列。循环结束后,调用 executeBatch() 一次性发送所有指令,该方法返回一个包含每个语句更新行数的 int[] 数组,用于确认每条记录是否成功处理。
import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.PreparedStatement;

public class BatchUpdateExample {
    public static void main(String[] args) {
        String url = "jdbc:mysql://localhost:3306/test";
        String user = "root";
        String password = "password";

        // 示例输入:一组待更新的 ID 和对应的名称
        int[] ids = {1, 2, 3};
        String[] names = {"Alice", "Bob", "Charlie"};

        try (Connection conn = DriverManager.getConnection(url, user, password);
             PreparedStatement pstmt = conn.prepareStatement(
                 "UPDATE users SET name = ? WHERE id = ?")) {

            // 关闭自动提交以支持批量事务
            conn.setAutoCommit(false);

            for (int i = 0; i < ids.length; i++) {
                pstmt.setString(1, names[i]);
                pstmt.setInt(2, ids[i]);
                pstmt.addBatch(); // 将当前参数集加入批次
            }

            // 执行批量更新
            int[] results = pstmt.executeBatch();

            // 提交事务
            conn.commit();

            // 输出预期结果:每个元素代表对应 SQL 影响的行数
            for (int i = 0; i < results.length; i++) {
                System.out.println("ID: " + ids[i] + " updated rows: " + results[i]);
            }

        } catch (Exception e) {
            e.printStackTrace();
        }
    }
}
上述代码的预期结果是控制台打印出三条记录,分别显示 ID 为 1、2、3 的用户各更新了 1 行(假设数据库中这些 ID 存在)。如果某条记录不存在,对应位置的返回值将为 0。整个过程在单个事务中完成,要么全部成功,要么在异常时回滚。
立即学习“Java免费学习笔记(深入)”;

如何处理批量操作中的异常与部分失败
在执行 executeBatch() 时,如果其中一条语句失败,默认行为取决于驱动配置,但通常会导致整个批次抛出 BatchUpdateException。为了区分哪些成功、哪些失败,可以捕获该异常并检查其 getUpdateCounts() 方法返回的数组。该数组会包含已成功执行的语句计数,对于失败的语句可能返回 EXECUTE_FAILED 常量或 -3。在实际开发中,建议结合事务管理,在捕获异常后手动回滚,确保数据一致性。

import java.sql.BatchUpdateException;
import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.PreparedStatement;

public class BatchErrorHandling {
    public static void main(String[] args) {
        String url = "jdbc:mysql://localhost:3306/test";
        String user = "root";
        String password = "password";

        int[] ids = {1, 999, 3}; // 假设 ID 999 不存在
        String[] names = {"Alice", "Bob", "Charlie"};

        try (Connection conn = DriverManager.getConnection(url, user, password);
             PreparedStatement pstmt = conn.prepareStatement(
                 "UPDATE users SET name = ? WHERE id = ?")) {

            conn.setAutoCommit(false);

            for (int i = 0; i < ids.length; i++) {
                pstmt.setString(1, names[i]);
                pstmt.setInt(2, ids[i]);
                pstmt.addBatch();
            }

            try {
                int[] results = pstmt.executeBatch();
                conn.commit();
                System.out.println("All succeeded.");
            } catch (BatchUpdateException e) {
                // 获取部分成功的结果
                int[] counts = e.getUpdateCounts();
                System.out.println("Partial failure. Counts: ");
                for (int i = 0; i < counts.length; i++) {
                    if (counts[i] == java.sql.Statement.EXECUTE_FAILED) {
                        System.out.println("ID: " + ids[i] + " failed.");
                    } else {
                        System.out.println("ID: " + ids[i] + " updated: " + counts[i]);
                    }
                }
                conn.rollback(); // 回滚以确保一致性
            }

        } catch (Exception e) {
            e.printStackTrace();
        }
    }
}
该程序的预期结果是:由于 ID 999 不存在,第二条 UPDATE 语句会失败。程序会捕获 BatchUpdateException,打印出 ID 1 和 3 的更新情况(假设为 1),并指出 ID 999 失败。随后执行回滚,数据库中没有任何更改被永久保存。这展示了如何在批量操作中识别和处理部分失败的情况。
当批量大小超过内存限制时该如何优化
如果一次性添加成千上万条语句到批次中,可能会导致内存溢出或网络包过大。此时应将大批次拆分为多个小批次。具体做法是维护一个计数器,每调用一定次数(如 1000 次)的 addBatch() 后,立即调用 executeBatch() 并提交当前批次,然后清空批次(虽然新批次会自动覆盖,但显式逻辑更清晰)。这样可以保证内存占用稳定,同时保持事务的局部性。对于超大数据量,还可以结合分片策略,将数据按范围分配给多个连接并行处理。



















