








java 并行流默认使用 forkjoinpool.commonpool(),其线程数固定为 cpu 核心数减一。若需指定自定义线程池处理集合数据,应通过 parallelstream().onexecutor(pool) 将执行器绑定到流上,从而让流操作在指定线程池中运行。

如何创建并配置自定义线程池
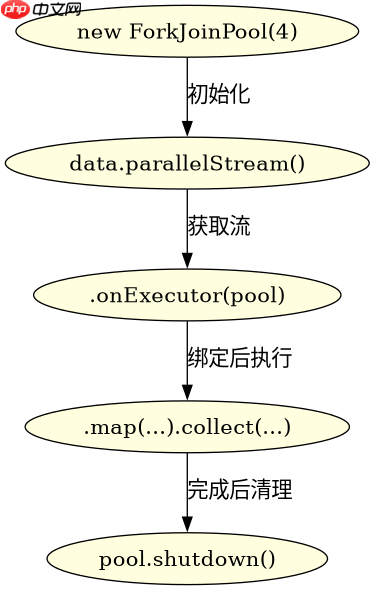
要使用自定义线程池,首先需要实例化一个 ExecutorService,通常推荐使用 ForkJoinPool 以适配并行流的底层机制。创建时,可以指定并行度(parallelism)来限制并发线程数量,避免资源耗尽。例如,创建一个包含 4 个线程的池,然后将其传递给流的 onExecutor 方法。这样,后续的所有流操作都会在这个受限的线程池中调度执行,而不是占用全局公共池。
import java.util.concurrent.ForkJoinPool;
import java.util.List;
import java.util.stream.Collectors;

public class ParallelStreamExample {
    public static void main(String[] args) {
        // 1. 创建自定义 ForkJoinPool,设置并行度为 4
        ForkJoinPool customPool = new ForkJoinPool(4);

        List<String> data = List.of("A", "B", "C", "D", "E");

        // 2. 获取并行流并绑定自定义执行器
        List<String> result = data.parallelStream()
                .onExecutor(customPool)
                .map(s -> s.toUpperCase())
                .collect(Collectors.toList());

        System.out.println(result); // [A, B, C, D, E]

        // 3. 关闭线程池
        customPool.shutdown();
    }
}
上述代码中,ForkJoinPool(4) 创建了具有 4 个工作线程的池。onExecutor(customPool) 是关键调用,它返回一个新的流视图,该视图使用提供的执行器进行任务提交。最后必须调用 shutdown() 以释放资源。
立即学习“Java免费学习笔记(深入)”;

如何处理异常与资源管理
在使用自定义线程池时,异常处理和资源生命周期管理至关重要。并行流中的异常会被包装在 CompletionException 中抛出,因此捕获时需要解包。此外,如果线程池是局部变量或不再需要,必须确保其正确关闭,否则会导致线程泄漏。对于短生命周期的任务,建议使用 try-with-resources 或显式关闭;对于长期运行的应用,应复用线程池但注意监控队列积压情况。

import java.util.concurrent.CompletionException;
import java.util.concurrent.ForkJoinPool;
import java.util.List;
import java.util.stream.Collectors;

public class ExceptionHandlingExample {
    public static void main(String[] args) {
        ForkJoinPool pool = new ForkJoinPool(2);

        List<Integer> numbers = List.of(1, 0, 3);

        try {
            List<Integer> results = numbers.parallelStream()
                    .onExecutor(pool)
                    .map(n -> { if (n == 0) throw new RuntimeException("Zero!"); return n * 2; })
                    .collect(Collectors.toList());
        } catch (CompletionException e) {
            // 解包原始异常
            Throwable cause = e.getCause();
            System.err.println("Caught: " + cause.getMessage());
        } finally {
            pool.shutdown();
        }
    }
}
在此示例中,当遇到除零错误时,map 操作抛出运行时异常。并行流会捕获此异常并将其封装为 CompletionException。外层 catch 块通过 e.getCause() 获取原始异常信息。这种模式确保了即使发生错误,也能正确清理线程池资源。
并行流在自定义线程池中的任务拆分行为
并行流内部使用 Splitter 将数据源拆分为子任务,这些子任务由 ForkJoinPool 的工作窃取算法(Work-Stealing)调度。当绑定自定义线程池后,任务仍会被递归拆分,直到达到最小分割阈值。每个子任务在池中的线程上异步执行。若数据量较小,可能不会触发多线程并行,而是顺序执行。因此,自定义线程池主要影响的是并发执行的线程上限和调度策略,而非拆分逻辑本身。


















