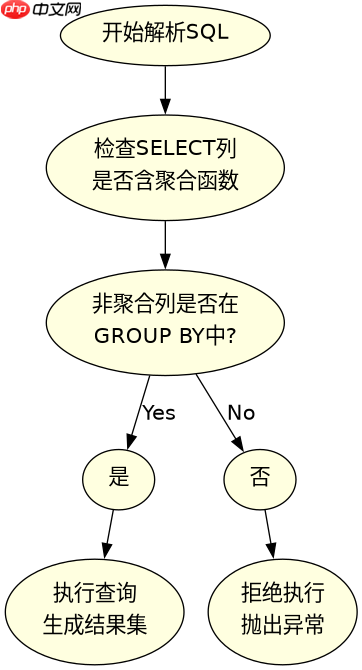
在sql中使用聚合函数时,非聚合列必须出现在group by子句中,是因为数据库引擎需要明确的分组依据来确定每一行聚合结果对应哪些原始数据。如果允许非聚合列自由出现,数据库将无法判断该列的值应该取组内的哪一个(例如第一条、最后一条或随机一条),从而导致语义模糊和结果不可预测。
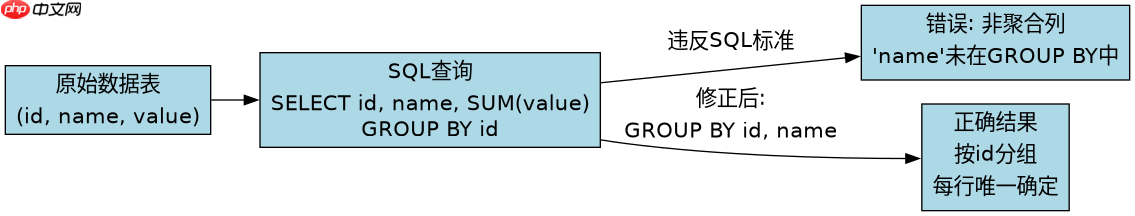
SELECT中未分组的列会导致什么错误
当你在查询中同时使用聚合函数(如COUNT)和非聚合列,且该非聚合列没有出现在GROUP BY中时,标准SQL数据库会直接抛出语法错误。这是因为SQL标准要求每一列要么被聚合,要么作为分组的键。例如,试图从订单表中查询每个客户的订单总数以及客户姓名,但忘记将姓名加入分组条件,数据库无法决定返回哪个姓名,因此拒绝执行。
SELECT customer_id, customer_name, COUNT(order_id)
FROM orders
GROUP BY customer_id;
上述代码在执行时会报错,提示customer_name不在分组依据中。正确的做法是将customer_name也加入GROUP BY,或者使用窗口函数等替代方案。这确保了每个输出行都有唯一确定的值来源。
为什么不能随意选取组内任意一行
虽然某些数据库(如MySQL在非严格模式下)允许这种写法并返回组内某行的值,但这是一种危险的行为。因为选取哪一行是不确定的,可能导致数据不一致。SQL的设计哲学要求显式性,即开发者必须明确指定如何处理非聚合数据。通过强制分组,数据库保证了结果的确定性和可重复性。如果不这样做,聚合函数的意义将被削弱,因为结果可能依赖于底层存储顺序而非业务逻辑。
SELECT customer_id, MAX(customer_name), COUNT(order_id)
FROM orders
GROUP BY customer_id;
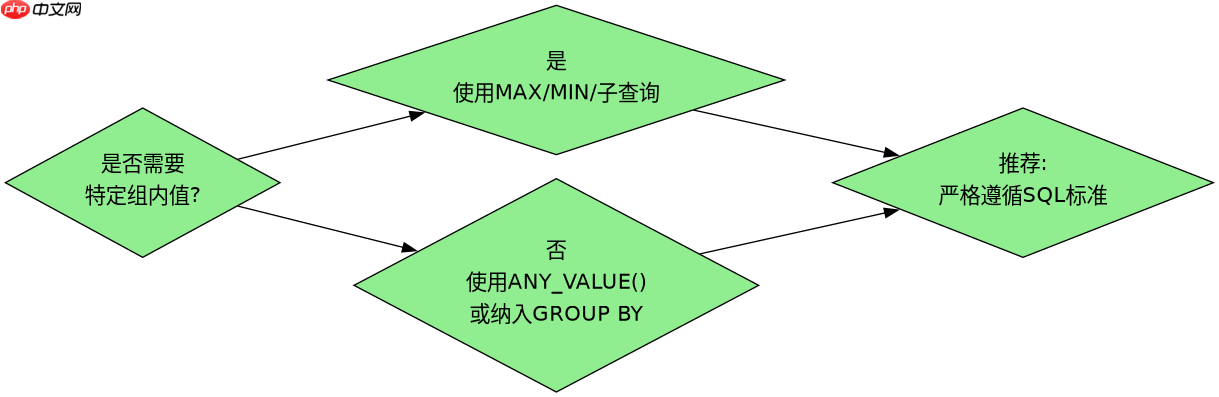
如果确实需要获取组内某个特定值(如最新姓名),应使用聚合函数如MAX或MIN,或者使用子查询/窗口函数明确指定规则。这样既符合SQL标准,又保证了逻辑清晰。
使用ANY_VALUE()绕过限制的风险
部分数据库提供ANY_VALUE()函数来显式告诉数据库“随便取一个值”。虽然这在技术上可行,但它掩盖了潜在的数据歧义问题。开发者应谨慎使用,仅在确实不需要特定值且性能优先的场景下考虑。通常情况下,遵循标准SQL规范,将所有非聚合列纳入分组或使用聚合函数处理,是更安全和可维护的做法。