








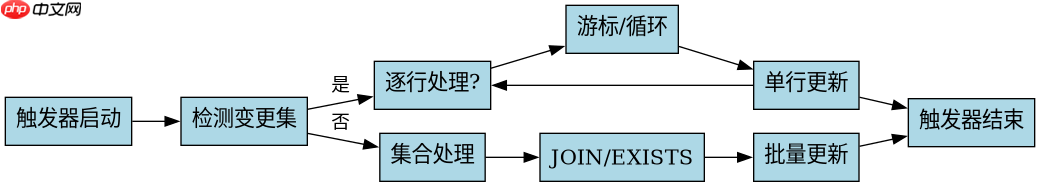
在sql server中重构大型复杂触发器以提高响应速度,核心做法是将触发器内的多行集合操作替换为基于集合的批量处理逻辑,并移除循环和游标。具体而言,应利用`inserted`和`deleted`临时表进行全量数据比对,通过`join`或`exists`子句一次性完成更新、插入或删除操作,从而避免逐行处理的开销。这样做能显著减少锁持有时间和日志写入量,提升数据库在高并发场景下的吞吐量。
如何识别触发器中的性能瓶颈
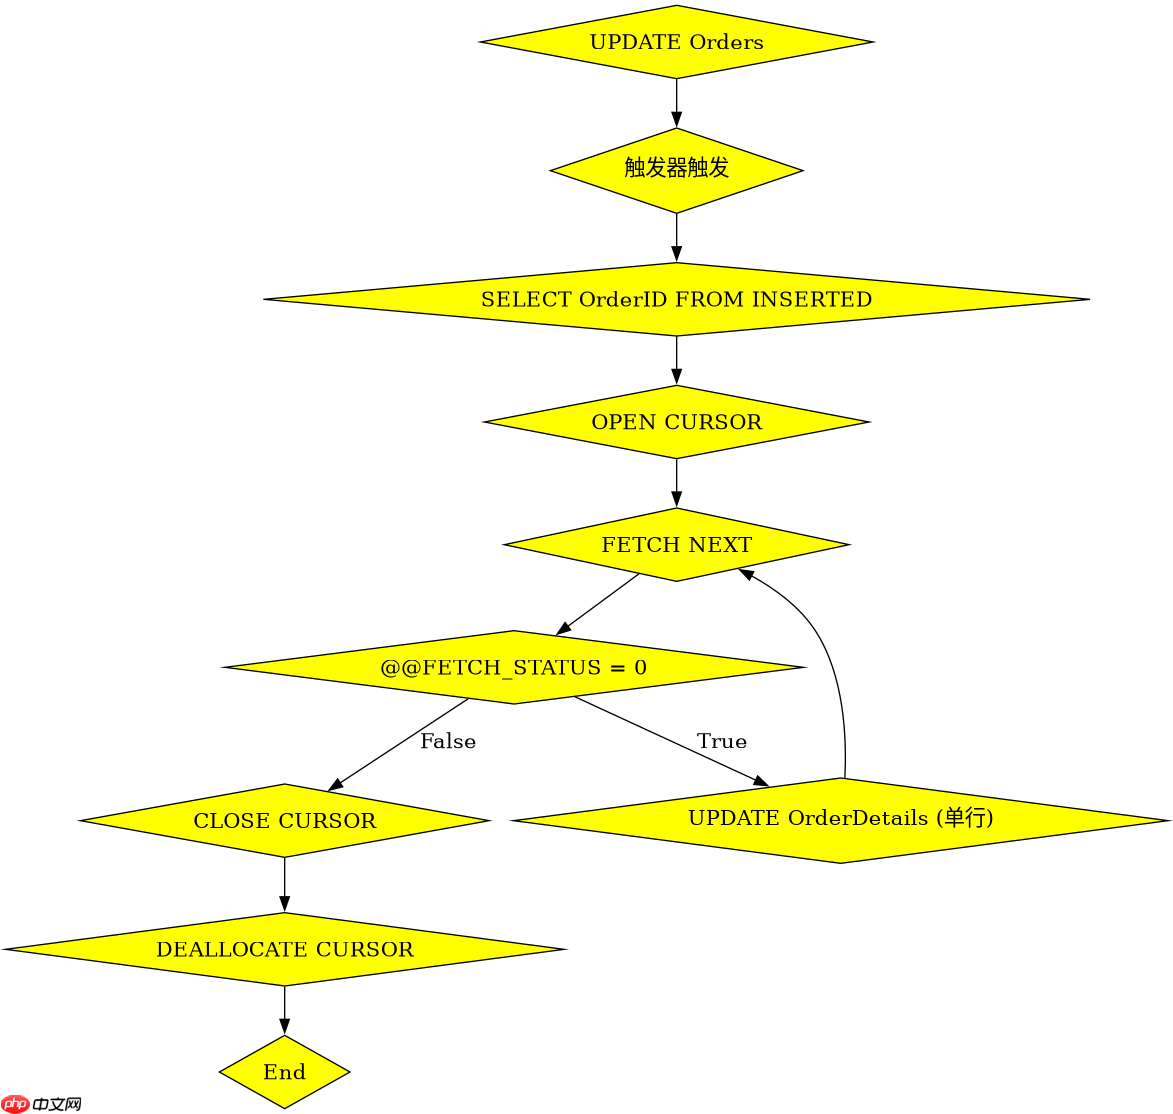
识别性能瓶颈的关键在于分析触发器代码中是否存在逐行处理逻辑,例如使用`WHILE`循环或游标遍历`INSERTED`表。如果触发器对每一行都执行独立的`UPDATE`或`INSERT`语句,会导致大量的上下文切换和事务日志记录。通过检查执行计划,可以发现这些单行操作往往伴随着高频率的索引查找和锁竞争,这是导致响应缓慢的主要原因。
-- 低效的逐行处理触发器示例
CREATE TRIGGER trg_InefficientUpdate
ON dbo.Orders
AFTER UPDATE
AS
BEGIN
    DECLARE @OrderID INT;
    DECLARE cur CURSOR FOR SELECT OrderID FROM INSERTED;
    OPEN cur;
    FETCH NEXT FROM cur INTO @OrderID;
    WHILE @@FETCH_STATUS = 0
    BEGIN
        -- 每行执行一次更新,效率极低
        UPDATE dbo.OrderDetails
        SET LastModified = GETDATE()
        WHERE OrderID = @OrderID;
        FETCH NEXT FROM cur INTO @OrderID;
    END
    CLOSE cur;
    DEALLOCATE cur;
END
上述代码展示了典型的低效模式。输入是`UPDATE`操作影响的多个订单,预期结果是所有相关明细表的最后修改时间被更新。但实际行为是逐行获取`OrderID`并单独执行更新,这在批量更新时会引发严重的性能问题。
如何将逐行逻辑转换为集合操作
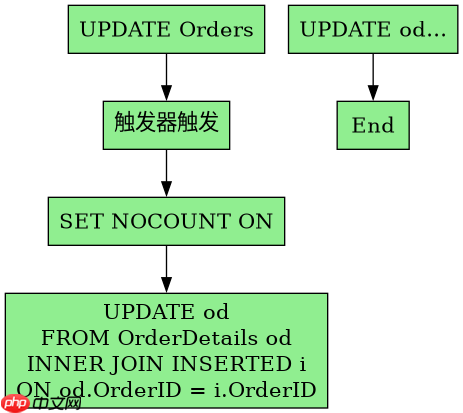
将逐行逻辑转换为集合操作的核心是利用`INSERTED`表作为源,直接连接目标表进行批量更新。不再需要声明变量或游标,而是编写一条包含`JOIN`条件的`UPDATE`语句,一次性处理所有受影响的行。这种写法不仅代码更简洁,而且能让SQL Server优化器生成更高效的执行计划,通常使用哈希匹配或合并连接来加速处理。
-- 高效的集合操作触发器示例
CREATE TRIGGER trg_BatchUpdate
ON dbo.Orders
AFTER UPDATE
AS
BEGIN
    SET NOCOUNT ON;
    -- 一次性更新所有受影响的订单明细
    UPDATE od
    SET od.LastModified = GETDATE()
    FROM dbo.OrderDetails od
    INNER JOIN INSERTED i ON od.OrderID = i.OrderID;
END
这段代码展示了重构后的实现。输入同样是`UPDATE`操作,但通过`INNER JOIN`将`INSERTED`表与`OrderDetails`表关联,一次性完成更新。预期结果是所有匹配的`LastModified`字段被更新,且执行时间随数据量线性增长而非指数级恶化。这种方法消除了游标开销,减少了锁粒度,是提升触发器响应速度的标准做法。
如何处理触发器中的条件分支以避免无效计算
在处理触发器中的条件分支时,应避免在循环内部或每次迭代中重复计算不变的常量或查询结果。例如,如果触发器需要根据某些配置表判断是否启用审计功能,应在触发器开始时一次性加载这些配置到局部变量或临时表中,而不是在每行处理时都去查询基表。这样可以减少I/O操作,确保只有真正需要处理的行才进入复杂的业务逻辑分支。























