








在sql中编写带group by的增量聚合更新语句,核心思路是利用子查询或cte预先计算好每个分组的累计值,然后通过主键关联原表进行批量更新。具体做法是创建一个包含分组键和聚合结果(如sum、count)的临时数据集,将其与原表join,将新计算的聚合值直接赋值给目标列。这样做能避免逐行循环带来的性能瓶颈,确保数据一致性。
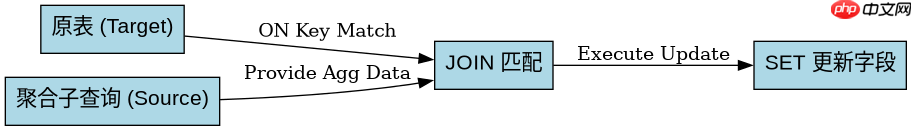
如何基于明细表汇总金额并更新汇总表
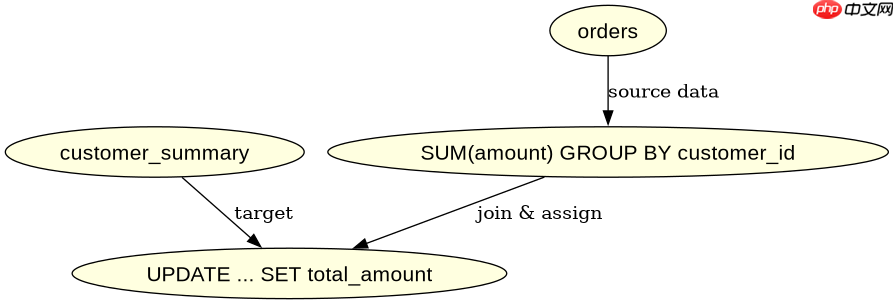
该场景下,需要统计订单表中每个客户的总金额,并将结果写入客户汇总表。通过LEFT JOIN连接明细数据和聚合后的中间结果,可以安全地处理没有订单的客户,将其金额重置为0。使用COALESCE函数处理空值是防止NULL传播的关键步骤。
UPDATE customer_summary cs
INNER JOIN (
    SELECT customer_id, SUM(amount) as total_amount
    FROM orders
    GROUP BY customer_id
) od ON cs.customer_id = od.customer_id
SET cs.total_amount = COALESCE(od.total_amount, 0);
上述代码首先从orders表按customer_id分组计算总和,然后与customer_summary表关联。执行后,有订单的客户金额被更新,无订单的客户保持原状(若需清零可改用LEFT JOIN)。预期结果是total_amount字段准确反映最新汇总值。
如何处理多条件分组下的状态计数更新
当需要根据多个维度(如日期和产品类型)统计状态数量时,聚合逻辑需包含所有分组键。此时应确保子查询中的GROUP BY子句涵盖所有用于关联的列,否则会导致数据重复或丢失。这种模式常用于生成日报或实时看板数据。

UPDATE daily_stats ds
INNER JOIN (
    SELECT product_type, status_date, COUNT(*) as cnt
    FROM events
    WHERE status_date >= '2023-01-01'
    GROUP BY product_type, status_date
) ev ON ds.product_type = ev.product_type AND ds.status_date = ev.status_date
SET ds.event_count = ev.cnt;
此示例展示了多字段关联更新的写法。子查询先过滤时间范围并按product_type和status_date分组计数,随后与统计表匹配。注意关联条件必须完整覆盖分组键,否则可能引发非预期的笛卡尔积或数据错配。运行后,指定范围内的统计数将被精确覆盖。
如果原表存在未匹配的记录会怎样
在使用INNER JOIN进行更新时,那些在聚合子查询中找不到对应记录的行将不会被修改,保留原有值。如果需要将这些未匹配行的目标字段显式置为空或默认值,则必须改用LEFT JOIN,并在SET子句中处理NULL情况。这种差异直接影响数据的完整性,需根据业务需求选择连接方式。

















