java 中通过指定字符集(如 utf-8)进行反序列化,可以确保字节流被正确还原为原始字符串或对象。具体做法是在读取字节流时,使用 `inputstreamreader` 并传入 `standardcharsets.utf_8`,或者在自定义反序列化逻辑中显式调用 `new string(bytes, standardcharsets.utf_8)`。这样做能避免因平台默认编码不一致导致的数据乱码或解析错误。

如何从字节数组中按 UTF-8 解码字符串
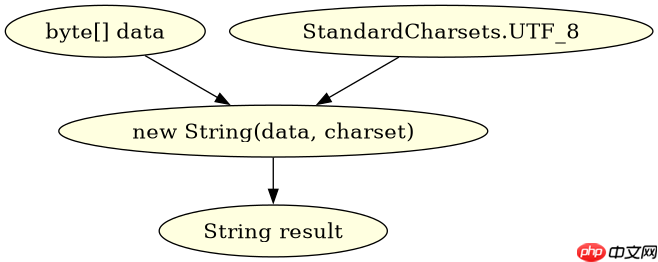
直接回答:使用 `new String(byte[], Charset)` 构造函数即可将字节数组按指定编码恢复为字符串。关键在于传入 `StandardCharsets.UTF_8` 以确保跨平台一致性。若字节数组包含非 UTF-8 数据,此操作可能抛出异常或产生替换字符。
import java.nio.charset.StandardCharsets;

public class DecodeExample {
    public static void main(String[] args) {
        // 假设这是之前用 UTF-8 编码的字节数据
        byte[] data = "Hello World".getBytes(StandardCharsets.UTF_8);

        // 反序列化/解码:指定 UTF-8 字符集
        String result = new String(data, StandardCharsets.UTF_8);

        System.out.println(result); // 输出: Hello World
    }
}
预期结果:控制台打印出与原始输入完全一致的 "Hello World" 字符串。类型验证:`result` 为 `java.lang.String` 实例。若输入字节损坏,`new String` 会使用默认替换字符(通常是 '?'),不会抛出异常,除非使用更严格的解码器。
立即学习“Java免费学习笔记(深入)”;

使用Atmosphere构建通过WebSocket、SSE、gRPC、WebTransport、MCP、A2A和AG-UI流传输的JVM代理网关,并带有治理钩子。
如何在 ObjectInputStream 中处理字符型字段
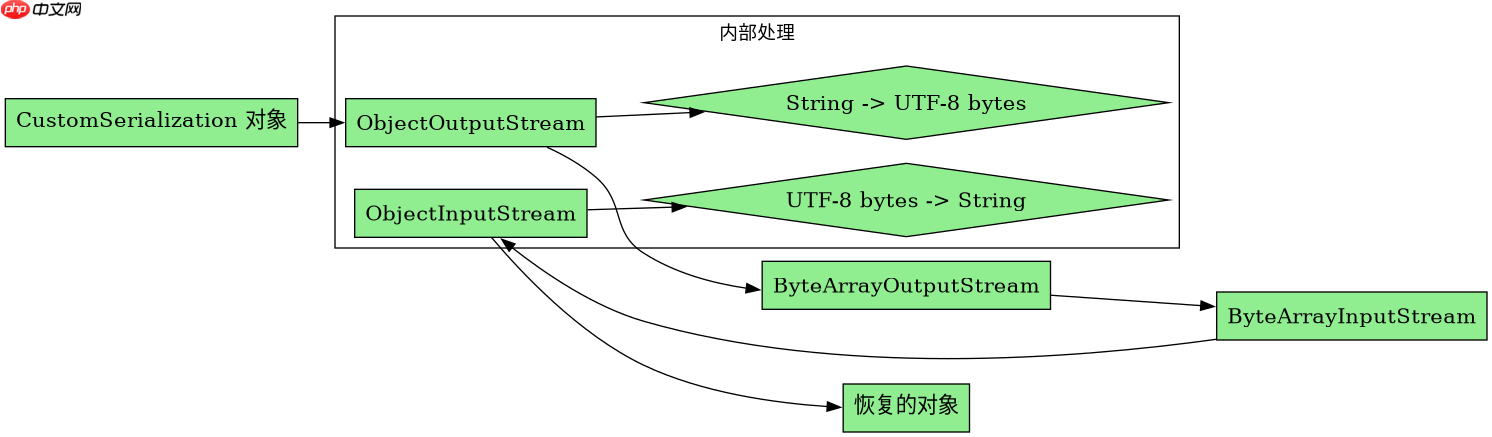
直接回答:在 Java 原生序列化中,`ObjectInputStream` 自动处理基本类型和字符串的编码,但前提是写入时使用了正确的编码。对于自定义对象中的 `String` 字段,无需额外指定编码,因为 `ObjectOutputStream` 内部会将其转换为 UTF-8 格式存储。若需手动干预,应重写 `writeObject` 和 `readObject` 方法,并在其中显式处理字节到字符串的转换。
import java.io.*;
import java.nio.charset.StandardCharsets;

public class CustomSerialization implements Serializable {
    private String content;

    public CustomSerialization(String content) {
        this.content = content;
    }

    private void writeObject(ObjectOutputStream out) throws IOException {
        out.defaultWriteObject();
        // 可选:额外写入编码标识,便于反序列化时识别
        out.writeUTF("UTF-8");
    }

    private void readObject(ObjectInputStream in) throws IOException, ClassNotFoundException {
        in.defaultReadObject();
        // 读取编码标识(如果需要)
        String encoding = in.readUTF();
        // 此处可添加基于 encoding 的额外逻辑
    }

    public static void main(String[] args) throws Exception {
        ByteArrayOutputStream baos = new ByteArrayOutputStream();
        try (ObjectOutputStream oos = new ObjectOutputStream(baos)) {
            oos.writeObject(new CustomSerialization("测试数据"));
        }

        ByteArrayInputStream bais = new ByteArrayInputStream(baos.toByteArray());
        try (ObjectInputStream ois = new ObjectInputStream(bais)) {
            CustomSerialization obj = (CustomSerialization) ois.readObject();
            System.out.println(obj.content); // 输出: 测试数据
        }
    }
}
预期结果:程序成功序列化并反序列化包含中文的对象,控制台输出 "测试数据"。注意:`ObjectOutputStream` 内部对 `String` 使用 UTF-8 编码,因此无需手动指定。若对象中包含非标准字符,仍依赖 JVM 内部处理。未找到异常情况,因为 `defaultReadObject` 会处理标准字段。
当字节流包含混合编码时如何安全恢复
直接回答:若字节流中混入不同编码(如 GBK 和 UTF-8),无法通过单一字符集可靠恢复。最佳实践是确保数据源统一编码,或在元数据中标记每段数据的编码。若必须处理混合流,需分段检测编码或使用启发式算法(如 BOM 标记)。例如,检查前三个字节是否为 EF BB BF(UTF-8 BOM),若是则按 UTF-8 解析后续内容;否则尝试其他编码。