








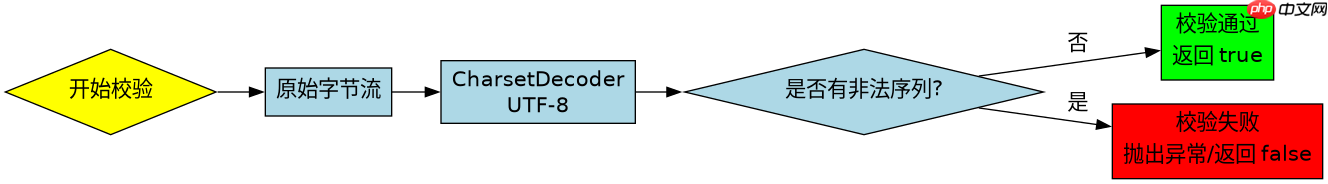
使用编码校验保证数据完整性的核心做法是:在接收端或存储前,利用目标字符集(如 utf-8)的解码器对原始字节流进行严格验证。具体而言,应调用 charsetdecoder 并配置其错误处理策略为 codingerroraction.ignore 或 codingerroraction.report,然后执行 decode() 操作。如果输入字节序列符合该编码规范且无损坏,解码将成功返回字符串;若存在非法字节序列,解码器会抛出 malformedinputexception 或记录错误,从而拦截不完整或错误的数据。此外,对于固定长度的编码(如 gbk),还需结合长度校验确保字节数与字符数匹配,防止截断。
如何检测 UTF-8 字节流中的非法序列
要检测 UTF-8 字节流中的非法序列,最直接的方法是使用 Java NIO 中的 StandardCharsets.UTF_8 配合 CharsetDecoder。通过设置 CodingErrorAction.REPORT,当遇到不符合 UTF-8 规范的字节组合时,解码器会立即报告错误。这种方法比直接使用 new String(bytes, "UTF-8") 更可靠,因为后者默认行为是替换非法字符(用 U+FFFD),从而掩盖了数据损坏的事实,导致完整性校验失败。
import java.nio.ByteBuffer;
import java.nio.CharBuffer;
import java.nio.charset.Charset;
import java.nio.charset.CharsetDecoder;
import java.nio.charset.CodingErrorAction;
import java.nio.charset.MalformedInputException;

public class Utf8Validator {
    public static boolean isValidUtf8(byte[] data) {
        Charset charset = Charset.forName("UTF-8");
        CharsetDecoder decoder = charset.newDecoder();
        // 关键步骤:设置为 REPORT,遇到非法序列即报错
        decoder.onMalformedInput(CodingErrorAction.REPORT);
        decoder.onUnmappableCharacter(CodingErrorAction.REPORT);

        ByteBuffer byteBuffer = ByteBuffer.wrap(data);
        CharBuffer charBuffer = CharBuffer.allocate(data.length * 2); // 预估容量

        try {
            decoder.decode(byteBuffer, charBuffer, true);
            return true; // 解码成功,无非法序列
        } catch (MalformedInputException e) {
            return false; // 检测到非法 UTF-8 序列
        }
    }

    public static void main(String[] args) {
        // 测试用例 1: 合法的 UTF-8 "Hello"
        byte[] validData = "Hello".getBytes(java.nio.charset.StandardCharsets.UTF_8);
        System.out.println("Valid Data: " + isValidUtf8(validData)); // true

        // 测试用例 2: 包含非法字节 0xFF 的数据
        byte[] invalidData = new byte[]{72, 101, 108, 108, 111, (byte) 0xFF};
        System.out.println("Invalid Data: " + isValidUtf8(invalidData)); // false
    }
}
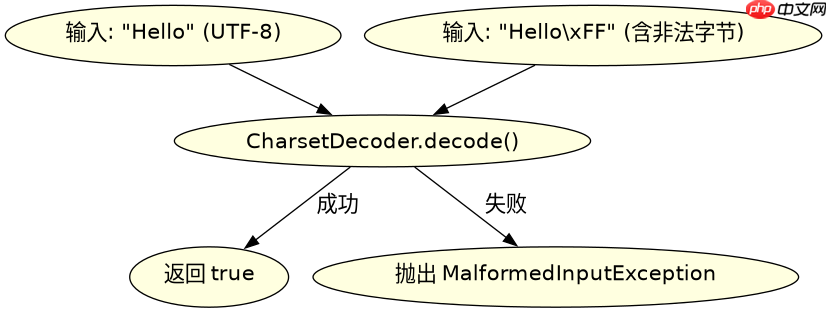
上述代码展示了完整的校验流程。首先创建解码器实例,并通过 onMalformedInput 方法明确指定遇到格式错误的输入时应采取的动作。在 main 方法中,我们构造了两组数据:一组是标准的 ASCII 字符(也是合法 UTF-8),另一组是在末尾追加了一个非 UTF-8 起始字节 0xFF 的数组。运行结果显示,前者返回 true,后者返回 false。这种机制确保了只有完全符合 UTF-8 规范的字节流才能通过校验,任何位级别的损坏都会被捕获。
立即学习“Java免费学习笔记(深入)”;

使用Atmosphere构建通过WebSocket、SSE、gRPC、WebTransport、MCP、A2A和AG-UI流传输的JVM代理网关,并带有治理钩子。
如何处理 GBK 编码的长度与字符匹配问题
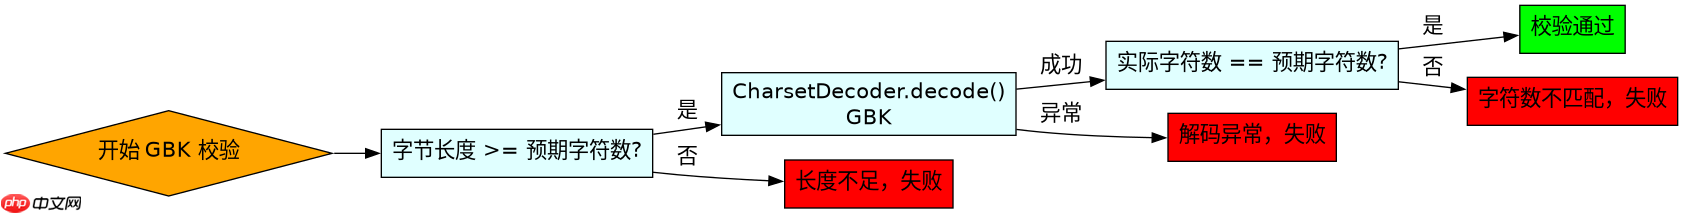
GBK 编码采用变长设计,英文字符占 1 字节,中文字符占 2 字节。因此,仅靠解码器无法完全保证数据完整性,因为截断的字节流可能仍能被部分解码而不报错。必须额外检查字节长度与预期字符数的关系。具体做法是:先获取字节数组长度,再尝试解码,最后验证解码后的字符长度是否与预期一致。如果字节长度不是偶数,或者解码后的字符数与预期不符,则判定数据不完整。
import java.nio.ByteBuffer;
import java.nio.CharBuffer;
import java.nio.charset.Charset;
import java.nio.charset.CharsetDecoder;
import java.nio.charset.CodingErrorAction;
import java.nio.charset.MalformedInputException;

public class GbkIntegrityChecker {
    public static boolean isGbkComplete(byte[] data, int expectedCharCount) {
        if (data == null || data.length == 0) {
            return expectedCharCount == 0;
        }

        // GBK 编码中,每个字符至少占 1 字节,最多 2 字节
        // 如果字节长度小于 expectedCharCount,肯定不完整
        if (data.length < expectedCharCount) {
            return false;
        }

        Charset charset = Charset.forName("GBK");
        CharsetDecoder decoder = charset.newDecoder();
        decoder.onMalformedInput(CodingErrorAction.REPORT);
        decoder.onUnmappableCharacter(CodingErrorAction.REPORT);

        ByteBuffer byteBuffer = ByteBuffer.wrap(data);
        CharBuffer charBuffer = CharBuffer.allocate(expectedCharCount);

        try {
            decoder.decode(byteBuffer, charBuffer, true);
            // 检查是否所有预期字符都被填充
            charBuffer.flip();
            int actualCharCount = charBuffer.remaining();
            return actualCharCount == expectedCharCount;
        } catch (MalformedInputException e) {
            return false;
        }
    }

    public static void main(String[] args) {
        // 假设预期有 2 个字符
        int expectedChars = 2;

        // 测试用例 1: 两个中文 "AB" (GBK: C4 E3 BA C3)
        byte[] completeGbk = new byte[]{(byte) 0xC4, (byte) 0xE3, (byte) 0xBA, (byte) 0xC3};
        System.out.println("Complete GBK: " + isGbkComplete(completeGbk, expectedChars)); // true

        // 测试用例 2: 截断的中文 "A" (GBK: C4 E3)
        byte[] truncatedGbk = new byte[]{(byte) 0xC4, (byte) 0xE3};
        System.out.println("Truncated GBK: " + isGbkComplete(truncatedGbk, expectedChars)); // false

        // 测试用例 3: 一个英文 "A" (GBK: 41)
        byte[] singleAscii = new byte[]{0x41};
        System.out.println("Single ASCII: " + isGbkComplete(singleAscii, expectedChars)); // false
    }
}
这段代码针对 GBK 编码的特殊性进行了增强。在 isGbkComplete 方法中,首先进行长度预检,如果字节数少于预期字符数,直接返回 false。接着,使用 CharsetDecoder 进行解码,并再次启用严格模式。解码完成后,通过 charBuffer.remaining() 获取实际解码出的字符数量,并与传入的 expectedCharCount 进行比较。在 main 方法中,我们测试了三种情况:完整的两个中文字符、截断的一个中文字符、以及单个 ASCII 字符。结果分别输出 true、false 和 false,证明该方法能有效识别因截断导致的 GBK 数据不完整问题。
基于程序中某个输入、条件或结果的具体问题
在实际应用中,一个常见的问题是:当输入数据包含混合编码(如部分 UTF-8 和部分 GBK)时,单一的编码校验会失败。此时,程序应如何判断数据是否“完整”?答案是:在这种场景下,“完整性”的定义需调整为“是否符合当前指定的单一编码标准”。如果业务允许混合编码,则不应使用单一编码校验,而应采用多阶段解析或统一转换为 Unicode 内部表示后再校验。但在大多数网络传输和存储场景中,强制要求全量数据使用同一编码(如 UTF-8)是最佳实践。因此,基于上述代码,若输入数据被标记为 UTF-8,但实际包含 GBK 字节,isValidUtf8 将返回 false,这被视为数据不完整或错误,而非兼容性问题。开发者应在入口处统一转换编码,避免运行时校验的复杂性。


















