








java stream api 实现并行流处理的核心方法是调用 .parallel(),它会将数据源划分为多个子任务交由 forkjoinpool 的公共线程池执行。对于集合数据,可以直接使用 .parallelstream() 或先获取流再调用 .parallel();对于数组,则需借助 arrays.stream() 并指定并行模式。并行化能利用多核优势加速计算密集型操作,但需注意线程安全与开销平衡。

如何从集合创建并行流
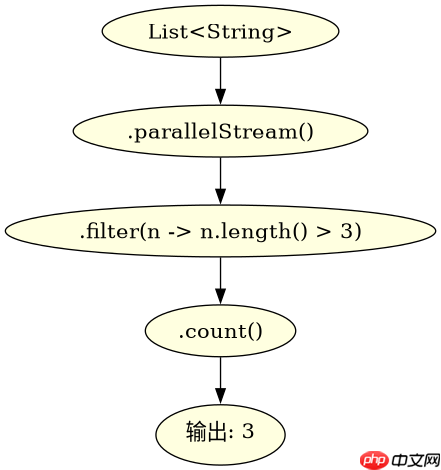
从集合创建并行流最直接的方式是使用 .parallelStream() 方法,或者在获取普通流后调用 .parallel()。这两种方式都会返回一个支持并行处理的 Stream 实例,其 spliterator 会标记为 parallel。例如,对 List 进行过滤和映射时,底层会自动将列表分割成块分发给不同线程处理。
import java.util.Arrays;
import java.util.List;
import java.util.stream.Collectors;

public class ParallelStreamExample {
    public static void main(String[] args) {
        List<String> names = Arrays.asList("Alice", "Bob", "Charlie", "David");

        // 方式一:直接调用 parallelStream()
        long count1 = names.parallelStream()
                .filter(n -> n.length() > 3)
                .count();
        System.out.println("Count via parallelStream: " + count1);

        // 方式二:先获取 stream 再调用 parallel()
        long count2 = names.stream()
                .parallel()
                .filter(n -> n.length() > 3)
                .count();
        System.out.println("Count via stream().parallel(): " + count2);
    }
}
预期输出:
Count via parallelStream: 3
Count via stream().parallel(): 3
立即学习“Java免费学习笔记(深入)”;

使用Atmosphere构建通过WebSocket、SSE、gRPC、WebTransport、MCP、A2A和AG-UI流传输的JVM代理网关,并带有治理钩子。
如何处理数组的并行流
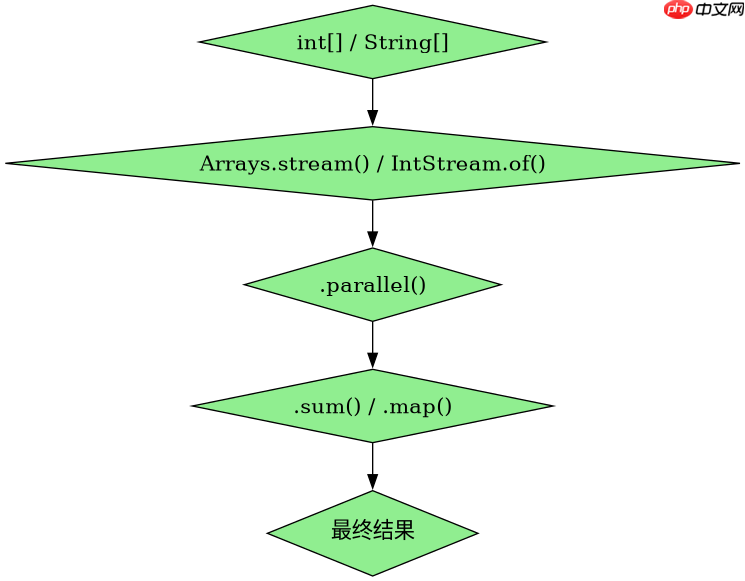
处理数组时,不能直接调用 .parallelStream(),因为数组没有这个方法。需要使用 java.util.Arrays 工具类提供的 stream(T[] array) 或 stream(int[] array) 等方法,然后链式调用 .parallel()。这些方法返回的 Stream 同样基于 ForkJoinPool 进行并行处理,适合数值计算或大规模对象处理。
import java.util.Arrays;
import java.util.stream.IntStream;

public class ParallelArrayExample {
    public static void main(String[] args) {
        int[] numbers = {1, 2, 3, 4, 5, 6, 7, 8, 9, 10};

        // 对 int 数组进行并行求和
        int sum = IntStream.of(numbers)
                .parallel()
                .sum();
        System.out.println("Sum of array: " + sum);

        // 对 String 数组进行并行转换
        String[] words = {"hello", "world", "java"};
        String[] upperWords = Arrays.stream(words)
                .parallel()
                .map(String::toUpperCase)
                .toArray(String[]::new);
        System.out.println("Upper words: " + Arrays.toString(upperWords));
    }
}
预期输出:
Sum of array: 55
Upper words: [HELLO, WORLD, JAVA]
并行流在什么条件下可能降低性能
当并行流的计算任务过于轻量、数据量较小,或者操作涉及大量同步开销(如并发修改共享状态)时,并行化反而会比串行流更慢。这是因为 ForkJoinPool 的任务划分、线程调度和结果合并本身有固定开销。此外,如果使用的是默认的公共 ForkJoinPool(大小为 CPU 核心数减一),且其他线程也在竞争该池,会导致资源争用。因此,只有当每个元素的处理成本较高(如复杂计算、I/O 绑定除外)且数据量足够大时,并行流才能带来显著的性能提升。



















