








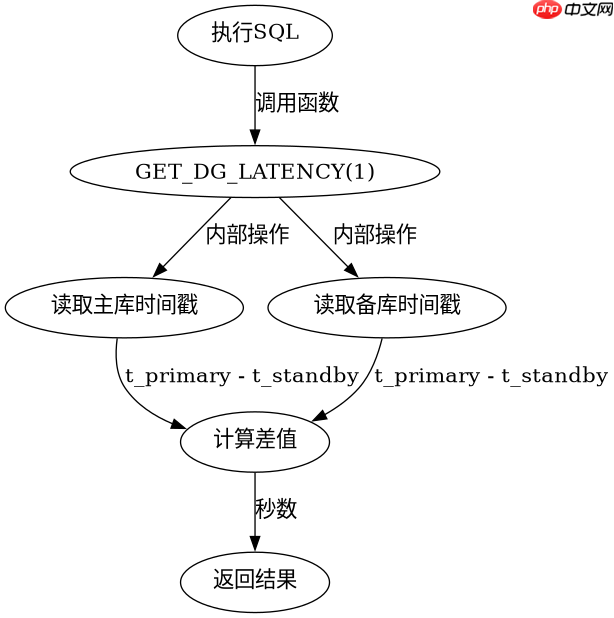
监控oracle data guard备库的数据应用延迟时间,最直接且准确的方法是使用内置的 get_dg_latency 函数。该函数通过对比主库和备库的系统时间戳,计算出数据从主库传输到备库并应用所需的总耗时(单位:秒)。调用时只需传入一个整数参数来指定要检查的日志序列号范围,通常设置为1即可获取最近一次归档或应用的延迟情况。

如何查看实时应用延迟的具体数值
使用 GET_DG_LATENCY 函数可以获取具体的延迟秒数。该函数返回的是一个数字,表示当前时间点主备之间的时间差。如果返回值为0,说明主备库时间同步良好且无积压;如果返回值较大,则说明存在明显的延迟。这个数值包含了网络传输时间和备库应用日志的时间。
SELECT GET_DG_LATENCY(1) AS latency_seconds FROM DUAL;
上述SQL语句在备库执行后,会返回一个名为 latency_seconds 的列。例如,如果返回结果为5,意味着备库比主库慢了5秒。这是监控延迟最核心的指标。需要注意的是,该函数依赖于主备库系统时间的准确性,因此确保两台服务器的NTP时间同步是前提条件。

如何通过视图监控日志应用进度与状态
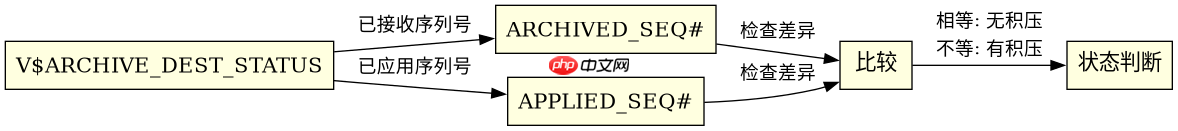
除了直接获取延迟秒数,还可以通过查询 V$ARCHIVE_DEST_STATUS 视图来观察日志的应用状态和序列号差异。该视图提供了每个归档目标的详细状态信息,包括当前的接收序列号和应用的序列号。通过比较这两个值,可以判断是否有未应用的日志堆积。
SELECT DEST_ID, STATUS, TARGET, ARCHIVED_THREAD#, ARCHIVED_SEQ#, APPLIED_SEQ#
FROM V$ARCHIVE_DEST_STATUS
WHERE TARGET = 'STANDBY';
执行上述查询后,重点关注 APPLIED_SEQ#(已应用序列号)和 ARCHIVED_SEQ#(已接收序列号)。如果两者相等,说明所有接收到的日志都已应用完毕,此时延迟仅由时间戳差异决定。如果 APPLIED_SEQ# 小于 ARCHIVED_SEQ#,则说明有日志尚未应用,延迟会随着积压量的增加而变大。结合 GET_DG_LATENCY 的结果,可以更全面地评估Data Guard的健康状况。
当应用延迟持续增加时应如何排查
如果 GET_DG_LATENCY 返回的值持续增大,或者 V$ARCHIVE_DEST_STATUS 显示 APPLIED_SEQ# 停滞不前,通常意味着备库的应用进程遇到了瓶颈或阻塞。常见原因包括备库负载过高、网络带宽不足或存在长事务导致的应用滞后。此时应检查备库的CPU和I/O使用情况,确认MRP0(Managed Recovery Process)进程是否正常运行。如果是因为网络问题导致的传输延迟,可能需要优化网络链路或调整归档传输参数;如果是应用延迟,则需要评估备库的资源分配或考虑升级硬件以应对更高的日志处理压力。

















