








在sql存储过程中批量更新百万级数据,核心做法是分批次提交事务,避免长事务导致锁表、日志膨胀和回滚困难。具体实现时,利用主键或唯一索引进行范围扫描,每次处理固定数量(如1000至5000行)的数据,执行更新后立即提交,然后循环直到所有数据更新完毕。

如何设计分批更新的逻辑结构
分批更新的关键在于确定每批处理的边界。通常使用主键ID的范围来划分批次,例如从最小ID开始,每次选取前N条未更新的数据,更新后记录最后处理的ID,下一轮从该ID之后继续。这种方式能保证不遗漏、不重复,且对索引友好。
-- 假设表名为 large_table,主键为 id
-- 需要更新的字段为 status,目标值为 'processed'

DELIMITER //

CREATE PROCEDURE batch_update_large_data()
BEGIN
    DECLARE v_batch_size INT DEFAULT 1000;
    DECLARE v_rows_affected INT DEFAULT 1;
    DECLARE v_last_id BIGINT DEFAULT 0;

    -- 获取最大ID作为循环终止条件
    SELECT MAX(id) INTO @max_id FROM large_table;

    WHILE v_rows_affected > 0 AND v_last_id < @max_id DO
        -- 每次更新当前批次内,ID大于上次最后ID的记录
        UPDATE large_table
        SET status = 'processed'
        WHERE id > v_last_id
          AND id <= (SELECT MIN(id) FROM (
              SELECT id FROM large_table
              WHERE id > v_last_id
              ORDER BY id ASC
              LIMIT v_batch_size
          ) AS sub);

        -- 获取本次更新影响的行数
        SET v_rows_affected = ROW_COUNT();

        -- 如果更新了数据,更新v_last_id为本次更新的最后一个ID
        IF v_rows_affected > 0 THEN
            SELECT MAX(id) INTO v_last_id
            FROM large_table
            WHERE id > (v_last_id - v_batch_size); -- 近似值,更精确的是取本次更新的MAX(id)
            -- 更精确的做法:直接取本次更新集中的最大ID
            SELECT MAX(id) INTO v_last_id
            FROM large_table
            WHERE status = 'processed'
              AND id <= (SELECT MIN(id) FROM (
                  SELECT id FROM large_table
                  WHERE id > (v_last_id - v_batch_size)
                  ORDER BY id ASC
                  LIMIT v_batch_size
              ) AS sub2);
              -- 注意:上述子查询逻辑在实际中可能复杂,简化版如下:
        END IF;

        -- 提交事务,释放锁和日志空间
        COMMIT;

        -- 可选:短暂休眠,降低数据库负载
        -- DO SLEEP(0.1);
    END WHILE;
END //

DELIMITER ;

-- 调用存储过程
CALL batch_update_large_data();
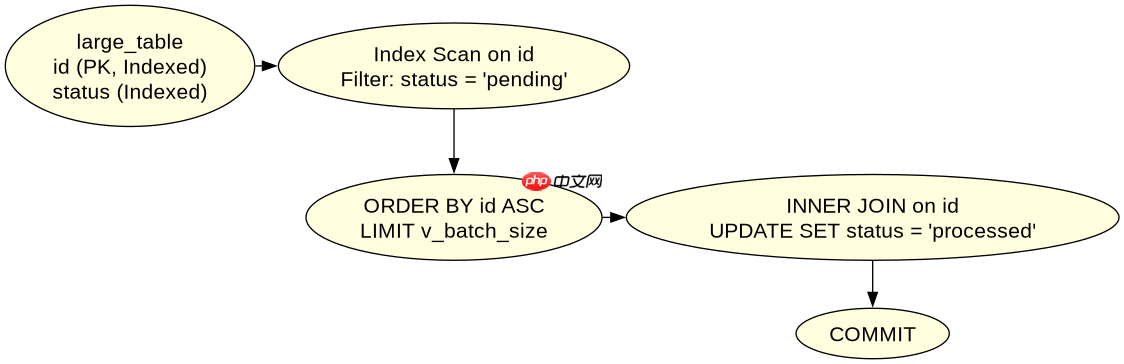
上述代码展示了基本的分批更新框架。实际应用中,需根据表结构和索引情况优化WHERE条件。例如,若status字段有索引,可直接利用它筛选未更新记录。关键点是每次UPDATE后必须COMMIT,否则百万级数据会生成巨大Undo Log,可能导致磁盘写满或事务超时。
如何处理更新过程中的性能与锁问题
批量更新时,锁竞争和I/O压力是主要瓶颈。为减少锁持有时间,每批数据量不宜过大,建议控制在1000-5000行。同时,确保WHERE条件中的列有索引,避免全表扫描。若表上有外键或触发器,更新开销会显著增加,需评估是否可暂时禁用或优化。
-- 优化版:利用索引快速定位未更新记录
-- 假设 status 字段有索引,且初始值为 'pending'

DELIMITER //

CREATE PROCEDURE optimized_batch_update()
BEGIN
    DECLARE v_batch_size INT DEFAULT 2000;
    DECLARE v_done INT DEFAULT 0;

    -- 声明游标用于遍历待更新的主键
    DECLARE cur CURSOR FOR
        SELECT id FROM large_table
        WHERE status = 'pending'
        ORDER BY id ASC
        LIMIT v_batch_size;

    DECLARE CONTINUE HANDLER FOR NOT FOUND SET v_done = 1;

    OPEN cur;

    read_loop: LOOP
        FETCH cur INTO @current_id; -- 这里需要调整,游标一次只取一行,需改为批量获取
        -- 实际上,MySQL游标逐行处理效率低,推荐用JOIN或子查询批量更新

        -- 更高效的批量更新写法:
        UPDATE large_table t1
        INNER JOIN (
            SELECT id FROM large_table
            WHERE status = 'pending'
            ORDER BY id ASC
            LIMIT v_batch_size
        ) t2 ON t1.id = t2.id
        SET t1.status = 'processed';

        -- 检查是否还有更多待更新记录
        IF ROW_COUNT() = 0 THEN
            LEAVE read_loop;
        END IF;

        COMMIT;
    END LOOP;

    CLOSE cur;
END //

DELIMITER ;

CALL optimized_batch_update();
第二种方法通过子查询批量获取待更新ID,再一次性更新,减少了循环次数。但需注意,子查询LIMIT在大表中仍可能较慢,因此确保id上有索引至关重要。此外,若并发写入频繁,需考虑使用乐观锁或版本控制,避免更新冲突。
当某批次更新失败时如何保证数据一致性
在分批更新过程中,若某批次因约束违反、死锁或系统错误而失败,可能导致部分数据已更新、部分未更新,造成数据不一致。为保证一致性,应在存储过程中加入异常处理机制,记录失败批次,并支持重试或回滚到安全点。
-- 增强版:加入异常处理和重试逻辑

DELIMITER //

CREATE PROCEDURE robust_batch_update()
BEGIN
    DECLARE v_batch_size INT DEFAULT 1000;
    DECLARE v_last_id BIGINT DEFAULT 0;
    DECLARE v_max_id BIGINT;
    DECLARE v_error_count INT DEFAULT 0;
    DECLARE v_max_errors INT DEFAULT 5;

    SELECT MAX(id) INTO v_max_id FROM large_table;

    update_loop: LOOP
        BEGIN
            -- 尝试更新当前批次
            UPDATE large_table
            SET status = 'processed'
            WHERE id > v_last_id
              AND id IN (
                  SELECT id FROM (
                      SELECT id FROM large_table
                      WHERE id > v_last_id
                        AND status != 'processed'
                      ORDER BY id ASC
                      LIMIT v_batch_size
                  ) AS temp
              );

            -- 获取本次更新的最后ID
            SELECT MAX(id) INTO v_last_id
            FROM large_table
            WHERE status = 'processed'
              AND id > (v_last_id - v_batch_size);

            -- 提交事务
            COMMIT;

            -- 重置错误计数
            SET v_error_count = 0;

        EXCEPTION WHEN OTHERS THEN
            -- 捕获异常,记录日志(此处简化,实际应插入错误日志表)
            SET v_error_count = v_error_count + 1;
            ROLLBACK;

            IF v_error_count >= v_max_errors THEN
                SIGNAL SQLSTATE '45000'
                    SET MESSAGE_TEXT = 'Too many consecutive errors, aborting';
            END IF;

            -- 可选:等待后重试
            DO SLEEP(1);
        END;

        -- 检查是否完成
        IF v_last_id >= v_max_id OR ROW_COUNT() = 0 THEN
            LEAVE update_loop;
        END IF;
    END LOOP;
END //

DELIMITER ;

CALL robust_batch_update();
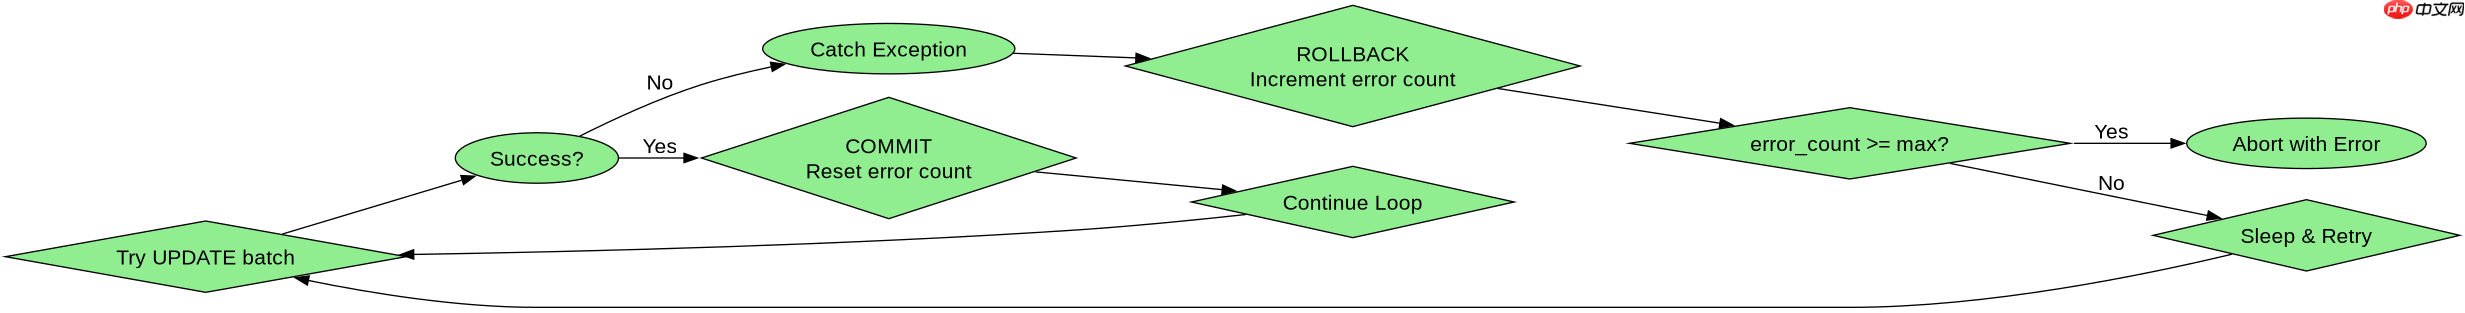
此版本在BEGIN...EXCEPTION块中处理异常,若连续失败超过设定次数则中止。每次失败后回滚事务,防止脏数据累积。实际生产中,建议将错误信息写入专用日志表,便于后续分析和人工干预。同时,定期监控更新进度,可通过查询status='processed'的数量估算完成百分比。


















