








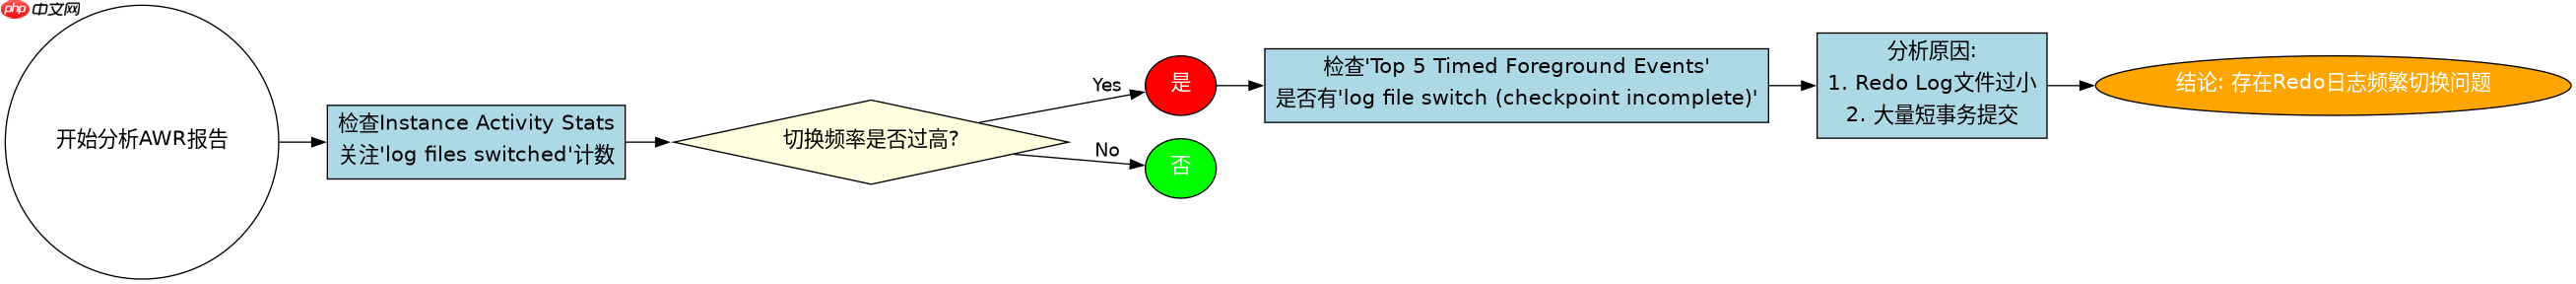
在oracle 12c awr中定位redo日志频繁切换问题,核心是检查awr报告中的“instance activity stats”部分,重点关注“log files switched”这一指标。如果该指标在短时间内出现大量计数,说明发生了频繁的日志切换。这通常由两个原因引起:一是redo log文件设置过小,导致事务量稍大就填满日志;二是存在大量的短事务或批量提交操作,触发了频繁的checkpoint。要解决这个问题,可以通过增大redo log文件大小或调整应用层的提交频率来缓解。
如何识别Redo Log切换频率异常
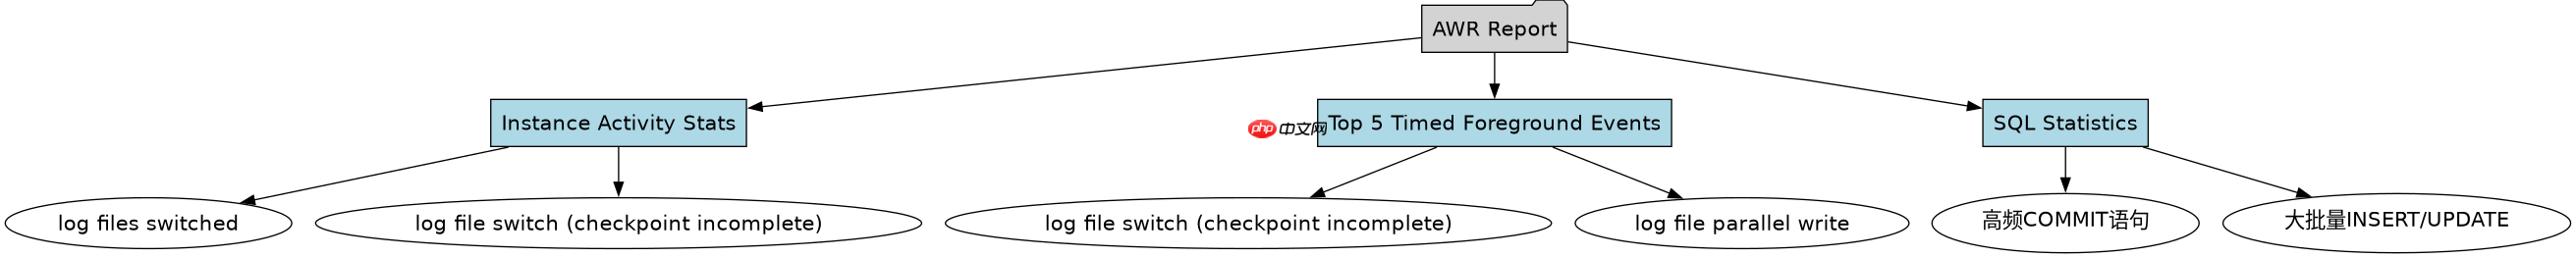
通过查看AWR报告的“Top 5 Timed Foreground Events”和“Instance Activity Stats”,可以确认是否存在日志切换瓶颈。在“Instance Activity Stats”中,找到名为“log file switch (checkpoint incomplete)”或单纯的“log files switched”的事件。如果“log file switch (checkpoint incomplete)”的等待时间(Time)很高,说明因为日志切换导致数据库不得不等待旧的日志文件被归档或清理,这是性能问题的直接信号。同时,对比“DB Time”和“Logical Reads”,如果逻辑读不高但DB Time很高,且日志切换事件排在前列,基本可以确定是日志切换导致的。
SELECT * FROM v$log;
执行上述SQL查询当前Redo Log的状态。重点关注`STATUS`列,如果频繁看到`ACTIVE`状态转为`CURRENT`再转为`INACTIVE`,且`MEMBERS`数量少,说明切换非常频繁。结合AWR中获取的切换间隔时间(例如每5分钟切换一次),如果业务高峰期这个间隔远小于预期(如正常应为30分钟以上),则确认为频繁切换。

如何分析导致频繁切换的具体原因
确定频繁切换后,需要分析是日志太小还是事务太碎。在AWR报告中,查看“SQL Statistics”部分,寻找高频率执行的`COMMIT`语句或大批量插入/更新语句。如果发现有大量的小事务快速提交,会导致Redo生成速度极快,从而迅速填满小的Redo Log文件。此外,检查“Wait Classes”中的“Commit”类等待事件,如果`log file parallel write`等待时间也较高,说明磁盘I/O在处理Redo写入时成为瓶颈,加剧了切换时的延迟。
ALTER SYSTEM SWITCH LOGFILE;
手动触发一次日志切换以测试系统响应。观察切换过程中数据库的停顿时间。如果切换时间过长,说明归档进程(Archiver)跟不上或者磁盘I/O慢。此时应检查操作系统层面的归档目录空间是否充足,以及归档进程的CPU占用情况。如果归档目录满,会导致数据库挂起,这也是日志切换相关的问题之一。
基于Redo Log大小与切换间隔的具体优化方案
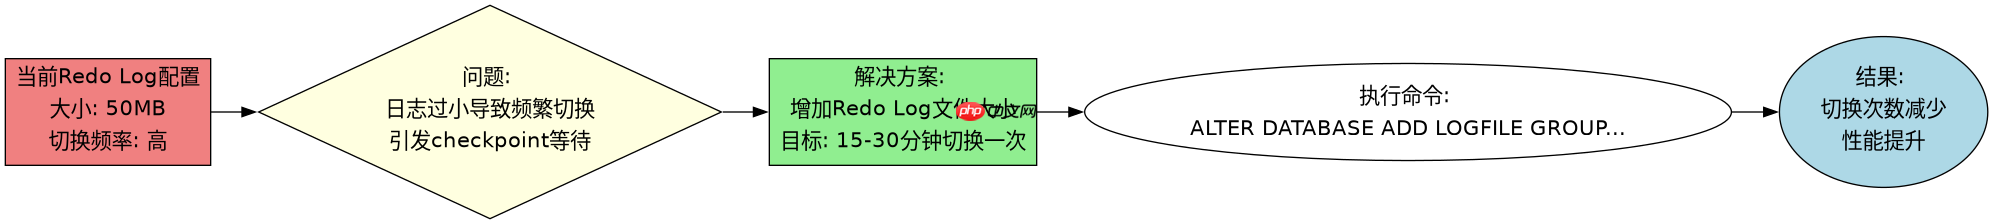
针对定位到的频繁切换问题,最直接有效的办法是增加Redo Log文件的大小。假设当前Redo Log大小为50MB,而业务高峰期每小时产生2GB的Redo数据,那么每小时需要切换40次,这显然是不合理的。建议将Redo Log文件大小调整为至少能支撑15-30分钟的切换周期。例如,如果每小时产生2GB,那么单个日志文件应设置为至少500MB到1GB。通过增加文件大小,可以减少切换次数,降低`log file switch (checkpoint incomplete)`的等待时间,从而提升整体吞吐量。同时,确保Redo Log组数至少为3组,以保证循环使用的连续性。



















